Kim są Kung-Yee Liang i Scott Zeger?
Kung-Yee Liang i Scott L. Zeger to biostatystycy, którzy w 1986 r., jako pracownicy Katedry Biostatystyki Uniwersytetu Johnsa Hopkinsa w Baltimore, ogłosili uogólnione równania estymujące – GEE (Liang i Zeger, 1986).
Liang doktoryzował się z biostatystyki na University of Washington w 1982 r. i przez kolejne 28 lat pracował na Uniwersytecie Johnsa Hopkinsa. Potem przeszedł od badań do kierowania instytucjami na Tajwanie: był szóstym rektorem (prezydentem) National Yang-Ming University, a w 2018 r. został prezesem National Health Research Institutes – rządowego zaplecza eksperckiego, które według uczelnianej notki łączy cechy amerykańskich CDC i NIH. W rozmowie z macierzystą uczelnią opisał GEE jako narzędzie do poprawnego wnioskowania o czynnikach ryzyka z danych zbieranych w czasie (University of Washington School of Public Health, 2018).
Zeger jest profesorem biostatystyki w Szkole Zdrowia Publicznego Johnsa Hopkinsa i w 2017 r. kierował uczelnianą inicjatywą medycyny zindywidualizowanej (Hopkins inHealth). Był współzałożycielem i redaktorem czasopisma „Biostatistics”. Otrzymał m.in. Medal Bradforda Hilla Royal Statistical Society (2007), Nagrodę Marvina Zelena (2007) i Nagrodę Wilksa American Statistical Association (2008), a za dydaktykę – trzykrotnie studencką nagrodę Golden Apple (1988, 2002, 2006). Jest członkiem Institute of Medicine (Duke University Department of Biostatistics and Bioinformatics, 2017).
Najważniejsze pomysły
- GEE (1986). W „Biometrice” Liang i Zeger (1986) rozszerzyli uogólnione modele liniowe na dane podłużne. Badacz podaje model średniej i roboczą macierz korelacji (np. niezależną albo wymienną), a równania dają zgodne oszacowania współczynników i ich wariancji bez określania łącznego rozkładu wszystkich pomiarów osoby. Pomysł wyrasta z quasi-wiarygodności Wedderburna (zob. Nelder i Wedderburn).
- Artykuł bliźniaczy (1986). W „Biometrics” Zeger i Liang (1986) pokazali to samo podejście dla wyników dyskretnych i ciągłych: rozwiązania są zgodne i asymptotycznie normalne nawet przy źle określonej zależności w czasie; podali też zgodny estymator ich wariancji. Ilustracją były dane o wpływie stresu matek na zachorowania dzieci.
- Model brzegowy a warunkowy (1988). Z Paulem Albertem rozróżnili modele uśrednione w populacji, opisujące średnią odpowiedź grupy, i modele dla konkretnej osoby z efektem losowym (Zeger i in., 1988). Ten podział porządkuje wybór opisany we wpisie GEE czy model mieszany?
- Odporna wariancja. Wnioskowanie w GEE opiera się na estymatorze typu „kanapka”, tym samym co w błędach standardowych odpornych na klastrowanie; o korzeniach tego pomysłu w statystyce odpornej piszemy w haśle o Peterze Huberze.
Ciekawostka
Artykuł z „Biometriki” dostał nagrodę prawie 30 lat po publikacji. W 2015 r. Międzynarodowy Instytut Statystyczny (ISI) przyznał Liangowi i Zegerowi Nagrodę Karla Pearsona za pracę, która według uzasadnienia od razu i trwale wpłynęła na teorię i metodologię statystyki i biostatystyki. Nagrodę wręczono 31 lipca 2015 r. na Światowym Kongresie Statystycznym w Rio de Janeiro, a Zeger wygłosił tam wykład Karla Pearsona. Wcześniej, w 2013 r., pierwszą nagrodę dostali Peter McCullagh i John Nelder za książkę o uogólnionych modelach liniowych, na których GEE się opiera (International Statistical Institute, b.d.).
Nagroda nie nosi już tego imienia. ISI uznał, że ze względu na to, iż Karl Pearson aktywnie propagował eugenikę, nie wypada dalej łączyć jego nazwiska z nagrodami i wykładami; dziś jest to „dawna Nagroda Karla Pearsona” (International Statistical Institute, b.d.).
Przykład na prawdziwych danych
Zbiór ohio z pakietu geepack to – według pliku pomocy – podzbiór badania sześciu miast, podłużnego badania zdrowotnych skutków zanieczyszczenia powietrza. Zawiera 537 dzieci z czterema pomiarami (wiek 7, 8, 9 i 10 lat, razem 2148 wierszy): czy dziecko miało świszczący oddech i czy matka paliła w pierwszym roku badania (187 matek). Pomiary jednego dziecka są wyraźnie zależne: świszczący oddech w wieku 10 lat miało 40.0% dzieci, które miały go w wieku 9 lat, i tylko 6.4% pozostałych.
GEE ręcznie. Funkcja gee_recznie() rozwiązuje równania Lianga i Zegera dla regresji logistycznej z wymienną macierzą roboczą: na przemian szacuje korelację pomiarów z reszt Pearsona (ρ = 0.354) i poprawia współczynniki. Po 5 iteracjach współczynniki i odporne błędy standardowe zgadzają się z geepack::geeglm() do czterech miejsc po przecinku.
Co zmienia GEE. Zwykła regresja logistyczna, która traktuje 2148 wierszy jak niezależne osoby, daje dla palenia matki iloraz szans OR = 1.31, 95% CI [1.03; 1.67], p = .028. GEE z macierzą wymienną daje prawie ten sam OR = 1.30, ale odporny błąd standardowy rośnie z 0.124 do 0.178: 95% CI [0.92; 1.85], p = .136. Palenie jest cechą dziecka, a nie pomiaru, więc 4 pomiary nie dają 4 razy więcej informacji. Dla wieku – zmiennej zmieniającej się w obrębie dziecka – jest odwrotnie: błąd maleje z 0.054 do 0.044, a p z .036 do .010 (OR = 0.89 na rok).
Na rysunku
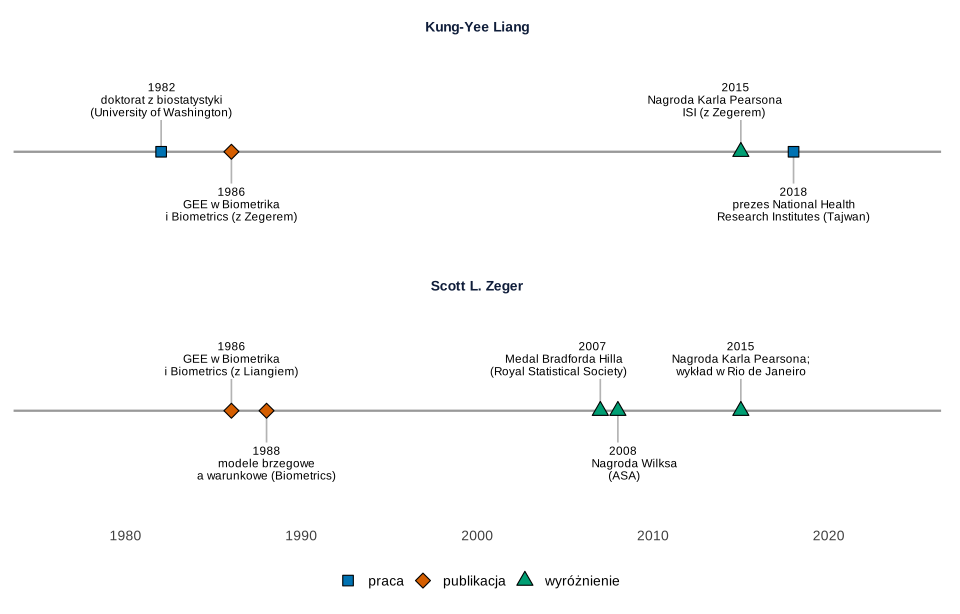
Co widać. Wspólny początek w 1986 r. i wspólna nagroda w 2015 r.; potem Liang kieruje instytucjami na Tajwanie, a Zeger zbiera nagrody za metodologię.
Na co uważać. Cytowane źródła nie podają lat urodzenia ani dat objęcia kolejnych stanowisk na Uniwersytecie Johnsa Hopkinsa, dlatego ich nie pokazujemy.
Podpis do pracy:
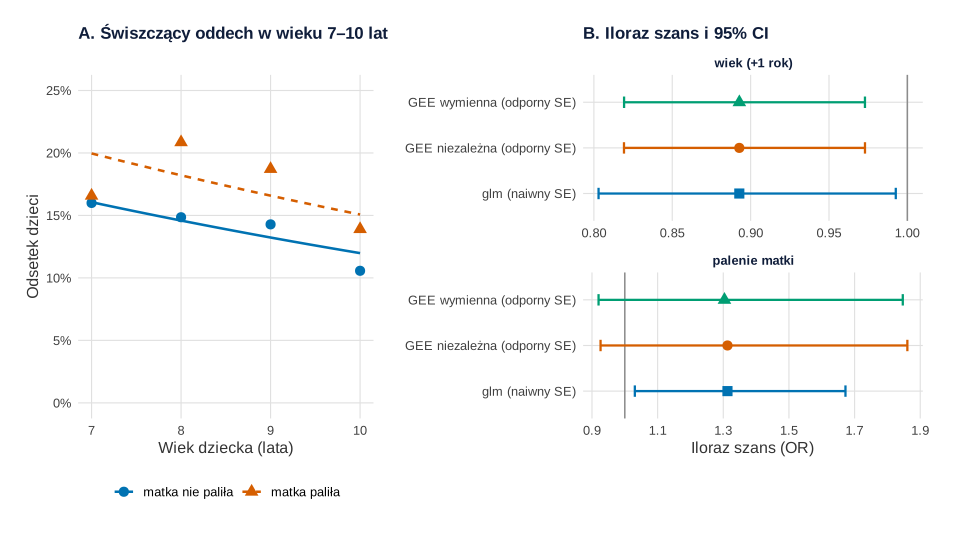
ohio, pakiet geepack): odsetki obserwowane i krzywe brzegowe z GEE z wymienną macierzą roboczą (A) oraz ilorazy szans z 95% CI ze zwykłej regresji logistycznej i z GEE z odpornym błędem standardowym (B). Obliczenia i rysunek: R, pakiety geepack, ggplot2 i patchwork.Co widać. GEE nie zmienia prawie oszacowań, zmienia ich niepewność. Efekt palenia matki, „istotny” w zwykłej regresji, w GEE przestaje nim być; efekt wieku jest oszacowany dokładniej.
Na co uważać. Krzywe w panelu A opisują średni odsetek w populacji dzieci, a nie ryzyko konkretnego dziecka. Model zakłada równoległe linie w skali logitu; interakcji wieku z paleniem nie badaliśmy.
Podpis do pracy:
Gdzie spotkasz Lianga i Zegera w swojej pracy
- Pomiary powtarzane z wynikiem 0/1 lub zliczeniem. Gdy te same osoby mierzysz kilka razy (schemat podłużny), GEE z cytowaniem Lianga i Zegera (1986) jest standardowym wyborem obok modelu wielopoziomowego. Instrukcję dla SPSS opisuje wpis GEE w SPSS.
- Dane klastrowane. Uczniowie w klasach czy pacjenci w oddziałach to ten sam problem; analiza wszystkich wierszy jak niezależnych to pseudoreplikacja.
- Opis wyników. Podaj model średniej, macierz roboczą i to, że błędy są odporne, a ilorazy szans interpretuj jako efekty uśrednione w populacji.
GEE Lianga i Zegera w R
Kod opisuje dane ohio, rozwiązuje równania GEE ręcznie (macierz wymienna i niezależna, odporny błąd „kanapkowy”), porównuje wynik z pakietem geepack i ze zwykłą regresją logistyczną i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje, więc nie ma ziarna.
1. GEE ręcznie i w geepack: rysunek 2
Kod R rysunku 2
# GEE Lianga i Zegera (1986) ręcznie: regresja logistyczna z wymienną macierzą korelacji
# Dane: świszczący oddech u dzieci z Ohio (badanie sześciu miast), pakiet geepack
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(geepack)})
options(width = 100)
kol <- c("#0072B2", "#D55E00", "#009E73")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

data(ohio, package = "geepack")
ohio <- ohio[order(ohio$id, ohio$age), ]
c(dzieci = length(unique(ohio$id)), pomiary = nrow(ohio),
  matki_palace = sum(ohio$smoke[!duplicated(ohio$id)]))
# odsetek dzieci ze świszczącym oddechem: wiek (−2 = 7 lat, 1 = 10 lat) × palenie matki
round(with(ohio, tapply(resp, list(wiek = age + 9, palenie = smoke), mean)), 3)

# Pomiary jednego dziecka są zależne: świszczący oddech w wieku 10 lat a w wieku 9 lat
szer <- reshape(ohio, idvar = "id", timevar = "age", direction = "wide")
round(tapply(szer$resp.1, szer$resp.0, mean), 3)

# 1. Zwykła regresja logistyczna: 2148 wierszy traktowanych jak niezależne
m_glm <- glm(resp ~ age + smoke, family = binomial, data = ohio)

# 2. GEE ręcznie (Liang i Zeger, 1986): równania estymujące
#    suma_i D_i' V_i^(-1) (y_i − mu_i) = 0,  V_i = A_i^(1/2) R(rho) A_i^(1/2),  A_i = diag(mu(1 − mu))
X <- model.matrix(~ age + smoke, data = ohio); y <- ohio$resp
grupy <- split(seq_len(nrow(ohio)), ohio$id)
gee_recznie <- function(X, y, grupy, wymienna = TRUE, iter = 50) {
  beta <- coef(glm.fit(X, y, family = binomial()))   # start: zwykły logit
  p <- ncol(X)
  for (k in seq_len(iter)) {
    mu <- plogis(drop(X %*% beta))
    r <- (y - mu) / sqrt(mu * (1 - mu))                # reszty Pearsona
    # rho: średni iloczyn reszt różnych pomiarów tego samego dziecka (estymator momentów)
    licznik <- 0; pary <- 0
    for (g in grupy) {
      licznik <- licznik + (sum(r[g])^2 - sum(r[g]^2)) / 2
      pary <- pary + length(g) * (length(g) - 1) / 2
    }
    rho <- if (wymienna) licznik / (pary - p) else 0
    B <- matrix(0, p, p); U <- numeric(p); M <- matrix(0, p, p)
    for (g in grupy) {
      n <- length(g); a <- sqrt(mu[g] * (1 - mu[g]))
      R <- matrix(rho, n, n); diag(R) <- 1
      Vinv <- solve(diag(a, n) %*% R %*% diag(a, n))
      D <- X[g, , drop = FALSE] * (mu[g] * (1 - mu[g]))   # pochodna mu po beta
      u <- t(D) %*% Vinv %*% (y[g] - mu[g])
      B <- B + t(D) %*% Vinv %*% D; U <- U + u; M <- M + u %*% t(u)
    }
    krok <- solve(B, U); beta <- beta + drop(krok)
    if (max(abs(krok)) < 1e-10) break
  }
  Binv <- solve(B)
  list(beta = beta, rho = rho, iteracje = k,
       se_modelowy = sqrt(diag(Binv)),                  # gdyby macierz robocza była prawdziwa
       se_odporny = sqrt(diag(Binv %*% M %*% Binv)))    # „kanapka”: B^(-1) M B^(-1)
}
wym <- gee_recznie(X, y, grupy, wymienna = TRUE)
nzl <- gee_recznie(X, y, grupy, wymienna = FALSE)
c(rho = round(wym$rho, 4), iteracje = wym$iteracje)

# 3. To samo w pakiecie geepack (wymienna macierz robocza, skala ustalona na 1)
m_gee <- geeglm(resp ~ age + smoke, id = id, data = ohio, family = binomial,
                corstr = "exchangeable", scale.fix = TRUE)
round(cbind(recznie = wym$beta, geepack = coef(m_gee),
            SE_recznie = wym$se_odporny, SE_geepack = summary(m_gee)$coefficients[, "Std.err"]), 4)

# 4. Porównanie błędów standardowych
porown <- data.frame(
  metoda = rep(c("glm (naiwny SE)", "GEE niezależna (odporny SE)", "GEE wymienna (odporny SE)"), each = 3),
  wspolczynnik = rep(colnames(X), 3),
  b = c(coef(m_glm), nzl$beta, wym$beta),
  se = c(sqrt(diag(vcov(m_glm))), nzl$se_odporny, wym$se_odporny))
porown$p <- 2 * pnorm(-abs(porown$b / porown$se))
porown$OR <- exp(porown$b)
porown$dolna <- exp(porown$b - 1.96 * porown$se); porown$gorna <- exp(porown$b + 1.96 * porown$se)
print(porown[porown$wspolczynnik != "(Intercept)", ], digits = 3, row.names = FALSE)
round(c(SE_modelowy_wymienna = wym$se_modelowy[2:3]), 4)

# Rysunek: A – odsetki obserwowane i krzywe brzegowe z GEE; B – ilorazy szans z 95% CI
obs <- aggregate(resp ~ age + smoke, data = ohio, FUN = mean)
obs$palenie <- factor(obs$smoke, 0:1, c("matka nie paliła", "matka paliła"))
siatka <- expand.grid(age = seq(-2, 1, by = 0.05), smoke = 0:1)
siatka$p <- plogis(drop(model.matrix(~ age + smoke, siatka) %*% wym$beta))
siatka$palenie <- factor(siatka$smoke, 0:1, levels(obs$palenie))
pA <- ggplot(obs, aes(age + 9, resp, colour = palenie, shape = palenie)) +
  geom_line(data = siatka, aes(y = p, linetype = palenie), linewidth = 0.9) +
  geom_point(size = 3.2) +
  scale_colour_manual(values = kol[1:2], name = NULL) + scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "22"), name = NULL) +
  scale_y_continuous(limits = c(0, 0.25), labels = function(v) paste0(100 * v, "%")) +
  labs(title = "A. Świszczący oddech w wieku 7–10 lat", x = "Wiek dziecka (lata)",
       y = "Odsetek dzieci") + motyw
dB <- porown[porown$wspolczynnik != "(Intercept)", ]
dB$wspolczynnik <- factor(dB$wspolczynnik, c("age", "smoke"), c("wiek (+1 rok)", "palenie matki"))
dB$metoda <- factor(dB$metoda, unique(porown$metoda))
pB <- ggplot(dB, aes(OR, metoda, colour = metoda, shape = metoda)) +
  geom_vline(xintercept = 1, colour = "grey55") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, linewidth = 0.8, orientation = "y") +
  geom_point(size = 3.2) +
  facet_wrap(~ wspolczynnik, ncol = 1, scales = "free_x") +
  scale_colour_manual(values = kol, guide = "none") + scale_shape_manual(values = c(15, 16, 17), guide = "none") +
  labs(title = "B. Iloraz szans i 95% CI", x = "Iloraz szans (OR)", y = NULL) + motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.15))
p2
Wynik w R
      dzieci      pomiary matki_palace
         537         2148          187
    palenie
wiek     0     1
  7  0.160 0.166
  8  0.149 0.209
  9  0.143 0.187
  10 0.106 0.139
    0     1
0.064 0.400
     rho iteracje
  0.3541   5.0000
            recznie geepack SE_recznie SE_geepack
(Intercept) -1.8804 -1.8804     0.1139     0.1139
age         -0.1134 -0.1134     0.0439     0.0439
smoke        0.2651  0.2651     0.1777     0.1777
                      metoda wspolczynnik      b     se       p    OR dolna gorna
             glm (naiwny SE)          age -0.113 0.0541 0.03599 0.893 0.803 0.993
             glm (naiwny SE)        smoke  0.272 0.1235 0.02752 1.313 1.031 1.672
 GEE niezależna (odporny SE)          age -0.113 0.0439 0.00974 0.893 0.819 0.973
 GEE niezależna (odporny SE)        smoke  0.272 0.1780 0.12626 1.313 0.926 1.861
   GEE wymienna (odporny SE)          age -0.113 0.0439 0.00973 0.893 0.819 0.973
   GEE wymienna (odporny SE)        smoke  0.265 0.1777 0.13587 1.304 0.920 1.847
  SE_modelowy_wymienna.age SE_modelowy_wymienna.smoke
                    0.0435                     0.1770
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Kung-Yee Liang i Scott L. Zeger – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1982, 1986, 2015, 2018,
          1986, 1988, 2007, 2008, 2015),
  osoba = c(rep("Kung-Yee Liang", 4), rep("Scott L. Zeger", 5)),
  opis = c("doktorat z biostatystyki\n(University of Washington)", "GEE w Biometrika\ni Biometrics (z Zegerem)",
           "Nagroda Karla Pearsona\nISI (z Zegerem)", "prezes National Health\nResearch Institutes (Tajwan)",
           "GEE w Biometrika\ni Biometrics (z Liangiem)", "modele brzegowe\na warunkowe (Biometrics)",
           "Medal Bradforda Hilla\n(Royal Statistical Society)", "Nagroda Wilksa\n(ASA)", "Nagroda Karla Pearsona;\nwykład w Rio de Janeiro"),
  rodzaj = c("praca", "publikacja", "wyróżnienie", "praca",
             "publikacja", "publikacja", "wyróżnienie", "wyróżnienie", "wyróżnienie"),
  poziom = c(0.5, -0.5, 0.5, -0.5,
             0.5, -0.5, 0.5, -0.5, 0.5),          # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 0.7, 0.5,
                 0.5, 0.5, 0.8, 0.3, 0.5))        # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
zdarzenia$osoba <- factor(zdarzenia$osoba, levels = c("Kung-Yee Liang", "Scott L. Zeger"))
ksztalty <- c("praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  facet_wrap(~ osoba, ncol = 1) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1976, 2024), breaks = seq(1980, 2020, by = 10)) +
  scale_y_continuous(limits = c(-1.6, 1.6)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        strip.text = element_text(face = "bold", hjust = 0), legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (regresja logistyczna – glm() i glm.fit() z pakietu stats; GEE – geeglm() z pakietu geepack; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- geepack (wersja 1.3.13): Højsgaard, S., Halekoh, U., & Yan, J. (2006). The R package geepack for generalized estimating equations. Journal of Statistical Software, 15(2), 1–11. https://doi.org/10.18637/jss.v015.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim są Kung-Yee Liang i Scott Zeger?
Biostatystykami, twórcami GEE (1986). Liang doktoryzował się na University of Washington (1982), 28 lat pracował na Uniwersytecie Johnsa Hopkinsa, a potem kierował uczelnią i instytutem badawczym na Tajwanie. Zeger jest profesorem biostatystyki na Uniwersytecie Johnsa Hopkinsa i współzałożycielem czasopisma „Biostatistics”.
W którym artykule Liang i Zeger wprowadzili GEE?
W pracy „Longitudinal data analysis using generalized linear models” w „Biometrice” (1986, t. 73, s. 13–22) i w bliźniaczym artykule w „Biometrics” z tego samego roku. Pierwszy z nich ISI nagrodził w 2015 r.
Czy w GEE trzeba trafnie wybrać macierz korelacji?
Nie, żeby dostać zgodne oszacowania i poprawne odporne błędy – to główna zaleta metody. Trafniejsza macierz robocza daje jednak dokładniejsze oszacowania. W danych ohio wymienna macierz i macierz niezależności dały prawie te same wyniki.
Dlaczego w GEE błąd standardowy palenia matki wzrósł?
Bo palenie jest cechą dziecka, a nie pomiaru: cztery skorelowane pomiary nie zastępują czterech dzieci. Zwykła regresja logistyczna dała SE = 0.124 i p = .028, GEE – SE = 0.178 i p = .136.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
GEE czy model mieszany?
Efekty brzegowe a warunkowe, robocza macierz korelacji, błąd kanapkowy i CR2, braki MCAR i MAR oraz QIC – na jednym przykładzie w R.
Czytaj →PoradnikGEE w SPSS krok po kroku
Generalized Estimating Equations od pliku .sav po opis APA: zakładka Repeated, macierz robocza i QIC, pułapka kategorii odniesienia, estymator odporny, exp(B), EM Means i składnia GENLIN.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Duke University Department of Biostatistics and Bioinformatics. (2017). Distinguished speaker Scott Zeger, PhD offers insight and experience. Duke Biostatistics & Bioinformatics News. https://biostat.duke.edu/news/distinguished-speaker-scott-zeger-phd-offers-insight-and-experience ● Otwarty dostęp
- International Statistical Institute. (b.d.). Former Karl Pearson Prize. isi-web.org. Pobrano 22 listopada 2026 z https://isi-web.org/former-karl-pearson-prize ● Otwarty dostęp
- Liang, K.-Y., & Zeger, S. L. (1986). Longitudinal data analysis using generalized linear models. Biometrika, 73(1), 13–22. https://doi.org/10.1093/biomet/73.1.13
- University of Washington School of Public Health. (2018). Alumni Q&A: Kung-Yee Liang makes it to the top in Taiwan. UW School of Public Health News. https://sph.washington.edu/news-events/news/alumni-qa-kung-yee-liang-makes-it-top-taiwan ● Otwarty dostęp
- Zeger, S. L., & Liang, K.-Y. (1986). Longitudinal data analysis for discrete and continuous outcomes. Biometrics, 42(1), 121–130. https://doi.org/10.2307/2531248
- Zeger, S. L., Liang, K.-Y., & Albert, P. S. (1988). Models for longitudinal data: A generalized estimating equation approach. Biometrics, 44(4), 1049–1060. https://doi.org/10.2307/2531734
Cytowania BibTeX
@misc{duke2017zeger, author={{Duke University Department of Biostatistics and Bioinformatics}}, title={{Distinguished speaker Scott Zeger, PhD offers insight and experience}}, howpublished={Duke Biostatistics \& Bioinformatics News}, year={2017}, url={https://biostat.duke.edu/news/distinguished-speaker-scott-zeger-phd-offers-insight-and-experience}}@misc{isikarlpearsonprize, author={{International Statistical Institute}}, title={{Former Karl Pearson Prize}}, howpublished={isi-web.org}, url={https://isi-web.org/former-karl-pearson-prize}}@article{liang1986longitudinal, author={Liang, Kung-Yee and Zeger, Scott L.}, title={{Longitudinal data analysis using generalized linear models}}, journal={Biometrika}, year={1986}, volume={73}, number={1}, pages={13--22}, doi={10.1093/biomet/73.1.13}}@misc{uwsph2018liang, author={{University of Washington School of Public Health}}, title={{Alumni Q\&A: Kung-Yee Liang makes it to the top in Taiwan}}, howpublished={UW School of Public Health News}, year={2018}, url={https://sph.washington.edu/news-events/news/alumni-qa-kung-yee-liang-makes-it-top-taiwan}}@article{zeger1986longitudinal, author={Zeger, Scott L. and Liang, Kung-Yee}, title={{Longitudinal data analysis for discrete and continuous outcomes}}, journal={Biometrics}, year={1986}, volume={42}, number={1}, pages={121--130}, doi={10.2307/2531248}}@article{zeger1988models, author={Zeger, Scott L. and Liang, Kung-Yee and Albert, Paul S.}, title={{Models for longitudinal data: A generalized estimating equation approach}}, journal={Biometrics}, year={1988}, volume={44}, number={4}, pages={1049--1060}, doi={10.2307/2531734}}