Kim był Herbert Robbins?
Herbert Ellis Robbins (1915–2001) był amerykańskim matematykiem, który trafił do statystyki przypadkiem, a w latach 1951–1956 dał jej kilka zupełnie nowych pomysłów. Urodził się 12 stycznia 1915 r. w New Castle w Pensylwanii. W 1931 r., mając 16 lat, wstąpił na Harvard; do tej pory interesował się głównie literaturą, ale rozmowy z Marstonem Morse’em przyciągnęły go do matematyki. Doktorat z topologii kombinatorycznej obronił w 1938 r. (Lai i Siegmund, 1986, 2018).
Po roku w Institute for Advanced Study w Princeton i trzech latach na New York University stał się znany jako współautor, z Richardem Courantem, książki What Is Mathematics? (1941). W tym samym roku wstąpił do marynarki wojennej USA i po czterech latach odszedł z niej w stopniu komandora porucznika. Od 1946 r. uczył w Chapel Hill, a od 1953 r. był profesorem i kierownikiem katedry statystyki matematycznej Uniwersytetu Columbia, gdzie – z przerwą na lata 1965–1968 – pracował do emerytury w wieku 70 lat. W latach 1965–1966 był prezesem Institute of Mathematical Statistics, a w 1974 r. został członkiem National Academy of Sciences. Zmarł 12 lutego 2001 r. (Lai i Siegmund, 2018).
Najważniejsze pomysły
- Aproksymacja stochastyczna (1951). Z Suttonem Monro opisał, jak znaleźć poziom x, przy którym nieznana, rosnąca funkcja odpowiedzi osiąga zadaną wartość – na przykład dawkę, po której reaguje połowa badanych. Kolejne próby prowadzi się na poziomach x1, x2, … dobieranych na podstawie dotychczasowych wyników, a xn zbliża się do szukanej wartości (Robbins i Monro, 1951). Lai (2003) podkreśla, że z tej pracy wyrosła cała dziedzina ważna w optymalizacji, sterowaniu i przetwarzaniu sygnałów.
- Sekwencyjne planowanie eksperymentów (1952). Robbins wyszedł od sekwencyjnego testu Abrahama Walda, w którym liczebność próby zależy od danych, i poszedł dalej: od obserwacji może zależeć także to, z której populacji pobierasz kolejną próbę (Robbins, 1952). Tak postawił problem dwurękiego bandyty – jak dzielić kolejne próby między dwie opcje, żeby zebrać jak najwięcej „wygranych”.
- Eksploracja kontra eksploatacja. Jego reguła z 1952 r. wybiera opcję, która dotąd wypada lepiej, ale w rzadkich, z góry ustalonych momentach sprawdza tę rzadziej wybieraną. Lai i Siegmund (2018) pokazują, jak z tego wyrosła teoria wielorękich bandytów, a dalej reguła UCB i dzisiejsze systemy rekomendacji.
Ciekawostka
„Nic nie wiem o statystyce”. W 1946 r. Harold Hotelling tworzył w Chapel Hill wydział statystyki matematycznej. Przeczytał dwie prace Robbinsa z prawdopodobieństwa geometrycznego i zadzwonił do niego z propozycją stanowiska profesora nadzwyczajnego. Zaskoczony Robbins odpowiedział, że nic nie wie o statystyce, więc to chyba nie jego szukają, i zaproponował, że odszuka w spisie członków American Mathematical Society „właściwego” Robbinsa. Hotelling upierał się, że nie ma pomyłki: chodziło o uczenie doktorantów teorii miary, prawdopodobieństwa i metod analizy. Robbins przyjął posadę i spędził w Chapel Hill sześć lat (Lai i Siegmund, 2018, za wywiadem z 1984 r.).
Także prace, które zwróciły uwagę Hotellinga, zaczęły się od przypadku. W czasie wojny Robbins usłyszał rozmowę dwóch wyższych oficerów marynarki o losowym rozrzucie trafień bomb. Bez odpowiedniego poświadczenia bezpieczeństwa nie mógł się wtedy zająć ich problemem, ale z rozmyślań nad nim powstały jego artykuły z 1944 i 1945 r. (Lai i Siegmund, 1986, 2018).
Przykład: szukanie dawki metodą Robbinsa–Monro
Dane są symulowane. Prawdopodobieństwo reakcji na dawkę x opisuje krzywa logistyczna z dawką skuteczną u połowy osób ED50 = 5 (jak w regresji logistycznej); eksperymentator tej krzywej nie zna. Każda kolejna osoba dostaje dawkę xn i reaguje (y = 1) albo nie (y = 0), a następną dawkę liczymy jako xn+1 = xn − (c/n)(yn − 0.5). Po reakcji dawka maleje, po jej braku rośnie, a kroki są coraz mniejsze. ED50, nachylenie krzywej, dawkę startową 2 i stałą kroku c dobraliśmy ręcznie.
W jednym przebiegu przy c = 4 pierwsze dawki to 2.00, 4.00, 5.00, 5.67, 5.17 i 4.77, a po 100 osobach szacunek ED50 wynosi 5.02. W 1000 przebiegach pierwiastek błędu średniokwadratowego (RMSE) spada z 0.72 po 10 osobach do 0.43 po 25, 0.29 po 50 i 0.21 po 100. Przy c = 1 kroki są za małe: po 100 osobach średni szacunek to dopiero 3.90, a RMSE 1.12. Przy c = 16 dawki na początku za mocno skaczą (RMSE 1.03 po 10 osobach), a po 100 osobach RMSE wynosi 0.30.
Dla porównania: plan stały, w którym po 14 osób dostaje każdą z dawek 2, 3, …, 8 (razem 98), a ED50 szacujemy regresją logistyczną, daje RMSE 0.27, metoda Robbinsa–Monro po 98 osobach – 0.21. Plan stały miał tu ułatwione zadanie, bo dawki leżały symetrycznie wokół prawdziwej ED50; w prawdziwym badaniu tego nie wiesz.
Na rysunku
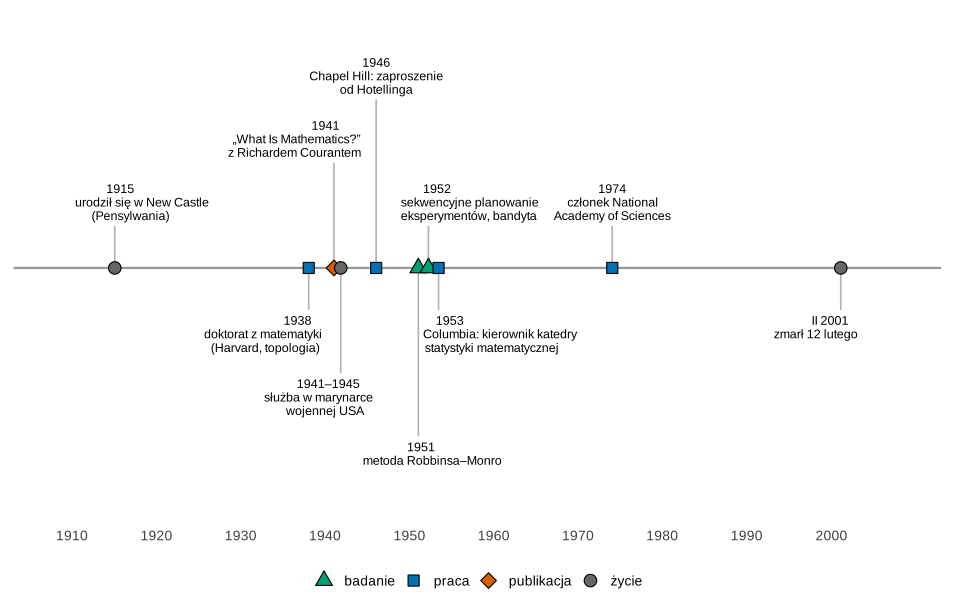
Co widać. Trzy prace, z których Robbins jest dziś najbardziej znany w statystyce, powstały w ciągu kilku lat po tym, jak w wieku ponad 30 lat zaczął zajmować się tą dziedziną.
Na co uważać. Oś pokazuje tylko wybrane zdarzenia, np. bez lat 1965–1968 spędzonych poza Columbią.
Podpis do pracy:
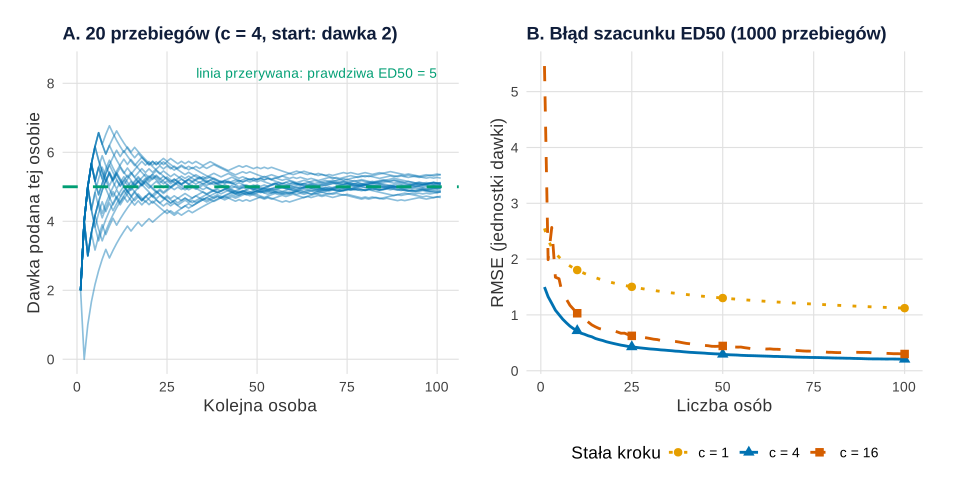
set.seed(9150) i set.seed(9152)).Co widać. Ścieżki zaczynają od dawki 2, w pierwszych krokach przeskakują daleko w obie strony, a potem coraz ciaśniej skupiają się wokół 5 (A). Przy c = 1 szacunek przez całe 100 osób nie dochodzi do prawdy, przy c = 16 długo „rozkołysuje się” po pierwszych skokach (B).
Na co uważać. Dobra stała c zależy od nachylenia nieznanej krzywej, więc w prawdziwym badaniu jej nie znasz – tu sprawdziliśmy ją w symulacji. Pierwsze kroki są duże: w jednej ścieżce dawka spadła po pierwszej osobie do 0, czyli poza sensowny zakres. W badaniu z udziałem ludzi wyznacza się więc granice dawek.
Podpis do pracy:
Gdzie spotkasz Robbinsa w swojej pracy
- Badania dawki i progu. Gdy szukasz dawki, natężenia bodźca albo trudności zadania, przy której odpowiada połowa osób, możesz dobierać kolejne poziomy na podstawie dotychczasowych odpowiedzi zamiast stałej siatki – tło daje hasło o zależności dawka–odpowiedź i regresji probitowej.
- Testy A/B i bandyty. Problem Robbinsa to dziś codzienność w e-commerce: wpis wielorękie bandyty a test A/B pokazuje koszt i zysk przesuwania ruchu w trakcie testu A/B, a wpis o sekwencyjnym teście A/B – granice zatrzymania.
- Badania sekwencyjne. Decyzje podejmowane w trakcie zbierania danych opisuje wpis analizy pośrednie w praktyce.
- Symulacje. Porównanie stałych c w przykładzie to małe badanie symulacyjne; jak je zaplanować i opisać, pokazuje wpis jak zaplanować badanie symulacyjne.
Na tym samym wydziale w Chapel Hill od 1949 r. pracował Raj Chandra Bose, twórca planów w blokach niekompletnych.
Metoda Robbinsa–Monro w R
Kod symuluje szukanie dawki ED50 metodą Robbinsa–Monro: jeden przebieg, 1000 przebiegów dla trzech stałych kroku i porównanie z planem stałym z regresją logistyczną, a na końcu rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Każdy losujący blok ma własne set.seed(); ziarna ustaliliśmy raz i nie zmienialiśmy.
1. Robbins–Monro: rysunek 2
Kod R rysunku 2
# Herbert Robbins: aproksymacja stochastyczna Robbinsa–Monro (1951) – szukanie dawki ED50 (dane symulowane)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(c1 = "#E69F00", c4 = "#0072B2", c16 = "#D55E00", prawda = "#009E73")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# Model, którego eksperymentator nie zna: P(odpowiedź | dawka x) = plogis((x - 5) / 1), więc ED50 = theta = 5
theta <- 5
p_odp <- function(x) plogis((x - theta) / 1)
# Algorytm Robbinsa–Monro: x[n+1] = x[n] - a_n * (y_n - 0.5), krok a_n = c / n; start x1 = 2
robbins_monro <- function(n_prob, c, x1 = 2) {
  x <- numeric(n_prob + 1); x[1] <- x1
  for (n in 1:n_prob) {
    y <- rbinom(1, 1, p_odp(x[n]))        # jedna osoba, odpowiedź 0/1
    x[n + 1] <- x[n] - (c / n) * (y - 0.5)
  }
  x
}

# 1. Jeden przebieg: 100 osób, c = 4
set.seed(915)
x <- robbins_monro(100, c = 4)
setNames(round(x[c(1:6, 11, 26, 51, 101)], 2), c(paste0("osoba_", 1:6), "osoba_11", "osoba_26", "osoba_51", "po_100"))

# 2. Symulacja: 1000 przebiegów dla trzech stałych c; błąd szacunku ED50 po n osobach
set.seed(9150)
n_max <- 100; R <- 1000
sciezki <- lapply(c(1, 4, 16), function(c) t(replicate(R, robbins_monro(n_max, c))))
names(sciezki) <- c("c = 1", "c = 4", "c = 16")
rmse <- sapply(sciezki, function(m) sqrt(colMeans((m[, -1] - theta)^2)))   # kolumna n = szacunek po n osobach
rownames(rmse) <- paste0("po_", 1:n_max, "_osobach")
round(rmse[c(10, 25, 50, 100), ], 2)
round(sapply(sciezki, function(m) mean(m[, n_max + 1])), 2)                # średni szacunek po 100 osobach

# 3. Dla porównania plan stały: 98 osób, po 14 na dawki 2, 3, ..., 8, ED50 z regresji logistycznej
set.seed(9151)
dawki <- rep(2:8, each = 14)
ed50_staly <- replicate(R, {
  y <- rbinom(length(dawki), 1, p_odp(dawki))
  b <- coef(glm(y ~ dawki, family = binomial))
  -b[[1]] / b[[2]]
})
round(c(RMSE_plan_staly = sqrt(mean((ed50_staly - theta)^2)), RMSE_RM_c4_po_98 = rmse[98, "c = 4"]), 2)

# Rysunek 2A: 20 przebiegów algorytmu przy c = 4
set.seed(9152)
pA_dane <- do.call(rbind, lapply(1:20, function(k) data.frame(przebieg = k, osoba = 1:101, dawka = robbins_monro(100, c = 4))))
pA <- ggplot(pA_dane, aes(osoba, dawka, group = przebieg)) +
  geom_line(colour = kol[["c4"]], alpha = 0.45) +
  geom_hline(yintercept = theta, colour = kol[["prawda"]], linewidth = 1, linetype = "dashed") +
  annotate("text", x = 100, y = 8.3, label = "linia przerywana: prawdziwa ED50 = 5", hjust = 1, colour = kol[["prawda"]], size = 3.6) +
  scale_y_continuous(limits = c(0, 8.5), breaks = seq(0, 8, 2)) +
  labs(title = "A. 20 przebiegów (c = 4, start: dawka 2)", x = "Kolejna osoba", y = "Dawka podana tej osobie") +
  motyw
# Rysunek 2B: pierwiastek błędu średniokwadratowego w 1000 przebiegach
pB_dane <- data.frame(osoba = rep(1:n_max, 3), rmse = c(rmse), c = factor(rep(colnames(rmse), each = n_max), levels = colnames(rmse)))
pB <- ggplot(pB_dane, aes(osoba, rmse, colour = c, linetype = c)) +
  geom_line(linewidth = 1) +
  geom_point(data = subset(pB_dane, osoba %in% c(10, 25, 50, 100)), aes(shape = c), size = 2.6) +
  scale_colour_manual(values = unname(kol[c("c1", "c4", "c16")]), name = "Stała kroku") +
  scale_linetype_manual(values = c("dotted", "solid", "dashed"), name = "Stała kroku") +
  scale_shape_manual(values = c(16, 17, 15), name = "Stała kroku") +
  labs(title = "B. Błąd szacunku ED50 (1000 przebiegów)", x = "Liczba osób", y = "RMSE (jednostki dawki)") +
  motyw
p2 <- pA + pB
p2
Wynik w R
 osoba_1  osoba_2  osoba_3  osoba_4  osoba_5  osoba_6 osoba_11 osoba_26
    2.00     4.00     5.00     5.67     5.17     4.77     5.04     5.09
osoba_51   po_100
    5.17     5.02
               c = 1 c = 4 c = 16
po_10_osobach   1.80  0.72   1.03
po_25_osobach   1.50  0.43   0.63
po_50_osobach   1.30  0.29   0.44
po_100_osobach  1.12  0.21   0.30
 c = 1  c = 4 c = 16
  3.90   4.98   5.01
 RMSE_plan_staly RMSE_RM_c4_po_98
            0.27             0.21
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Herbert Robbins, 1915–2001 – daty według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1915, 1938, 1941, 1941.8, 1946, 1951, 1952.2, 1953.4, 1974, 2001.1),
  etykieta = c("1915", "1938", "1941", "1941–1945", "1946", "1951", "1952", "1953", "1974", "II 2001"),
  opis = c("urodził się w New Castle\n(Pensylwania)", "doktorat z matematyki\n(Harvard, topologia)", "„What Is Mathematics?”\nz Richardem Courantem",
           "służba w marynarce\nwojennej USA", "Chapel Hill: zaproszenie\nod Hotellinga", "metoda Robbinsa–Monro",
           "sekwencyjne planowanie\neksperymentów, bandyta", "Columbia: kierownik katedry\nstatystyki matematycznej",
           "członek National\nAcademy of Sciences", "zmarł 12 lutego"),
  rodzaj = c("życie", "praca", "publikacja", "życie", "praca", "badanie", "badanie", "praca", "praca", "życie"))
# Gęste lata 1938–1953: etykiety nad (1) i pod (−1) osią, na trzech wysokościach
zdarzenia$strona     <- c(1, -1, 1, -1, 1, -1, 1, -1, 1, -1)
zdarzenia$poziom     <- c(0.5, 0.5, 1.25, 1.25, 2.0, 2.0, 0.5, 0.5, 0.5, 0.5)
zdarzenia$wyrownanie <- c(0.3, 0.9, 0.8, 0.7, 0.5, 0.4, 0.2, 0.1, 0.5, 0.8)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "badanie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "badanie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom * strona), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 4, colour = "black") +
  geom_text(aes(y = (poziom + 0.07) * strona, label = paste0(etykieta, "\n", opis), vjust = ifelse(strona > 0, 0, 1), hjust = wyrownanie),
            size = 3.3, lineheight = 0.9) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1908, 2008), breaks = seq(1910, 2000, by = 10)) +
  scale_y_continuous(limits = c(-2.75, 2.75)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie – rbinom(), regresja logistyczna – glm() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Herbert Robbins?
Amerykańskim matematykiem i statystykiem (1915–2001), doktorem Harvardu, współautorem z Courantem książki „What Is Mathematics?” (1941), a od 1953 r. profesorem i kierownikiem katedry statystyki matematycznej Uniwersytetu Columbia (Lai i Siegmund, 2018).
Na czym polega metoda Robbinsa–Monro?
Szuka poziomu x, przy którym nieznana, monotoniczna funkcja odpowiedzi osiąga zadaną wartość, np. dawki skutecznej u połowy osób. Kolejny poziom wylicza z poprzedniego i ostatniej odpowiedzi, z coraz mniejszymi krokami, tak że kolejne poziomy zbliżają się do szukanej wartości (Robbins i Monro, 1951).
Co Robbins ma wspólnego z wielorękimi bandytami i testami A/B?
W 1952 r. postawił problem dwurękiego bandyty: jak dzielić kolejne próby między dwie opcje, by zebrać jak najwięcej wygranych (Robbins, 1952). Z tego wyrosła teoria bandytów używana dziś m.in. w rekomendacjach i testach A/B (Lai i Siegmund, 2018).
Jak Herbert Robbins trafił do statystyki?
Przez przypadek: w czasie wojny zasłyszał rozmowę oficerów o rozrzucie trafień bomb i napisał prace z prawdopodobieństwa geometrycznego. Po ich lekturze Hotelling zaproponował mu w 1946 r. stanowisko w Chapel Hill, choć Robbins twierdził, że nic nie wie o statystyce (Lai i Siegmund, 2018).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wielorękie bandyty a test A/B
Portal z przepisami i cztery nagłówki: test A/B, strategia epsilon-zachłanna i UCB1 w 1000 symulacjach – utracone kliknięcia, trafność i obciążone średnie.
Czytaj →PoradnikSekwencyjny test A/B i granice zatrzymania
Gazeta cyfrowa testuje paywall z 4 analizami pośrednimi: granice O’Briena–Fleminga i Pococka, fałszywe alarmy, czas testu i zawyżony efekt – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Lai, T. L. (2003). Stochastic approximation. The Annals of Statistics, 31(2), 391–406. https://doi.org/10.1214/aos/1051027873 ● Otwarty dostęp
- Lai, T. L., & Siegmund, D. (1986). The contributions of Herbert Robbins to mathematical statistics. Statistical Science, 1(2), 276–284. https://doi.org/10.1214/ss/1177013708
- Lai, T. L., & Siegmund, D. (2018). Herbert Robbins, 1915–2001: A biographical memoir. National Academy of Sciences. https://www.nasonline.org/wp-content/uploads/2024/06/robbins-herbert.pdf ● Otwarty dostęp
- Robbins, H. (1952). Some aspects of the sequential design of experiments. Bulletin of the American Mathematical Society, 58(5), 527–535. https://doi.org/10.1090/s0002-9904-1952-09620-8 ● Otwarty dostęp
- Robbins, H., & Monro, S. (1951). A stochastic approximation method. The Annals of Mathematical Statistics, 22(3), 400–407. https://doi.org/10.1214/aoms/1177729586 ● Otwarty dostęp
Cytowania BibTeX
@article{lai2003stochastic, author={Lai, Tze Leung}, title={{Stochastic approximation}}, journal={The Annals of Statistics}, year={2003}, volume={31}, number={2}, pages={391--406}, doi={10.1214/aos/1051027873}}@article{lai1986contributions, author={Lai, Tze Leung and Siegmund, David}, title={{The contributions of Herbert Robbins to mathematical statistics}}, journal={Statistical Science}, year={1986}, volume={1}, number={2}, pages={276--284}, doi={10.1214/ss/1177013708}}@techreport{lai2018herbert, author={Lai, Tze Leung and Siegmund, David}, title={{Herbert Robbins, 1915–2001: A biographical memoir}}, year={2018}, institution={National Academy of Sciences}, url={https://www.nasonline.org/wp-content/uploads/2024/06/robbins-herbert.pdf}}@article{robbins1952some, author={Robbins, Herbert}, title={{Some aspects of the sequential design of experiments}}, journal={Bulletin of the American Mathematical Society}, year={1952}, volume={58}, number={5}, pages={527--535}, doi={10.1090/s0002-9904-1952-09620-8}}@article{robbins1951stochastic, author={Robbins, Herbert and Monro, Sutton}, title={{A stochastic approximation method}}, journal={The Annals of Mathematical Statistics}, year={1951}, volume={22}, number={3}, pages={400--407}, doi={10.1214/aoms/1177729586}}