Kim był Raj Chandra Bose?
Raj Chandra Bose (1901–1987) był indyjskim matematykiem i statystykiem, który połączył planowanie doświadczeń z geometrią skończoną i kombinatoryką. Studiował matematykę w Hindu College w Delhi, drugi stopień magistra zdobył w Kalkucie i w 1930 r. został tam wykładowcą. Na początku lat 30. Prasanta Chandra Mahalanobis, który zobaczył jego prace z geometrii, zatrudnił go na pół etatu w Indyjskim Instytucie Statystycznym (ISI) (Rau, 2009).
W 1941 r. Bose został jednym z dwóch pierwszych wykładowców nowego wydziału statystyki Uniwersytetu Kalkuckiego – wśród pierwszych studentów był C. R. Rao – a w 1945 r. jego kierownikiem. W 1949 r. przeniósł się na University of North Carolina w Chapel Hill, na wydział statystyki matematycznej założony w 1946 r. przez Harolda Hotellinga (Rau, 2009; Rao, 2017). W latach 1971–1980 był profesorem Colorado State University, a jako emeryt pracował do śmierci w 1987 r. W 1976 r. został członkiem National Academy of Sciences (Rau, 2009).
Najważniejsze pomysły
- Plany w blokach niekompletnych zrównoważonych (BIBD). Gdy blok – poletko, sesja, oceniający – mieści mniej obiektów, niż jest odmian czy warunków, każda para odmian powinna trafić razem do bloku tyle samo razy. O takie plany pytał Ronald Fisher podczas wizyty w Kalkucie w 1938 r. Bose, który od F. W. Leviego nauczył się ciał i geometrii skończonych, pokazał, jak je konstruować, a Fisher zachęcił go do publikacji w redagowanych przez siebie Annals of Eugenics (Bose, 1939; Rau, 2009). Z K. R. Nairem wprowadził też plany częściowo zrównoważone.
- Kwadraty łacińskie ortogonalne. W 1938 r. pokazał, jak zbudować pełny zbiór wzajemnie ortogonalnych kwadratów łacińskich, gdy rząd jest liczbą pierwszą lub jej potęgą (Rao, 2017). Dwa kwadraty są ortogonalne, gdy po nałożeniu każda para symboli występuje dokładnie raz; razem tworzą kwadrat grecko-łaciński.
- Hipoteza Eulera. Euler przypuszczał w 1782 r., że pary ortogonalnych kwadratów nie ma dla rzędu 6 ani dla żadnego rzędu będącego dwukrotnością liczby nieparzystej (Rao, 2017; Rau, 2009). Bose, S. S. Shrikhande i E. T. Parker pokazali, że takie pary istnieją dla każdego rzędu poza 1, 2 i 6 – Euler miał rację tylko co do szóstki (Bose i in., 1960; Rau, 2009).
- Kody korygujące błędy. Z uczniem D. K. Ray-Chaudhurim, z którym od 1955 r. zajmował się teorią kodowania, opisał klasę binarnych kodów korygujących błędy (Bose i Ray-Chaudhuri, 1960; Rau, 2009).
Ciekawostka
Pierwsza strona „New York Timesa”. Obalenie hipotezy Eulera ogłoszono na zjeździe American Mathematical Society w Nowym Jorku w kwietniu 1959 r. Redaktor naukowy „New York Timesa” przeprowadził wywiad z trzema autorami, a niedzielne wydanie z 26 kwietnia 1959 r. opisało wynik na pierwszej stronie, ze zdjęciem; gazeta dodała, że koledzy nazywają ich „Euler’s spoilers”, czyli mniej więcej „psujami Eulera” (Rao, 2017). Bose wspominał w autobiograficznym szkicu, że następnego ranka kasjer w hotelu rozpoznał go ze zdjęcia i uznał, że musiał dokonać czegoś niezwykłego, bo pierwszej strony „New York Timesa” nie da się kupić nawet za milion dolarów (Rau, 2009; Rao, 2017).
Początek jego statystycznej drogi też jest anegdotą. Rau (2009) zastrzega, że to opowieść: pewnego ranka Bosemu powiedziano, że przyjechał po niego samochodem jakiś „sahab” (w hindi: pan). Był to Mahalanobis, który ściągnął go do statystyki. Latem 1933 r., gdy ISI przenosił się na lato do Dardżylingu, Bose dostał do nauki tomy Biometriki, listę 50 artykułów i książkę Fishera o metodach statystycznych.
Przykład: dwa plany Bosego (dane symulowane)
Kwadraty ortogonalne rzędu 5. Ponieważ 5 jest liczbą pierwszą, wzór La(i, j) = (a·i + j) mod 5 dla a = 1, …, 4 daje cztery kwadraty łacińskie. Kod sprawdza, że każda z 6 par jest ortogonalna, i składa z dwóch pierwszych kwadrat grecko-łaciński: litery A–E mogą oznaczać np. warunki, a litery greckie – drugi czynnik, przy czym wiersze i kolumny kontrolują dwa źródła zakłóceń.
Plan BIBD(7, 3, 1). Siedem odmian rozkładamy w siedmiu blokach po trzy poletka, biorąc bloki {j, j + 1, j + 3} mod 7. Każda odmiana występuje r = 3 razy, a każda para odmian spotyka się w bloku dokładnie raz (λ = 1). Do tego planu dosymulowaliśmy plon: średnia odmiany (od 20 do 25) + efekt bloku (SD = 3) + błąd (SD = 1); parametry dobraliśmy ręcznie, ziarno set.seed(916).
W analizie wariancji z blokiem i odmianą efekt bloków wynosi F(6, 8) = 5.99, p = .012, a efekt odmian po uwzględnieniu bloków F(6, 8) = 6.88, p = .008. Surowe średnie mylą, bo każda odmiana trafiła do innych bloków: odmiana 6 ma przewagę nad odmianą 1 równą 5, a z surowych średnich wychodzi 2.73, z modelu z blokami – 4.62. W 1000 powtórzeniach średni błąd (RMSE) różnic między odmianami wynosi 1.96 dla surowych średnich i 0.86 dla modelu z blokami.
Na rysunku
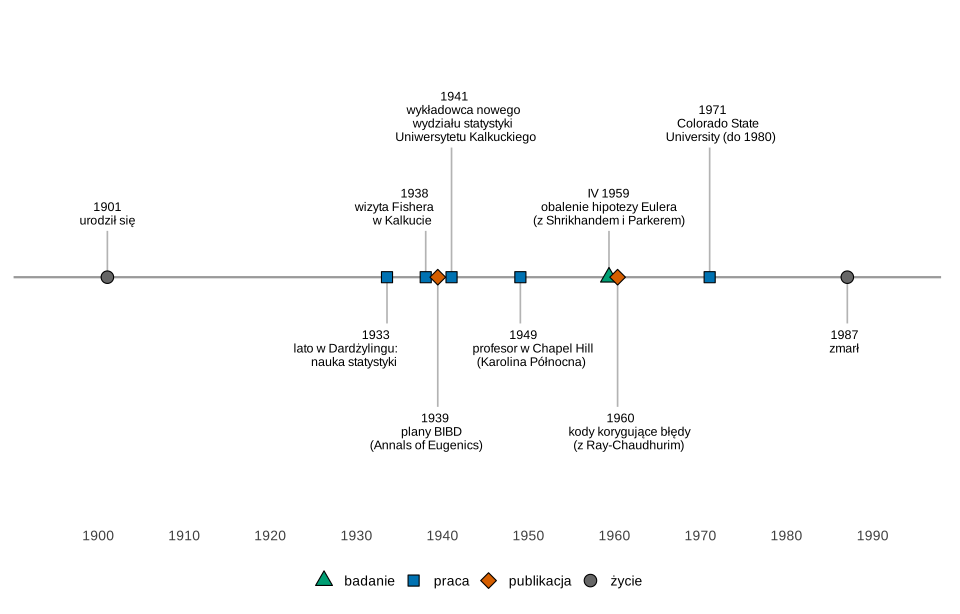
Co widać. Prace o planach doświadczeń powstały w Kalkucie po wizycie Fishera, a obalenie hipotezy Eulera i kody korygujące błędy – dekadę później w Chapel Hill.
Na co uważać. Rau (2009) podaje dwa lata zatrudnienia w ISI (1931 i 1932), dlatego na osi go nie ma.
Podpis do pracy:
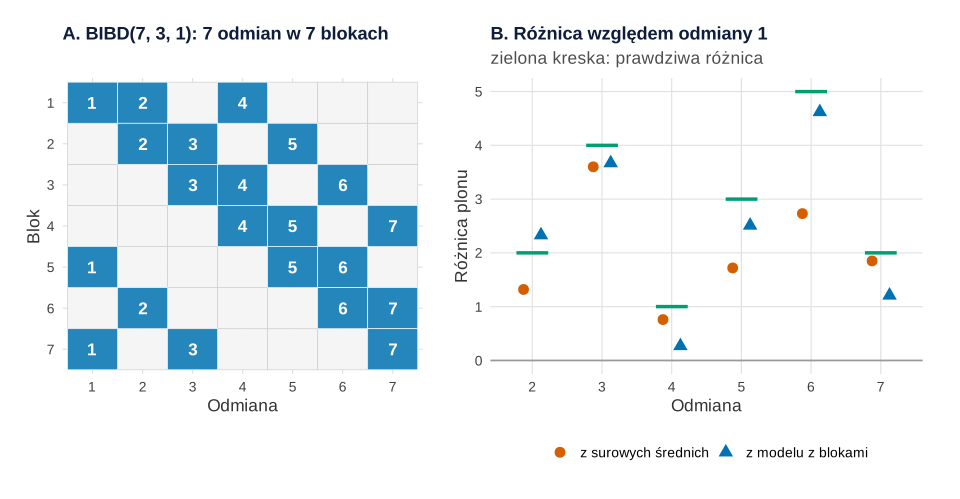
set.seed(916)).Co widać. W każdym wierszu siatki są trzy odmiany, w każdej kolumnie trzy bloki, a każde dwie odmiany stoją razem w dokładnie jednym wierszu (A). Trójkąty z modelu z blokami leżą zwykle bliżej zielonych kresek niż koła z surowych średnich – najwyraźniej przy odmianach 5 i 6 (B).
Na co uważać. Panel B to jeden zbiór; przy odmianach 4 i 7 model z blokami trafił tu gorzej niż surowe średnie. Ogólną przewagę modelu pokazuje dopiero 1000 powtórzeń (RMSE 0.86 wobec 1.96). Przy 21 poletkach na błąd zostaje tylko 8 stopni swobody.
Podpis do pracy:
Gdzie spotkasz Bosego w swojej pracy
- Gdy nie każdy może ocenić wszystko. Jeśli oceniający albo uczestnik zdąży ocenić tylko 3 z 7 bodźców, plan BIBD sprawia, że każda para bodźców jest porównana w obrębie tej samej osoby tyle samo razy; osoba jest wtedy blokiem, jak w randomizacji blokowej.
- Kolejność warunków. Kwadrat łaciński równoważy kolejność i sesję w schemacie wewnątrzobiektowym; kwadrat grecko-łaciński dokłada drugi czynnik.
- Analiza. Blok wchodzi do modelu obok warunku – tak jak w przykładzie; porównania warunków odczytujesz z modelu, nie z surowych średnich.
- Mniej warunków niż kombinacji. Ta sama matematyka skończonych struktur stoi za frakcyjnymi schematami czynnikowymi.
Plany w blokach niekompletnych rozwijał też Frank Yates (Rau, 2009), a w Chapel Hill kolegą Bosego był Herbert Robbins.
Plany Bosego w R
Kod buduje pełny zbiór kwadratów łacińskich ortogonalnych rzędu 5 i sprawdza ich ortogonalność, konstruuje plan BIBD(7, 3, 1) z różnic {0, 1, 3} mod 7, symuluje do niego plony, dopasowuje analizę wariancji z blokami, porównuje oszacowania różnic w 1000 powtórzeniach, a na końcu rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Każdy losujący blok ma własne set.seed(); ziarna ustaliliśmy raz i nie zmienialiśmy.
1. Kwadraty ortogonalne i plan BIBD: rysunek 2
Kod R rysunku 2
# Raj Chandra Bose: kwadraty łacińskie ortogonalne i plan w blokach niekompletnych zrównoważonych (dane symulowane)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(surowe = "#D55E00", skorygowane = "#0072B2", prawda = "#009E73")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# 1. Pełny zbiór kwadratów łacińskich ortogonalnych rzędu 5 (rząd = liczba pierwsza): L_a(i, j) = (a * i + j) mod 5
p <- 5
kwadrat <- function(a) outer(0:(p - 1), 0:(p - 1), function(i, j) (a * i + j) %% p)
L <- lapply(1:(p - 1), kwadrat)
# Kwadrat łaciński: każdy symbol raz w wierszu i raz w kolumnie
sapply(L, function(m) all(apply(m, 1, function(w) length(unique(w)) == p)) && all(apply(m, 2, function(k) length(unique(k)) == p)))
# Ortogonalność: po nałożeniu dwóch kwadratów każda z 25 par symboli występuje dokładnie raz
pary <- combn(p - 1, 2)
ortogonalne <- apply(pary, 2, function(ab) length(unique(paste(L[[ab[1]]], L[[ab[2]]]))) == p^2)
setNames(ortogonalne, apply(pary, 2, paste, collapse = "–"))
# Kwadrat grecko-łaciński: litery łacińskie z L1, greckie z L2
grecko_lacinski <- matrix(paste0(LETTERS[L[[1]] + 1], c("α", "β", "γ", "δ", "ε")[L[[2]] + 1]), p)
noquote(grecko_lacinski)

# 2. Plan BIBD(7, 3, 1): 7 odmian w 7 blokach po 3 poletka, bloki z różnic {0, 1, 3} mod 7
bloki <- t(sapply(0:6, function(j) (c(0, 1, 3) + j) %% 7 + 1))
rownames(bloki) <- paste("blok", 1:7); bloki
N <- matrix(0, 7, 7); for (b in 1:7) N[b, bloki[b, ]] <- 1   # macierz incydencji: bloki × odmiany
lambda <- crossprod(N)                                        # na przekątnej r, poza nią liczba wspólnych bloków
c(r = unique(diag(lambda)), lambda = unique(lambda[upper.tri(lambda)]))

# 3. Symulacja: plon = średnia odmiany + efekt bloku (żyzność) + błąd; parametry dobrane ręcznie
srednie_prawdziwe <- c(20, 22, 24, 21, 23, 25, 22)
symuluj <- function() {
  d <- data.frame(blok = factor(rep(1:7, each = 3)), odmiana = factor(c(t(bloki)), levels = 1:7))
  d$plon <- srednie_prawdziwe[d$odmiana] + rnorm(7, 0, 3)[d$blok] + rnorm(21, 0, 1)
  d
}
set.seed(916)
d <- symuluj()
m <- lm(plon ~ blok + odmiana, data = d)   # analiza wewnątrzblokowa: odmiany porównywane w obrębie bloków
anova(m)
# Różnice względem odmiany 1: z surowych średnich i z modelu z blokami (porównanie w obrębie bloków)
surowe <- tapply(d$plon, d$odmiana, mean)
porownanie <- data.frame(odmiana = 2:7, prawdziwa = srednie_prawdziwe[-1] - srednie_prawdziwe[1],
                         z_surowych_srednich = round(surowe[-1] - surowe[1], 2),
                         z_modelu_z_blokami = round(coef(m)[paste0("odmiana", 2:7)], 2), row.names = NULL)
porownanie

# 4. 1000 powtórzeń: błąd oszacowania różnic między odmianami (względem odmiany 1)
set.seed(9160)
bledy <- t(replicate(1000, {
  d <- symuluj()
  prawda <- srednie_prawdziwe[-1] - srednie_prawdziwe[1]
  sur <- tapply(d$plon, d$odmiana, mean); sur <- sur[-1] - sur[1]
  skor <- coef(lm(plon ~ blok + odmiana, data = d))[paste0("odmiana", 2:7)]
  c(surowe = sqrt(mean((sur - prawda)^2)), skorygowane = sqrt(mean((skor - prawda)^2)))
}))
round(colMeans(bledy), 2)   # średni RMSE różnic między odmianami

# Rysunek 2A: plan BIBD jako siatka bloki × odmiany
siatkaA <- data.frame(blok = factor(rep(1:7, each = 3), levels = 7:1), odmiana = factor(c(t(bloki)), levels = 1:7))
pA <- ggplot(siatkaA, aes(odmiana, blok)) +
  geom_tile(data = expand.grid(odmiana = factor(1:7), blok = factor(7:1, levels = 7:1)), fill = "grey96", colour = "grey80") +
  geom_tile(fill = kol[["skorygowane"]], colour = "white", alpha = 0.85) +
  geom_text(aes(label = odmiana), colour = "white", fontface = "bold", size = 4.5) +
  labs(title = "A. BIBD(7, 3, 1): 7 odmian w 7 blokach", x = "Odmiana", y = "Blok") +
  motyw + theme(panel.grid = element_blank())
# Rysunek 2B: różnice względem odmiany 1 z surowych średnich i z modelu z blokami na tle prawdziwych (jeden symulowany zbiór)
dlugie <- rbind(data.frame(odmiana = 2:7, rodzaj = "z surowych średnich", wartosc = porownanie$z_surowych_srednich),
                data.frame(odmiana = 2:7, rodzaj = "z modelu z blokami", wartosc = porownanie$z_modelu_z_blokami))
dlugie$rodzaj <- factor(dlugie$rodzaj, levels = c("z surowych średnich", "z modelu z blokami"))
pB <- ggplot(dlugie, aes(factor(odmiana), wartosc)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_point(data = porownanie, aes(factor(odmiana), prawdziwa), inherit.aes = FALSE, shape = 95, size = 14, colour = kol[["prawda"]]) +
  geom_point(aes(colour = rodzaj, shape = rodzaj), size = 3.4, position = position_dodge(0.5)) +
  scale_colour_manual(values = c("z surowych średnich" = kol[["surowe"]], "z modelu z blokami" = kol[["skorygowane"]]), name = NULL) +
  scale_shape_manual(values = c("z surowych średnich" = 16, "z modelu z blokami" = 17), name = NULL) +
  labs(title = "B. Różnica względem odmiany 1", subtitle = "zielona kreska: prawdziwa różnica", x = "Odmiana", y = "Różnica plonu") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.2))
p2
Wynik w R
[1] TRUE TRUE TRUE TRUE
 1–2  1–3  1–4  2–3  2–4  3–4
TRUE TRUE TRUE TRUE TRUE TRUE
     [,1] [,2] [,3] [,4] [,5]
[1,] Aα   Bβ   Cγ   Dδ   Eε
[2,] Bγ   Cδ   Dε   Eα   Aβ
[3,] Cε   Dα   Eβ   Aγ   Bδ
[4,] Dβ   Eγ   Aδ   Bε   Cα
[5,] Eδ   Aε   Bα   Cβ   Dγ
       [,1] [,2] [,3]
blok 1    1    2    4
blok 2    2    3    5
blok 3    3    4    6
blok 4    4    5    7
blok 5    5    6    1
blok 6    6    7    2
blok 7    7    1    3
     r lambda
     3      1
Analysis of Variance Table

Response: plon
          Df Sum Sq Mean Sq F value   Pr(>F)
blok       6 35.767  5.9612  5.9941 0.012020 *
odmiana    6 41.042  6.8404  6.8782 0.007901 **
Residuals  8  7.956  0.9945
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  odmiana prawdziwa z_surowych_srednich z_modelu_z_blokami
1       2         2                1.32               2.33
2       3         4                3.60               3.67
3       4         1                0.76               0.27
4       5         3                1.72               2.51
5       6         5                2.73               4.62
6       7         2                1.85               1.21
     surowe skorygowane
       1.96        0.86
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Raj Chandra Bose, 1901–1987 – daty według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1901, 1933.5, 1938, 1939.4, 1941, 1949, 1959.3, 1960.3, 1971, 1987),
  etykieta = c("1901", "1933", "1938", "1939", "1941", "1949", "IV 1959", "1960", "1971", "1987"),
  opis = c("urodził się", "lato w Dardżylingu:\nnauka statystyki", "wizyta Fishera\nw Kalkucie", "plany BIBD\n(Annals of Eugenics)",
           "wykładowca nowego\nwydziału statystyki\nUniwersytetu Kalkuckiego", "profesor w Chapel Hill\n(Karolina Północna)",
           "obalenie hipotezy Eulera\n(z Shrikhandem i Parkerem)", "kody korygujące błędy\n(z Ray-Chaudhurim)", "Colorado State\nUniversity (do 1980)", "zmarł"),
  rodzaj = c("życie", "praca", "praca", "publikacja", "praca", "praca", "badanie", "publikacja", "praca", "życie"))
# Gęste lata 1933–1941 i 1959–1960: etykiety nad (1) i pod (−1) osią, na trzech wysokościach
zdarzenia$strona     <- c(1, -1, 1, -1, 1, -1, 1, -1, 1, -1)
zdarzenia$poziom     <- c(0.5, 0.5, 0.5, 1.4, 1.4, 0.5, 0.5, 1.4, 1.4, 0.5)
zdarzenia$wyrownanie <- c(0.5, 0.9, 0.9, 0.6, 0.4, 0.4, 0.5, 0.4, 0.4, 0.6)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "badanie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "badanie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom * strona), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 4, colour = "black") +
  geom_text(aes(y = (poziom + 0.07) * strona, label = paste0(etykieta, "\n", opis), vjust = ifelse(strona > 0, 0, 1), hjust = wyrownanie),
            size = 3.3, lineheight = 0.9) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1895, 1993), breaks = seq(1900, 1990, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.6)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (model liniowy i analiza wariancji – lm() i anova() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Raj Chandra Bose?
Indyjskim matematykiem i statystykiem (1901–1987). Pracował w Indyjskim Instytucie Statystycznym i na Uniwersytecie Kalkuckim, od 1949 r. na University of North Carolina w Chapel Hill, a w latach 1971–1980 na Colorado State University (Rau, 2009).
Kim byli „Euler’s spoilers”?
Tak „New York Times” z 26 kwietnia 1959 r. nazwał Bosego, S. S. Shrikhandego i E. T. Parkera, którzy pokazali, że pary ortogonalnych kwadratów łacińskich istnieją dla każdego rzędu poza 1, 2 i 6, wbrew hipotezie Eulera z 1782 r. (Rao, 2017; Rau, 2009).
Czym jest plan BIBD, który konstruował Bose?
To plan, w którym każdy blok mieści tylko część warunków, ale każdy warunek występuje tyle samo razy, a każda para warunków trafia razem do bloku tyle samo razy. Bose konstruował takie plany z geometrii skończonych (Bose, 1939).
Jaki związek miał Bose z Fisherem i Mahalanobisem?
Mahalanobis ściągnął go do Indyjskiego Instytutu Statystycznego, a Fisher podczas wizyty w Kalkucie w 1938 r. pytał o plany doświadczeń i zachęcił Bosego do opublikowania pracy o planach BIBD w Annals of Eugenics (Rau, 2009).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bose, R. C. (1939). On the construction of balanced incomplete block designs. Annals of Eugenics, 9(4), 353–399. https://doi.org/10.1111/j.1469-1809.1939.tb02219.x
- Bose, R. C., & Ray-Chaudhuri, D. K. (1960). On a class of error correcting binary group codes. Information and Control, 3(1), 68–79. https://doi.org/10.1016/s0019-9958(60)90287-4 ● Otwarty dostęp
- Bose, R. C., Shrikhande, S. S., & Parker, E. T. (1960). Further results on the construction of mutually orthogonal Latin squares and the falsity of Euler’s conjecture. Canadian Journal of Mathematics, 12, 189–203. https://doi.org/10.4153/cjm-1960-016-5 ● Otwarty dostęp
- Rao, N. (2017). Shrikhande, “Euler’s spoiler”, turns 100. Bhāvanā, 1(4). https://bhavana.org.in/shrikhande-eulers-spoiler-turns-100/ ● Otwarty dostęp
- Rau, A. R. P. (2009). R A Fisher, design theory, and the Indian connection. Journal of Biosciences, 34(3), 353–363. https://doi.org/10.1007/s12038-009-0041-3 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bose1939construction, author={Bose, Raj Chandra}, title={{On the construction of balanced incomplete block designs}}, journal={Annals of Eugenics}, year={1939}, volume={9}, number={4}, pages={353--399}, doi={10.1111/j.1469-1809.1939.tb02219.x}}@article{bose1960class, author={Bose, Raj Chandra and Ray-Chaudhuri, Dwijendra Kumar}, title={{On a class of error correcting binary group codes}}, journal={Information and Control}, year={1960}, volume={3}, number={1}, pages={68--79}, doi={10.1016/s0019-9958(60)90287-4}}@article{bose1960further, author={Bose, Raj Chandra and Shrikhande, Sharadchandra Shankar and Parker, Ernest Tilden}, title={{Further results on the construction of mutually orthogonal Latin squares and the falsity of Euler’s conjecture}}, journal={Canadian Journal of Mathematics}, year={1960}, volume={12}, pages={189--203}, doi={10.4153/cjm-1960-016-5}}@article{rao2017shrikhande, author={Rao, Nithyanand}, title={{Shrikhande, “Euler’s spoiler”, turns 100}}, journal={Bhāvanā}, year={2017}, volume={1}, number={4}, publisher={The Bhavana Trust}, url={https://bhavana.org.in/shrikhande-eulers-spoiler-turns-100/}}@article{rau2009fisher, author={Rau, A. R. P.}, title={{R A Fisher, design theory, and the Indian connection}}, journal={Journal of Biosciences}, year={2009}, volume={34}, number={3}, pages={353--363}, doi={10.1007/s12038-009-0041-3}}