Kim był C. R. Rao?
Calyampudi Radhakrishna Rao (1920–2023) urodził się 10 września 1920 r. w Hadagali, w dzisiejszym indyjskim stanie Karnataka. W 1940 r. uzyskał dyplom magistra matematyki na Andhra University, a w 1943 r. – magistra statystyki na Uniwersytecie Kalkuckim (DeGroot, 1987). Od 1 stycznia 1941 r. szkolił się w Indyjskim Instytucie Statystycznym (ISI), do którego przyjął go Prasanta Chandra Mahalanobis (Bera, 2003). W 1944 r. został tam statystykiem, a w 1949 r. – profesorem (DeGroot, 1987).
Doktorat obronił w 1948 r. w Cambridge, z pracą o problemach klasyfikacji biologicznej (DeGroot, 1987). Promotorem był Ronald Fisher, który postawił warunek: Rao miał niemal codziennie pracować w jego laboratorium genetycznym (DasGupta, 2024). Po powrocie kierował szkołą badawczo-dydaktyczną ISI (od 1964 r.), a w 1972 r. został sekretarzem i dyrektorem Instytutu (DeGroot, 1987). W 1979 r. przeniósł się na University of Pittsburgh (DeGroot, 1987), później do Penn State, gdzie pracował do emerytury w 2001 r., a następnie był związany z University at Buffalo. Zmarł 22 sierpnia 2023 r. w Buffalo w wieku 102 lat (DasGupta, 2024).
Najważniejsze pomysły
- Granica Craméra–Rao. W pracy z 1945 r. w biuletynie Kalkuckiego Towarzystwa Matematycznego Rao zapytał, jaka dokładność estymacji parametrów jest w ogóle osiągalna, i wyprowadził dolną granicę wariancji estymatora (Nielsen, 2013). Dziś zapisujemy ją jako Var(T) ≥ 1/[n·I(θ)], gdzie I(θ) to informacja Fishera. Tę samą granicę podał w książce z 1946 r. Harald Cramér. Jak ją wykorzystać do porównania średniej i mediany, pokazuje hasło efektywność estymatora.
- Twierdzenie Rao–Blackwella. Daje przepis na poprawienie estymatora nieobciążonego: wystarczy uśrednić go przy ustalonej statystyce dostatecznej. Rao i David Blackwell doszli do tego niezależnie (DasGupta, 2024).
- Geometria informacji. W tej samej pracy z 1945 r. Rao potraktował rodzinę rozkładów jak przestrzeń z odległością wyznaczoną przez informację Fishera – stąd „odległość Rao” i cała dziedzina zwana geometrią informacji (Nielsen, 2013).
- Test punktowy (score). W 1948 r. opisał testy hipotez o kilku parametrach w dużych próbach (Rao, 1948). Dziś to test score, czyli test mnożnika Lagrange’a, trzeci obok testu Walda i testu ilorazu wiarygodności.
- Inne pola. Tablice ortogonalne w planowaniu eksperymentów, książka Linear Statistical Inference and Its Applications (1973) i budowa studiów statystycznych w Indiach (DasGupta, 2024).
Ciekawostka
Granica Craméra–Rao zaczęła się podobno od pytania studenta. DasGupta (2024) przytacza przekazywaną w środowisku anegdotę: podczas zajęć w ISI student V. M. Dandekar zapytał, jak mała może być wariancja estymatora nieobciążonego przy danej liczebności próby. Rao miał rozwiązać problem w ciągu nocy – a Cramér pracował nad tym samym pytaniem niezależnie.
Uznanie przyszło też bardzo późno: w 2023 r., jako 102-latek, Rao otrzymał International Prize in Statistics. W tym samym roku zmarł (DasGupta, 2024).
Przykład: trzy estymatory jednego prawdopodobieństwa
Hasło efektywność estymatora porównuje średnią i medianę. Tu pokazujemy oba pomysły Rao z 1945 r. na innym zadaniu: z próby n liczebności z rozkładu Poissona (λ = 1) szacujemy prawdopodobieństwo zera, θ = P(X = 0) = exp(−1) = 0.3679 – np. odsetek dni bez zdarzenia. Porównujemy: T1 – odsetek zer w próbie; T2 – jego poprawkę Rao–Blackwella, czyli ((n − 1)/n)S, gdzie S to suma obserwacji; T3 – estymator największej wiarygodności exp(−średnia). Granica Craméra–Rao dla nieobciążonych estymatorów θ wynosi λ·exp(−2λ)/n. Dane są symulowane (set.seed(1945), 100 000 prób dla każdego n; set.seed(1948) dla rysunku).
Przy n = 10 granica wynosi 0.01353. Odsetek zer ma wariancję 0.02325 (symulacja: 0.02335), estymator Rao–Blackwella 0.01423 (symulacja: 0.01430), a estymator największej wiarygodności – błąd średniokwadratowy 0.01452, bo jest obciążony (średnia 0.3859 zamiast 0.3679). Efektywność odsetka zer wobec granicy wynosi 0.582 niezależnie od n: liczy tylko, czy obserwacja jest zerem, i gubi resztę informacji. Poprawka Rao–Blackwella podnosi ją do 0.951, a przy rosnącym n zbliża się do granicy: 0.903 przy n = 5 i 0.995 przy n = 100. Nawet najlepszy estymator nieobciążony nie musi więc osiągać granicy w małej próbie.
Na rysunku
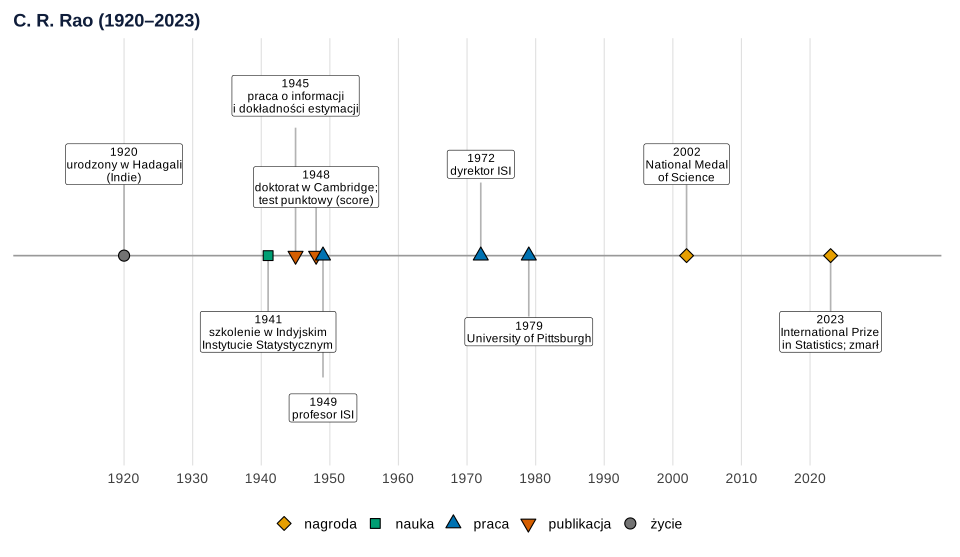
Co widać. Najważniejsze prace – granica dokładności (1945) i test punktowy (1948) – powstały na samym początku kariery, jeszcze przed profesurą w ISI. Potem przez dziesięciolecia kierował Instytutem, a od 1979 r. pracował na uczelniach amerykańskich.
Na co uważać. Oś zawiera tylko daty z cytowanych źródeł. Rok 1941 to początek szkolenia w ISI (Bera, 2003), a etat statystyka Rao otrzymał w 1944 r. (DeGroot, 1987).
Podpis do pracy:
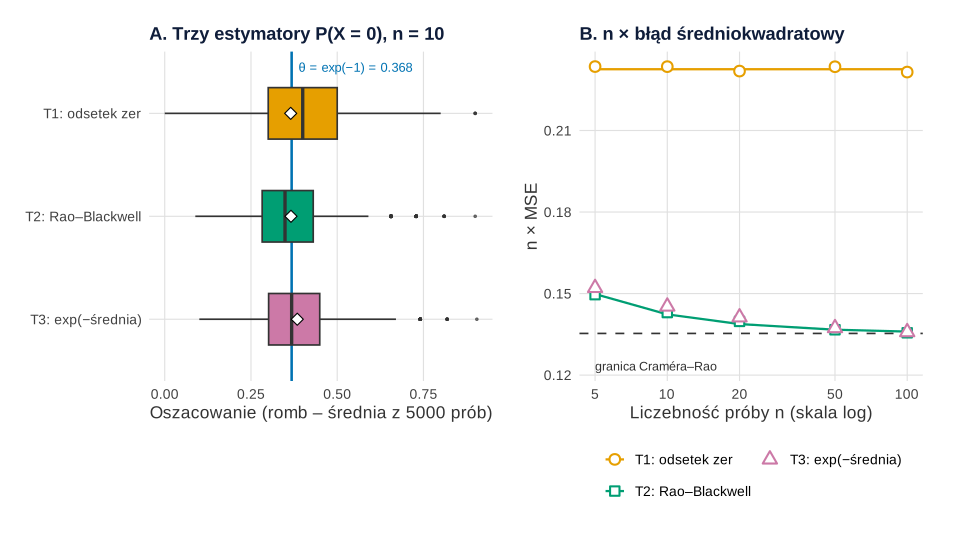
set.seed(1945) i set.seed(1948)).Co widać. Na panelu A wszystkie trzy pudełka obejmują prawdziwą wartość, ale odsetek zer rozrzuca się najbardziej (odchylenie standardowe 0.1539 wobec 0.1198 i 0.1194). Panel B pokazuje sens granicy: pomnożony przez n błąd odsetka zer stoi w miejscu wysoko nad nią, a estymator Rao–Blackwella i estymator największej wiarygodności schodzą do niej wraz ze wzrostem próby.
Na co uważać. Granica dotyczy estymatorów nieobciążonych; estymator obciążony (T3) może mieć nawet mniejszą wariancję, dlatego porównujemy błąd średniokwadratowy. Linie na panelu B to wartości dokładne dla T1 i T2, punkty – wyniki symulacji z niewielkim błędem losowym.
Podpis do pracy:
Gdzie spotkasz Rao w swojej pracy
- Testy w modelach. Test score (test Rao) pojawia się w diagnostyce modeli regresji i w SEM jako indeksy modyfikacji – zob. test mnożnika Lagrange’a.
- Błędy standardowe z metody największej wiarygodności. Gdy program podaje błąd standardowy oszacowania z odwrotności informacji Fishera, korzysta z tej samej wielkości, która wyznacza granicę Craméra–Rao – zob. metoda największej wiarygodności i błąd standardowy.
- Wybór estymatora. Gdy porównujesz estymatory w badaniu symulacyjnym, granica Craméra–Rao mówi, ile w ogóle da się zyskać – zob. efektywność estymatora i jak zaplanować badanie symulacyjne.
Spory, mity i trudne strony
- Czyja jest granica? Rao opublikował ją w 1945 r., Cramér – w książce z 1946 r., a w pracach po francusku podali ją też Maurice Fréchet (jeden parametr) i Georges Darmois (wiele parametrów); stąd nazwa „granica Craméra–Rao–Frécheta–Darmoisa” (Nielsen, 2013).
- Rao–Blackwell. Twierdzenie nosi dwa nazwiska, bo Rao i Blackwell doszli do niego niezależnie (DasGupta, 2024).
- Jeden test, trzy nazwy. W statystyce mówi się o teście score albo teście Rao, w ekonometrii – o teście mnożnika Lagrange’a. To ta sama idea, opisana przez Rao w 1948 r.
Rao w R
Kod rysuje oś czasu, a potem symuluje próby z rozkładu Poissona i porównuje trzy estymatory prawdopodobieństwa zera: odsetek zer, jego poprawkę Rao–Blackwella i estymator największej wiarygodności. Liczy średnią, obciążenie i błąd średniokwadratowy, wartości dokładne wariancji oraz granicę Craméra–Rao. Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
średnią, obciążenie i błąd średniokwadratowy trzech estymatorów dla n od 5 do 100, wariancje dokładne, granicę Craméra–Rao, efektywność T1 i T2 oraz odchylenia standardowe przy n = 10.
Kod R rysunków 1 i 2
# C. R. Rao: oś czasu, granica Craméra–Rao i poprawa Rao–Blackwella (symulacja)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", zielony = "#009E73",
        fiolet = "#CC79A7", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu (lata według DeGroota 1987, Bery 2003, Rao 1945 i 1948 oraz DasGupty 2024)
zdarzenia <- data.frame(
  rok = c(1920, 1941, 1945, 1948, 1949, 1972, 1979, 2002, 2023),
  opis = c("urodzony w Hadagali\n(Indie)", "szkolenie w Indyjskim\nInstytucie Statystycznym",
           "praca o informacji\ni dokładności estymacji", "doktorat w Cambridge;\ntest punktowy (score)",
           "profesor ISI", "dyrektor ISI", "University of Pittsburgh", "National Medal\nof Science",
           "International Prize\nin Statistics; zmarł"),
  rodzaj = c("życie", "nauka", "publikacja", "publikacja", "praca", "praca", "praca", "nagroda", "nagroda"))
zdarzenia$y <- c(1.2, -1, 2.1, 0.9, -2, 1.2, -1, 1.2, -1)   # wysokość etykiet, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = rok, yend = y * 0.8), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(y = y, label = paste0(rok, "\n", opis)), size = 3.1, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c("życie" = 21, "nauka" = 22, "praca" = 24, "publikacja" = 25, "nagroda" = 23), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["szary"]], "nauka" = oi[["zielony"]], "praca" = oi[["niebieski"]],
                               "publikacja" = oi[["cynober"]], "nagroda" = oi[["pomaranczowy"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1920, 2020, 10), limits = c(1910, 2033)) + scale_y_continuous(limits = c(-2.5, 2.6)) +
  labs(title = "C. R. Rao (1920–2023)", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. Szacujemy theta = P(X = 0) = exp(-lambda) z próby n obserwacji z rozkładu Poissona.
#    T1 – odsetek zer w próbie (nieobciążony, ale korzysta tylko z informacji „zero / nie zero”),
#    T2 – poprawka Rao–Blackwella: E(T1 | S), S = suma obserwacji (statystyka dostateczna) -> ((n - 1) / n)^S,
#    T3 – estymator największej wiarygodności exp(-średnia) (lekko obciążony).
#    Granica Craméra–Rao dla nieobciążonych estymatorów exp(-lambda): lambda * exp(-2 * lambda) / n.
lambda <- 1
theta <- exp(-lambda)
estymatory <- function(x) {             # x: macierz, każdy wiersz to jedna próba
  n <- ncol(x); S <- rowSums(x)
  cbind(T1 = rowMeans(x == 0), T2 = ((n - 1) / n)^S, T3 = exp(-S / n))
}
symuluj <- function(n, R = 100000) {
  w <- estymatory(matrix(rpois(n * R, lambda), nrow = R))
  data.frame(n = n, estymator = colnames(w),
             srednia = colMeans(w), obciazenie = colMeans(w) - theta, mse = colMeans((w - theta)^2))
}
set.seed(1945)
liczebnosci <- c(5, 10, 20, 50, 100)
wyniki <- do.call(rbind, lapply(liczebnosci, symuluj))
rownames(wyniki) <- NULL
# Wartości dokładne: wariancja T1 i T2 oraz granica Craméra–Rao
wyniki$teoria <- with(wyniki, ifelse(estymator == "T1", theta * (1 - theta) / n,
                              ifelse(estymator == "T2", exp(-2 * lambda) * (exp(lambda / n) - 1), NA)))
wyniki$granica_CR <- lambda * exp(-2 * lambda) / wyniki$n
c(theta = theta)
print(transform(wyniki, srednia = round(srednia, 4), obciazenie = round(obciazenie, 4), mse = signif(mse, 4),
                teoria = signif(teoria, 4), granica_CR = signif(granica_CR, 4)))
# Efektywność (granica / wariancja) z wartości dokładnych: T1 i T2
n <- liczebnosci
efektywnosc <- rbind(T1 = (lambda * exp(-2 * lambda) / n) / (theta * (1 - theta) / n),
                     T2 = (lambda * exp(-2 * lambda) / n) / (exp(-2 * lambda) * (exp(lambda / n) - 1)))
colnames(efektywnosc) <- paste0("n=", n)
round(efektywnosc, 3)

# Rysunek 2A: rozkład trzech estymatorów przy n = 10 (osobna symulacja, 5000 prób)
set.seed(1948)
proby <- estymatory(matrix(rpois(10 * 5000, lambda), nrow = 5000))
dlugie <- data.frame(estymator = factor(rep(c("T1: odsetek zer", "T2: Rao–Blackwell", "T3: exp(−średnia)"), each = nrow(proby)),
                                        levels = c("T3: exp(−średnia)", "T2: Rao–Blackwell", "T1: odsetek zer")),
                     wartosc = c(proby[, "T1"], proby[, "T2"], proby[, "T3"]))
round(tapply(dlugie$wartosc, dlugie$estymator, sd), 4)
pA <- ggplot(dlugie, aes(wartosc, estymator)) +
  geom_vline(xintercept = theta, colour = oi[["niebieski"]], linewidth = 0.9) +
  geom_boxplot(aes(fill = estymator), width = 0.5, outlier.size = 0.6, outlier.alpha = 0.4, show.legend = FALSE) +
  stat_summary(fun = mean, geom = "point", shape = 23, size = 3, fill = "white") +
  annotate("text", x = theta + 0.02, y = 3.45, label = sprintf("θ = exp(−1) = %.3f", theta), hjust = 0, size = 3.4, colour = oi[["niebieski"]]) +
  scale_fill_manual(values = c(oi[["fiolet"]], oi[["zielony"]], oi[["pomaranczowy"]])) +
  labs(title = "A. Trzy estymatory P(X = 0), n = 10", x = "Oszacowanie (romb – średnia z 5000 prób)", y = NULL) +
  motyw
# Rysunek 2B: n × MSE z symulacji (punkty), wartości dokładne dla T1 i T2 (linie) i granica Craméra–Rao (linia przerywana)
wyniki$nazwa <- factor(wyniki$estymator, levels = c("T1", "T2", "T3"),
                       labels = c("T1: odsetek zer", "T2: Rao–Blackwell", "T3: exp(−średnia)"))
pB <- ggplot(wyniki, aes(n, n * mse, colour = nazwa, shape = nazwa)) +
  geom_line(data = subset(wyniki, !is.na(teoria)), aes(y = n * teoria), linewidth = 0.8) +
  geom_hline(yintercept = lambda * exp(-2 * lambda), colour = "grey20", linetype = "dashed") +
  annotate("text", x = 5, y = lambda * exp(-2 * lambda) - 0.012, label = "granica Craméra–Rao", hjust = 0, size = 3.3, colour = "grey20") +
  geom_point(size = 3, fill = "white", stroke = 1.1) +
  scale_x_log10(breaks = liczebnosci) +
  scale_colour_manual(values = c(oi[["pomaranczowy"]], oi[["zielony"]], oi[["fiolet"]]), name = NULL) +
  scale_shape_manual(values = c(21, 22, 24), name = NULL) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(title = "B. n × błąd średniokwadratowy", x = "Liczebność próby n (skala log)", y = "n × MSE") +
  motyw + theme(legend.position = "bottom")
p_metoda <- pA + pB + plot_layout(widths = c(1, 1))
p_os
p_metoda
Wynik w R
    theta
0.3678794
     n estymator srednia obciazenie      mse   teoria granica_CR
1    5        T1  0.3677    -0.0002 0.046710 0.046510   0.027070
2    5        T2  0.3679     0.0000 0.029920 0.029960   0.027070
3    5        T3  0.4040     0.0362 0.030420       NA   0.027070
4   10        T1  0.3677    -0.0002 0.023350 0.023250   0.013530
5   10        T2  0.3677    -0.0002 0.014300 0.014230   0.013530
6   10        T3  0.3859     0.0180 0.014520       NA   0.013530
7   20        T1  0.3683     0.0004 0.011590 0.011630   0.006767
8   20        T2  0.3681     0.0003 0.006988 0.006939   0.006767
9   20        T3  0.3773     0.0094 0.007063       NA   0.006767
10  50        T1  0.3677    -0.0002 0.004669 0.004651   0.002707
11  50        T2  0.3678     0.0000 0.002734 0.002734   0.002707
12  50        T3  0.3715     0.0036 0.002746       NA   0.002707
13 100        T1  0.3676    -0.0003 0.002315 0.002325   0.001353
14 100        T2  0.3677    -0.0002 0.001356 0.001360   0.001353
15 100        T3  0.3695     0.0016 0.001358       NA   0.001353
     n=5  n=10  n=20  n=50 n=100
T1 0.582 0.582 0.582 0.582 0.582
T2 0.903 0.951 0.975 0.990 0.995
T3: exp(−średnia) T2: Rao–Blackwell   T1: odsetek zer
           0.1194            0.1198            0.1539
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie – funkcja rpois() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był C. R. Rao?
Indyjsko-amerykańskim statystykiem (1920–2023). Kształcił się w Indyjskim Instytucie Statystycznym i w Cambridge pod kierunkiem Ronalda Fishera, potem kierował ISI, a od 1979 r. pracował w USA. Zmarł w wieku 102 lat, w roku, w którym otrzymał International Prize in Statistics.
Co mówi granica Craméra–Rao?
Że wariancja estymatora nieobciążonego nie może być mniejsza niż 1/[n·I(θ)], gdzie I(θ) to informacja Fishera z jednej obserwacji. Rao opublikował ją w 1945 r., Cramér niezależnie w 1946 r.; niezależnie podali ją też Fréchet i Darmois.
Na czym polega twierdzenie Rao–Blackwella?
Jeśli estymator nieobciążony uśrednić przy ustalonej statystyce dostatecznej, powstaje estymator również nieobciążony i nie gorszy, a zwykle lepszy. Rao i David Blackwell doszli do tego niezależnie.
Dlaczego test score nazywa się też testem Rao?
Bo opisał go C. R. Rao w 1948 r. Test sprawdza hipotezę na podstawie modelu ograniczonego, mierząc nachylenie logarytmu wiarygodności; w ekonometrii nazywa się go testem mnożnika Lagrange’a.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bera, A. K. (2003). The ET interview: Professor C.R. Rao. Econometric Theory, 19(2), 331–400. https://doi.org/10.1017/s0266466603192067
- DasGupta, A. (2024). C.R. Rao: Paramount statistical scientist (1920 to 2023). Proceedings of the National Academy of Sciences, 121(9), Article e2321318121. https://doi.org/10.1073/pnas.2321318121 ● Otwarty dostęp
- DeGroot, M. H. (1987). A conversation with C. R. Rao. Statistical Science, 2(1), 53–67. https://doi.org/10.1214/ss/1177013438 ● Otwarty dostęp
- Nielsen, F. (2013). Cramér-Rao lower bound and information geometry. In R. Bhatia, C. S. Rajan, & A. I. Singh, Connected at infinity II: A selection of mathematics by Indians (pp. 18–37). Hindustan Book Agency. https://doi.org/10.1007/978-93-86279-56-9_2 ● Otwarty dostęp: pełny tekst
- Rao, C. R. (1948). Large sample tests of statistical hypotheses concerning several parameters with applications to problems of estimation. Mathematical Proceedings of the Cambridge Philosophical Society, 44(1), 50–57. https://doi.org/10.1017/s0305004100023987
Cytowania BibTeX
@article{bera2003et, author={Bera, Anil K.}, title={{The ET interview: Professor C.R. Rao}}, journal={Econometric Theory}, year={2003}, volume={19}, number={2}, pages={331--400}, doi={10.1017/s0266466603192067}}@article{dasgupta2024c, author={DasGupta, Anirban}, title={{C.R. Rao: Paramount statistical scientist (1920 to 2023)}}, journal={Proceedings of the National Academy of Sciences}, year={2024}, volume={121}, number={9}, eid={e2321318121}, doi={10.1073/pnas.2321318121}}@article{degroot1987conversation, author={DeGroot, Morris H.}, title={{A conversation with C. R. Rao}}, journal={Statistical Science}, year={1987}, volume={2}, number={1}, pages={53--67}, doi={10.1214/ss/1177013438}}@incollection{nielsen2013cramer, author={Nielsen, Frank}, title={{Cramér-Rao lower bound and information geometry}}, booktitle={Connected at infinity II: A selection of mathematics by Indians}, year={2013}, pages={18--37}, publisher={Hindustan Book Agency}, doi={10.1007/978-93-86279-56-9_2}}@article{rao1948large, author={Rao, C. Radhakrishna}, title={{Large sample tests of statistical hypotheses concerning several parameters with applications to problems of estimation}}, journal={Mathematical Proceedings of the Cambridge Philosophical Society}, year={1948}, volume={44}, number={1}, pages={50--57}, doi={10.1017/s0305004100023987}}