Kim był Charles Spearman?
Charles Spearman (1863–1945) był brytyjskim psychologiem, który do statystyki doszedł okrężną drogą. Urodził się i zmarł w Londynie (Thomson, 1947). Najpierw był zawodowym oficerem saperów i brał udział w kampanii w Birmie; potem zrezygnował ze służby i wyjechał do Lipska, by studiować psychologię eksperymentalną u Wundta. Pobyt w Niemczech przerwała jeszcze służba w czasie wojny burskiej (Thomson, 1947).
Lovie i Lovie (1996) zaliczają go do nielicznych psychologów przyjętych do Royal Society. Uznają go za twórcę metody nazywanej dziś analizą czynnikową i współpatrona wzoru Spearmana–Browna. Zauważają przy tym ironię: najlepiej pamięta się go z korelacji rang, którą sam uważał za drobiazg.
Najważniejsze pomysły
Prawie wszystko, z czego Spearman jest znany, ukazało się w dwóch artykułach z 1904 r. w The American Journal of Psychology. W pierwszym (Spearman, 1904a) napisał wprost, że psychologii brakuje porządnych metod mierzenia związku, i spróbował to naprawić.
- Korelacja na rangach. Spearman przypisał pierwszy liczbowy wskaźnik korelacji Galtonowi, a najlepszą metodę – współczynnik iloczynu momentów – Pearsonowi. Dla krótkich szeregów zalecał jednak porównywanie rang, m.in. liczenie współczynnika Pearsona na rangach i prostszą metodę różnic rang (Spearman, 1904a). Stąd dzisiejsza korelacja rang Spearmana.
- Atenuacja. W tej samej pracy opisał, jak błąd pomiaru osłabia (atenuuje) korelację, i podał sposób jej odtworzenia z rzetelności obu pomiarów – to korekta na atenuację.
- Czynnik ogólny g. W drugim artykule (Spearman, 1904b) porównał progi rozróżniania dźwięku, światła i ciężaru z ocenami szkolnymi i nauczycielskimi dzieci. Po korekcie na błąd pomiaru wywnioskował, że wszystkie rodzaje aktywności intelektualnej mają jedną wspólną funkcję, a każda ma też elementy swoiste. Przedmioty szkolne układały się przy tym w stałą hierarchię „wysycenia” czynnikiem wspólnym. To początek analizy czynnikowej.
- Rzetelność testu. W 1910 r. ogłosił pracę o korelacji liczonej z danych obarczonych błędem (Spearman, 1910); od niej i od równoległej pracy Browna pochodzi nazwa wzoru Spearmana–Browna, który przewiduje rzetelność testu po wydłużeniu lub skróceniu.
Przykład na historycznych danych
Danych Spearmana z 1904 r. nie ma w zainstalowanych pakietach R, więc jego pomysł – jeden czynnik ogólny tłumaczący korelacje między testami – sprawdzamy na zbiorze ability.cov z pakietu datasets. Według pliku pomocy to macierz kowariancji sześciu testów u 112 osób: niewerbalny test inteligencji ogólnej (test Cattella wolny od wpływów kultury), uzupełnianie obrazków, układanie klocków, labirynty, rozumienie tekstu i słownik. Plik pomocy zaznacza, że w źródle (Bartholomew) macierze kowariancji i korelacji są niezgodne i żadnej nie ma w pierwotnym artykule.
Model z jednym czynnikiem (estymowany dzisiejszą metodą największej wiarygodności, nie metodą Spearmana) daje ładunki od .30 (labirynty) do .88 (rozumienie tekstu): .88, .85 (słownik), .68 (test ogólny), .50 (klocki), .38 (obrazki), .30. Jeśli istnieje tylko jeden czynnik, korelacja dwóch testów powinna równać się iloczynowi ich ładunków. Tak jest dla większości par, ale nie dla testów wykonawczych: obrazki i klocki korelują .57, a jeden czynnik przewiduje tylko .19; klocki i labirynty – .45 wobec .15. Test dopasowania odrzuca model jednoczynnikowy, χ²(9) = 75.18, p < .001, a z dwoma czynnikami dopasowanie jest dobre, χ²(4) = 6.11, p = .191.
Na rysunku
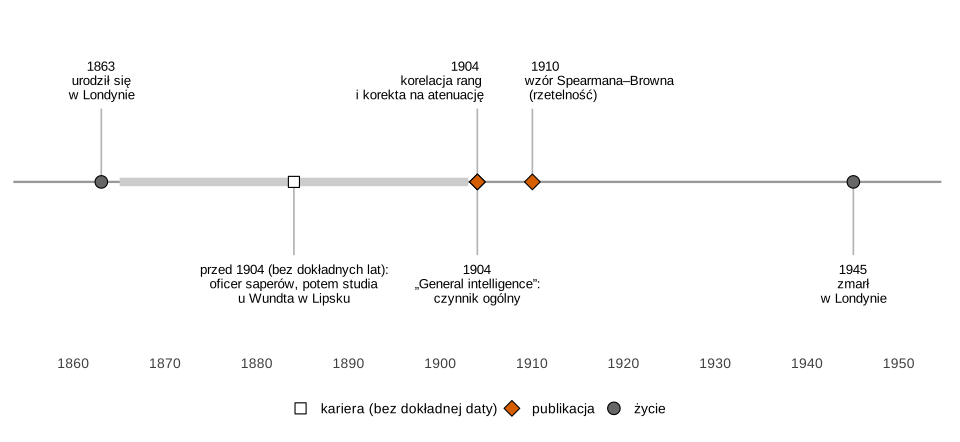
Co widać. Najważniejsze prace Spearman ogłosił po czterdziestce: w 1904 r. przedstawił naraz trzy pomysły, które przetrwały: korelację na rangach, korektę na atenuację i czynnik ogólny.
Na co uważać. Pas przed 1904 r. nie ma dat, bo dostępne nam źródła ich nie podają. Na osi brakuje też lat pracy w University College London i wyboru do Royal Society – nie udało się ich sprawdzić w cytowanych źródłach.
Podpis do pracy:
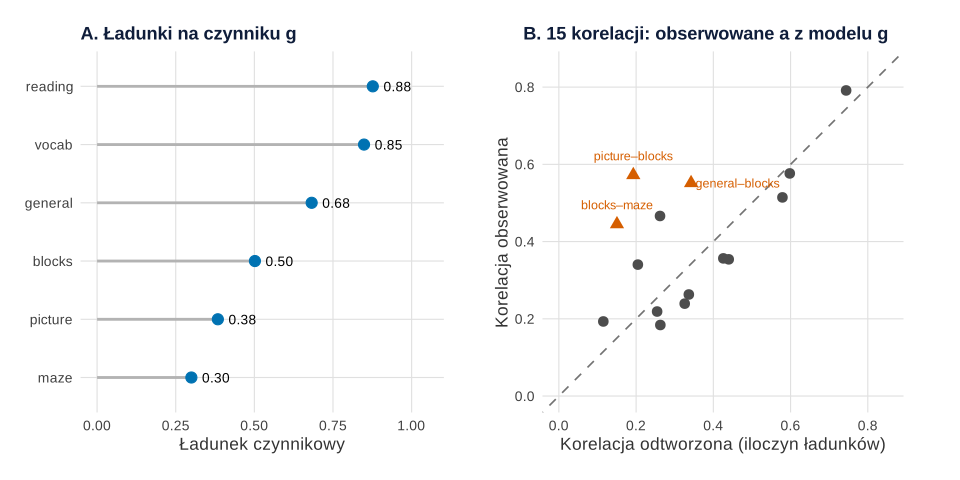
datasets::ability.cov, 112 osób): ładunki (A) i korelacje obserwowane a odtworzone przez czynnik (B). Obliczenia i rysunek: R, funkcja factanal(), pakiety ggplot2 i patchwork (dane rzeczywiste, bez losowania).Co widać. Panel A to „hierarchia” w duchu Spearmana: testy werbalne najsilniej wysycone czynnikiem wspólnym, labirynty najsłabiej. Panel B sprawdza, czy jeden czynnik wystarcza. Punkty na przekątnej to pary, których korelację g wyjaśnia; trójkąty nad przekątną to pary testów wykonawczych, które łączy coś więcej niż g.
Na co uważać. Ładunki zależą od zestawu testów: przy przewadze testów werbalnych czynnik „ogólny” staje się w dużej mierze werbalny. Ani rysunek, ani dobre dopasowanie modelu nie dowodzi, że g to jedna zdolność w mózgu – to tylko opis wspólnej wariancji testów.
Podpis do pracy:
Gdzie spotkasz Spearmana w swojej pracy
- Korelacja rang. Gdy zmienne są porządkowe albo związek jest monotoniczny, ale nie liniowy, liczysz ρ Spearmana zamiast r Pearsona; inną miarą na rangach jest tau Maurice’a Kendalla.
- Rzetelność skali. Rzetelność połówkowa i przewidywanie długości testu to wzór Spearmana–Browna, a teoria rzetelności korzysta z jego spostrzeżenia, że błąd pomiaru zaniża obserwowane korelacje; alfę – uogólnienie podejścia połówkowego – rozwinął potem Lee Cronbach.
- Korekta na atenuację. Gdy chcesz oszacować związek konstruktów, a nie skal, dzielisz korelację przez pierwiastek z iloczynu rzetelności; jak błąd pomiaru zaniża korelacje, pokazuje wpis Rzetelność i błąd pomiaru – wizualizacja.
- Analiza czynnikowa. Każda EFA i CFA skali kwestionariuszowej to potomek modelu z 1904 r.
Spory, mity i trudne strony
- Jeden czynnik czy wiele? Bartholomew (1995) ocenia, że niemal wyłączne skupienie Spearmana na czynniku ogólnym nie pozwoliło mu wykorzystać możliwości analizy czynnikowej; prowadzenie przejęli Thurstone i Thomson, autor wspomnienia o Spearmanie. Przykład wyżej pokazuje ten problem w małej skali: jeden czynnik nie wystarcza.
- Korelacja rang „Spearmana”. Sam Spearman nie przywiązywał do niej wagi (Lovie i Lovie, 1996), a w pracy z 1904 r. przedstawiał kilka sposobów liczenia związku na rangach. Dzisiejszy wzór z sumą kwadratów różnic rang to skrót rachunkowy korelacji Pearsona na rangach.
- g a spory o inteligencję. Czynnik ogólny opisuje wspólną wariancję testów, a nie jej przyczynę. Dyskusje o dziedziczeniu i różnicach grupowych, które później posługiwały się pojęciem g, wychodzą poza statystykę i poza to hasło.
Czynnik g Spearmana w R
Kod zamienia macierz kowariancji sześciu testów na korelacje, dopasowuje model z jednym czynnikiem wspólnym funkcją factanal(), porównuje korelacje obserwowane z iloczynami ładunków, testuje dopasowanie modelu z jednym i dwoma czynnikami i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje; położenie trzech podpisów na rysunku 2 ustawiono ręcznie, by się nie nakładały.
1. Jeden czynnik ogólny w sześciu testach: rysunek 2
Kod R rysunku 2
# Charles Spearman: czynnik g w sześciu testach zdolności (datasets::ability.cov, 112 osób)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(g = "#0072B2", akcent = "#D55E00", dane = "grey30")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))
data(ability.cov, package = "datasets")
R <- cov2cor(ability.cov$cov)                          # macierz korelacji sześciu testów
round(R, 2)
# Model jednoczynnikowy (jeden czynnik ogólny, jak u Spearmana); estymacja metodą największej wiarygodności
fa1 <- factanal(covmat = ability.cov, factors = 1)
l <- setNames(as.vector(fa1$loadings), rownames(fa1$loadings))
if (sum(l) < 0) l <- -l                                # znak czynnika jest dowolny
round(sort(l, decreasing = TRUE), 2)                    # ładunki na czynniku g – „hierarchia” testów
# Korelacje odtworzone przez jeden czynnik: r_ij ≈ l_i × l_j
odtw <- outer(l, l)
pary <- which(upper.tri(R), arr.ind = TRUE)
tab <- data.frame(para = paste(rownames(R)[pary[, 1]], rownames(R)[pary[, 2]], sep = "–"),
                  obserwowana = R[pary], z_czynnika_g = odtw[pary])
tab$reszta <- tab$obserwowana - tab$z_czynnika_g
tab <- tab[order(-abs(tab$reszta)), ]
print(head(transform(tab, obserwowana = round(obserwowana, 2), z_czynnika_g = round(z_czynnika_g, 2), reszta = round(reszta, 2)), 4),
      row.names = FALSE)
# Test dopasowania: czy jeden czynnik wystarcza? Dla porównania model z dwoma czynnikami
fa2 <- factanal(covmat = ability.cov, factors = 2)
round(c(chi2_1 = unname(fa1$STATISTIC), df_1 = fa1$dof, chi2_2 = unname(fa2$STATISTIC), df_2 = fa2$dof), 2)
signif(c(p_1czynnik = unname(fa1$PVAL), p_2czynniki = unname(fa2$PVAL)), 3)

# Rysunek 2A: ładunki na czynniku g; 2B: korelacje obserwowane a odtworzone przez g
dl <- data.frame(test = factor(names(l), levels = names(sort(l))), ladunek = l)
pA <- ggplot(dl, aes(ladunek, test)) +
  geom_segment(aes(x = 0, xend = ladunek, yend = test), colour = "grey70", linewidth = 1) +
  geom_point(size = 3.5, colour = kol[["g"]]) +
  geom_text(aes(label = sprintf("%.2f", ladunek)), hjust = -0.4, size = 3.6) +
  scale_x_continuous(limits = c(0, 1.05), breaks = seq(0, 1, 0.25)) +
  labs(title = "A. Ładunki na czynniku g", x = "Ładunek czynnikowy", y = NULL) +
  motyw
tab$etykieta <- ifelse(rank(-abs(tab$reszta)) <= 3, tab$para, "")   # trzy pary najgorzej odtworzone przez g
tab$poz_y <- tab$obserwowana + ifelse(tab$para == "general–blocks", 0, 0.05)
tab$poz_x <- tab$z_czynnika_g + ifelse(tab$para == "general–blocks", 0.12, 0)
pB <- ggplot(tab, aes(z_czynnika_g, obserwowana)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", colour = "grey45") +
  geom_point(aes(shape = etykieta != "", colour = etykieta != ""), size = 3, stroke = 1.1) +
  geom_text(aes(x = poz_x, y = poz_y, label = etykieta), size = 3.3, colour = kol[["akcent"]]) +
  scale_shape_manual(values = c(`FALSE` = 16, `TRUE` = 17), guide = "none") +
  scale_colour_manual(values = c(`FALSE` = kol[["dane"]], `TRUE` = kol[["akcent"]]), guide = "none") +
  coord_equal(xlim = c(0, 0.85), ylim = c(0, 0.85)) +
  labs(title = "B. 15 korelacji: obserwowane a z modelu g", x = "Korelacja odtworzona (iloczyn ładunków)", y = "Korelacja obserwowana") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.1))
p2
Wynik w R
        general picture blocks maze reading vocab
general    1.00    0.47   0.55 0.34    0.58  0.51
picture    0.47    1.00   0.57 0.19    0.26  0.24
blocks     0.55    0.57   1.00 0.45    0.35  0.36
maze       0.34    0.19   0.45 1.00    0.18  0.22
reading    0.58    0.26   0.35 0.18    1.00  0.79
vocab      0.51    0.24   0.36 0.22    0.79  1.00
reading   vocab general  blocks picture    maze
   0.88    0.85    0.68    0.50    0.38    0.30
            para obserwowana z_czynnika_g reszta
  picture–blocks        0.57         0.19   0.38
     blocks–maze        0.45         0.15   0.29
  general–blocks        0.55         0.34   0.21
 general–picture        0.47         0.26   0.20
chi2_1   df_1 chi2_2   df_2
 75.18   9.00   6.11   4.00
 p_1czynnik p_2czynniki
   1.46e-12    1.91e-01
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Charles Spearman, 1863–1945 – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1863, 1884, 1904, 1904, 1910, 1945),
  opis = c("urodził się\nw Londynie", "przed 1904 (bez dokładnych lat):\noficer saperów, potem studia\nu Wundta w Lipsku",
           "korelacja rang\ni korekta na atenuację", "„General intelligence”:\nczynnik ogólny",
           "wzór Spearmana–Browna\n(rzetelność)", "zmarł\nw Londynie"),
  rodzaj = c("życie", "kariera (bez dokładnej daty)", "publikacja", "publikacja", "publikacja", "życie"),
  strona = c(1, -1, 1, -1, 1, -1),
  wyrownanie = c(0.5, 0.5, 0.95, 0.5, 0.05, 0.5))   # rozsunięcie bliskich etykiet (1904 i 1910)
ksztalty <- c("życie" = 21, "kariera (bez dokładnej daty)" = 22, "publikacja" = 23)
kolory <- c("życie" = "grey40", "kariera (bez dokładnej daty)" = "white", "publikacja" = "#D55E00")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  annotate("segment", x = 1865, xend = 1903, y = 0, yend = 0, linewidth = 3, colour = "grey80") +   # okres przed 1904 (lata niepodane)
  geom_segment(aes(xend = rok, y = 0, yend = 0.55 * strona), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 4, colour = "black") +
  geom_text(aes(y = 0.62 * strona, label = ifelse(rodzaj == "kariera (bez dokładnej daty)", opis, paste0(rok, "\n", opis)),
                vjust = ifelse(strona > 0, 0, 1), hjust = wyrownanie), size = 3.5, lineheight = 0.9) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1858, 1950), breaks = seq(1860, 1950, by = 10)) +
  scale_y_continuous(limits = c(-1.15, 1.15)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (analiza czynnikowa – funkcja factanal() z pakietu stats; dane – pakiet datasets; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Charles Spearman?
Brytyjskim psychologiem (1863–1945), który przed karierą naukową był zawodowym oficerem saperów, a psychologii eksperymentalnej uczył się u Wundta w Lipsku. W 1904 r. opisał korelację na rangach, korektę na atenuację i czynnik ogólny g; należał do nielicznych psychologów w Royal Society.
Co to jest czynnik g Spearmana?
Wspólny czynnik, który według Spearmana (1904) leży u podstaw wszystkich rodzajów aktywności intelektualnej; obok niego każde zadanie ma elementy swoiste. Statystycznie to model z jednym czynnikiem wspólnym: korelacja dwóch testów powinna równać się iloczynowi ich ładunków.
Dlaczego korelacja rang nosi nazwisko Spearmana?
Bo w artykule z 1904 r. zalecał liczenie związku na rangach – m.in. współczynnika Pearsona na rangach – zwłaszcza w krótkich szeregach. Sam uważał to za drobny element swojej pracy, ale to z tego jest dziś najlepiej znany (Lovie i Lovie, 1996).
Skąd nazwa wzór Spearmana–Browna?
Od dwóch prac z 1910 r. w British Journal of Psychology: Spearmana o korelacji liczonej z danych obarczonych błędem i Browna o korelacji zdolności umysłowych. Wzór przewiduje rzetelność testu po wydłużeniu lub skróceniu, np. z rzetelności połówkowej.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikRzetelność i błąd pomiaru – wizualizacja
Wynik prawdziwy i błąd przy rzetelności .9/.7/.5, atenuacja w 1000 badań, alfa a liczba pozycji, nachylenie regresji i SEM – pięć rysunków z R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bartholomew, D. J. (1995). Spearman and the origin and development of factor analysis. British Journal of Mathematical and Statistical Psychology, 48(2), 211–220. https://doi.org/10.1111/j.2044-8317.1995.tb01060.x
- Lovie, A. D., & Lovie, P. (1996). Charles Edward Spearman, F.R.S. (1863–1945). Notes and Records of the Royal Society of London, 50(1), 75–88. https://doi.org/10.1098/rsnr.1996.0007
- Spearman, C. (1904a). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
- Spearman, C. (1904b). “General intelligence,” objectively determined and measured. The American Journal of Psychology, 15(2), 201–292. https://doi.org/10.2307/1412107
- Spearman, C. (1910). Correlation calculated from faulty data. British Journal of Psychology, 3(3), 271–295. https://doi.org/10.1111/j.2044-8295.1910.tb00206.x
- Thomson, G. H. (1947). Charles Spearman, 1863–1945. Obituary Notices of Fellows of the Royal Society, 5(15), 373–385. https://doi.org/10.1098/rsbm.1947.0006
Cytowania BibTeX
@article{bartholomew1995spearman, author={Bartholomew, David J.}, title={{Spearman and the origin and development of factor analysis}}, journal={British Journal of Mathematical and Statistical Psychology}, year={1995}, volume={48}, number={2}, pages={211--220}, doi={10.1111/j.2044-8317.1995.tb01060.x}}@article{lovie1996charles, author={Lovie, A. D. and Lovie, P.}, title={{Charles Edward Spearman, F.R.S. (1863–1945)}}, journal={Notes and Records of the Royal Society of London}, year={1996}, volume={50}, number={1}, pages={75--88}, doi={10.1098/rsnr.1996.0007}}@article{spearman1904proof, author={Spearman, Charles}, title={{The proof and measurement of association between two things}}, journal={The American Journal of Psychology}, year={1904}, volume={15}, number={1}, pages={72--101}, doi={10.2307/1412159}}@article{spearman1904general, author={Spearman, Charles}, title={{“General intelligence,” objectively determined and measured}}, journal={The American Journal of Psychology}, year={1904}, volume={15}, number={2}, pages={201--292}, doi={10.2307/1412107}}@article{spearman1910correlation, author={Spearman, Charles}, title={{Correlation calculated from faulty data}}, journal={British Journal of Psychology}, year={1910}, volume={3}, number={3}, pages={271--295}, doi={10.1111/j.2044-8295.1910.tb00206.x}}@article{thomson1947charles, author={Thomson, Godfrey H.}, title={{Charles Spearman, 1863–1945}}, journal={Obituary Notices of Fellows of the Royal Society}, year={1947}, volume={5}, number={15}, pages={373--385}, doi={10.1098/rsbm.1947.0006}}