Co to jest test Page’a?
Test Page’a (ang. Page’s L test, Page test for ordered alternatives) to nieparametryczny test trendu dla co najmniej trzech powiązanych pomiarów, np. tych samych osób w kolejnych tygodniach terapii. Hipoteza alternatywna jest kierunkowa: wyniki rosną (albo maleją) w porządku ustalonym przed analizą. Page (1963) zaproponował go dla hipotez uporządkowanych jako alternatywę dla testu Friedmana, który sprawdza tylko, czy pomiary w ogóle się różnią.
Jak działa
Najpierw nadaje się rangi w obrębie każdej osoby, tak jak u Friedmana (1937). Potem sumy rang Rj mnoży się przez numer pomiaru w przewidywanym porządku:
L = Σ j·Rj
Duże L oznacza, że wysokie rangi przypadają na późne pomiary. Przy prawdziwej hipotezie zerowej średnie L wynosi n·k(k + 1)²/4, gdzie n to liczba osób, a k – liczba pomiarów. Dla małych prób wartość p odczytuje się z rozkładu dokładnego, dla dużych – z przybliżenia normalnego. Test wystarcza na dane ze skali porządkowej.
Przykład
Dwanaście osób oceniło nastrój w czterech kolejnych tygodniach (dane symulowane). Średnie wyniosły 21.33, 20.75, 21.67 i 22.42, a sumy rang 26.5, 25.5, 30.5 i 37.5. Test Page’a dał L = 319 przy wartości oczekiwanej 300, p = .032. Test Friedmana na tych samych danych dał χ²(3) = 4.81, p = .186. Gdy przewidujemy kierunek, test trendu wykorzystuje tę informację i ma większą moc.
Na rysunku
Panel A rozpisuje dane z przykładu na rangi. Panel B to symulacja: cztery pomiary z rozkładu normalnego (SD = 1) plus stały poziom każdej osoby, 1000 powtórzeń dla każdej liczby osób (ziarno 5091 ustalone raz). Przesunięcia pomiarów ustawiono ręcznie: 0, 0.2, 0.4 i 0.6 SD dla trendu liniowego oraz 0, 0, 0 i 0.6 dla skoku w ostatnim pomiarze. Test Page’a jest jednostronny i liczony z przybliżenia normalnego.
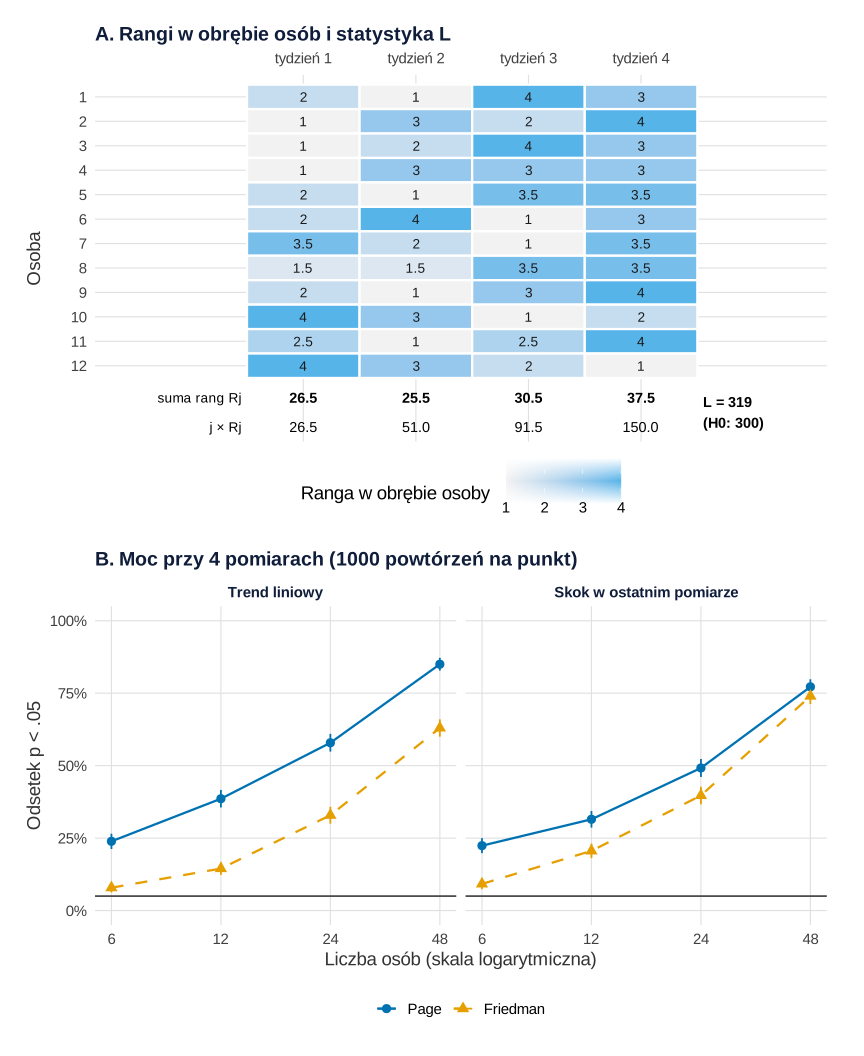
set.seed(509) i set.seed(5091)).Co widać. Test patrzy tylko na kolejność wyników w obrębie osoby. Rangi są tu bardzo „zaszumione”: tydzień 4 ma najwyższą rangę tylko u części osób, a osoba 12 ma wręcz trend malejący. Suma rang rośnie jednak od tygodnia 2 do 4, a mnożenie przez numer pomiaru daje późnym tygodniom największą wagę. Stąd L = 319 wobec 300 oczekiwanych przy braku trendu. W panelu B, przy trendzie liniowym test Page’a ma przy 24 osobach moc 57.9%, a test Friedmana 32.9% (błąd Monte Carlo do 1.6 punktu procentowego).
Na co uważać. Przewaga zależy od kształtu zmian. Wagi 1, 2, 3, 4 pasują do trendu liniowego. Przy skoku tylko w ostatnim pomiarze przewaga maleje i przy 48 osobach znika w granicach błędu (77.2% wobec 74.0%). Rysunek nie pokazuje wielkości zmiany w punktach skali: L mówi o kolejności, nie o tym, o ile wzrósł nastrój. Dlatego obok testu podaj średnie lub mediany pomiarów. Odpowiednik dla grup niezależnych i przypadek, w którym test trendu zawodzi (wzorzec odwróconego U), pokazuje rysunek w haśle test Jonckheere’a–Terpstry.
Podpis do pracy:
Kod rysunku odtwarza dane z przykładu i wykonuje symulację (8 tysięcy prób, kilkanaście sekund). Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Rangi w obrębie osób i statystyka L Page’a (A) oraz moc testu Page’a vs Friedmana (B)
library(ggplot2)
library(patchwork)

# Prosty motyw; kolory Okabe–Ito
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# A. Dane z przykładu w haśle (to samo ziarno i ten sam kod)
set.seed(509)
n <- 12; tydzien <- 1:4
y <- sapply(tydzien, function(t) round(20 + 0.8 * t + rnorm(n, 0, 2.5)))
rangi <- t(apply(y, 1, rank))                      # rangi w obrębie osoby (remisy = rangi średnie)
Rj <- setNames(colSums(rangi), paste0("R", tydzien)); L <- sum(tydzien * Rj)
print(c(Rj, L = L, E_L = n * 4 * (4 + 1)^2 / 4))

dA <- data.frame(osoba = rep(1:n, 4), tydzien = rep(tydzien, each = n), ranga = as.vector(rangi))
sumy <- data.frame(tydzien = tydzien, et1 = format(Rj), et2 = format(tydzien * Rj))
pA <- ggplot(dA, aes(tydzien, osoba)) +
  geom_tile(aes(fill = ranga), colour = "white", linewidth = 0.8) +
  geom_text(aes(label = ranga), size = 3.6, colour = "grey10") +
  geom_text(data = sumy, aes(y = n + 1.3, label = et1), size = 3.8, fontface = "bold") +
  geom_text(data = sumy, aes(y = n + 2.5, label = et2), size = 3.8) +
  annotate("text", x = 0.45, y = c(n + 1.3, n + 2.5), hjust = 1, size = 3.6,
           label = c("suma rang Rj", "j × Rj")) +
  annotate("text", x = 4.55, y = n + 1.9, hjust = 0, size = 3.8, fontface = "bold",
           label = paste0("L = ", L, "\n(H0: 300)")) +
  scale_fill_gradient(low = "#F2F2F2", high = "#56B4E9", name = "Ranga w obrębie osoby", breaks = 1:4) +
  scale_x_continuous(breaks = tydzien, labels = paste("tydzień", tydzien), expand = expansion(add = c(1.3, 1.1)), position = "top") +
  scale_y_reverse(breaks = 1:n, expand = expansion(add = c(0.6, 0.4))) +
  coord_cartesian(clip = "off") +
  labs(title = "A. Rangi w obrębie osób i statystyka L", x = NULL, y = "Osoba") +
  motyw + theme(panel.grid = element_blank())

# B. Symulacja mocy: L Page’a (przybliżenie normalne, jednostronnie) vs test Friedmana
page_p <- function(x) {                            # x: osoby w wierszach, pomiary w przewidywanym porządku
  b <- nrow(x); k <- ncol(x); L <- sum(1:k * colSums(t(apply(x, 1, rank))))
  E <- b * k * (k + 1)^2 / 4; V <- b * k^2 * (k + 1) * (k^2 - 1) / 144
  pnorm((L - E) / sqrt(V), lower.tail = FALSE)
}
wzorce <- list("Trend liniowy" = c(0, 0.2, 0.4, 0.6),   # przesunięcia w SD, ustawione ręcznie
               "Skok w ostatnim pomiarze" = c(0, 0, 0, 0.6))
set.seed(5091)                                     # ziarno ustalone raz
R <- 1000
wyn <- do.call(rbind, lapply(names(wzorce), function(w) do.call(rbind, lapply(c(6, 12, 24, 48), function(b) {
  p <- replicate(R, {
    x <- matrix(rnorm(b, 0, 1), b, 4) + matrix(wzorce[[w]], b, 4, byrow = TRUE) + matrix(rnorm(4 * b), b, 4)
    c(Page = page_p(x), Friedman = friedman.test(x)$p.value)
  })
  data.frame(wzorzec = w, osoby = b, test = c("Page", "Friedman"), moc = rowMeans(p < .05))
}))))
wyn$bladMC <- sqrt(wyn$moc * (1 - wyn$moc) / R)
wyn$wzorzec <- factor(wyn$wzorzec, levels = names(wzorce)); wyn$test <- factor(wyn$test, levels = c("Page", "Friedman"))
print(transform(wyn, moc = round(moc, 3), bladMC = round(bladMC, 3)), row.names = FALSE)

kol <- c(Page = "#0072B2", Friedman = "#E69F00")
pB <- ggplot(wyn, aes(osoby, moc, colour = test, shape = test, linetype = test)) +
  geom_hline(yintercept = 0.05, colour = "grey30") +
  geom_errorbar(aes(ymin = moc - 1.96 * bladMC, ymax = moc + 1.96 * bladMC), width = 0, linetype = 1) +
  geom_line(linewidth = 0.8) + geom_point(size = 2.8) +
  facet_wrap(~ wzorzec) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(trans = "log2", breaks = c(6, 12, 24, 48)) +
  scale_y_continuous(limits = c(0, 1), labels = function(x) paste0(100 * x, "%")) +
  labs(title = "B. Moc przy 4 pomiarach (1000 powtórzeń na punkt)",
       x = "Liczba osób (skala logarytmiczna)", y = "Odsetek p < .05") +
  motyw

p <- pA / pB + plot_layout(heights = c(1.15, 1))
p
Wynik w R
   R1    R2    R3    R4     L   E_L
 26.5  25.5  30.5  37.5 319.0 300.0
                  wzorzec osoby     test   moc bladMC
            Trend liniowy     6     Page 0.239  0.013
            Trend liniowy     6 Friedman 0.079  0.009
            Trend liniowy    12     Page 0.386  0.015
            Trend liniowy    12 Friedman 0.145  0.011
            Trend liniowy    24     Page 0.579  0.016
            Trend liniowy    24 Friedman 0.329  0.015
            Trend liniowy    48     Page 0.850  0.011
            Trend liniowy    48 Friedman 0.630  0.015
 Skok w ostatnim pomiarze     6     Page 0.224  0.013
 Skok w ostatnim pomiarze     6 Friedman 0.092  0.009
 Skok w ostatnim pomiarze    12     Page 0.315  0.015
 Skok w ostatnim pomiarze    12 Friedman 0.206  0.013
 Skok w ostatnim pomiarze    24     Page 0.492  0.016
 Skok w ostatnim pomiarze    24 Friedman 0.397  0.015
 Skok w ostatnim pomiarze    48     Page 0.772  0.013
 Skok w ostatnim pomiarze    48 Friedman 0.740  0.014
Jak opisać w pracy
Na co uważać
- Porządek z góry. Kolejność pomiarów i kierunek trendu ustal przed obejrzeniem danych. Dopasowanie porządku do wyników unieważnia p.
- Grupy niezależne. Dla różnych osób w uporządkowanych grupach służy test Jonckheere’a–Terpstry.
- Kształt trendu. Test wykrywa trend monotoniczny, ale nie mówi, czy jest liniowy. Parametryczną alternatywą jest kontrast liniowy w ANOVA z powtarzanymi pomiarami (zob. kontrasty planowane i analiza trendu).
- Remisy. Tablica rozkładu dokładnego w
PageTest()zakłada brak remisów. Przy wielu remisach w obrębie osób, np. przy jednej pozycji Likerta, p jest tylko przybliżone.
Test Page’a w R
Kod symuluje oceny 12 osób w czterech tygodniach, liczy sumy rang i porównuje test Page’a z funkcji PageTest() (pakiet DescTools) z testem Friedmana. Kolumny macierzy muszą być ułożone w przewidywanym porządku; dla k < 16 funkcja podaje jednostronne p z rozkładu dokładnego.
Trend w czterech pomiarach
R
library(DescTools)
set.seed(509)
n <- 12                                   # 12 osób, 4 kolejne tygodnie terapii
tydzien <- 1:4
y <- sapply(tydzien, function(t) round(20 + 0.8 * t + rnorm(n, 0, 2.5)))
colnames(y) <- paste0("t", tydzien)
round(colMeans(y), 2)
rowSums(apply(y, 1, rank))                # sumy rang tygodni (rangi w obrębie osoby)
n * 4 * (4 + 1)^2 / 4                     # oczekiwane L przy H0
PageTest(y)                               # H1: wyniki rosną z tygodnia na tydzień
friedman.test(y)                          # H1: jakakolwiek różnica
Wynik w R
   t1    t2    t3    t4
21.33 20.75 21.67 22.42
  t1   t2   t3   t4
26.5 25.5 30.5 37.5
[1] 300

	Page test for ordered alternatives

data:  y
L = 319, p-value = 0.03186


	Friedman rank sum test

data:  y
Friedman chi-squared = 4.8108, df = 3, p-value = 0.1862
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem DescTools 0.99.60. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym test Page’a różni się od testu Friedmana?
Oba rangują wyniki w obrębie osoby. Test Friedmana sprawdza, czy pomiary w ogóle się różnią, a test Page’a – czy rosną w przewidzianym porządku. W przykładzie: Page p = .032, Friedman p = .186.
Czy test Page’a jest jednostronny?
Tak. Hipoteza alternatywna wskazuje kierunek, np. wzrost z pomiaru na pomiar. Przy przewidywanym spadku odwróć kolejność kolumn, tak by trend był rosnący.
Kiedy zamiast testu Page’a użyć testu Jonckheere’a–Terpstry?
Gdy grupy są niezależne, np. różne osoby po 0, 4 i 8 sesjach. Test Page’a dotyczy tych samych osób mierzonych kilka razy albo innych bloków, np. dopasowanych trójek.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Testy nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikKontrasty planowane i analiza trendu
Od hipotez do wag kontrastów: trend liniowy i kwadratowy, kontrast interakcyjny, korekty, moc i tabela APA – na danych do pobrania, z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Friedman, M. (1937). The use of ranks to avoid the assumption of normality implicit in the analysis of variance. Journal of the American Statistical Association, 32(200), 675–701. https://doi.org/10.1080/01621459.1937.10503522
- Page, E. B. (1963). Ordered hypotheses for multiple treatments: A significance test for linear ranks. Journal of the American Statistical Association, 58(301), 216–230. https://doi.org/10.1080/01621459.1963.10500843
Cytowania BibTeX
@article{friedman1937use, author={Friedman, Milton}, title={{The use of ranks to avoid the assumption of normality implicit in the analysis of variance}}, journal={Journal of the American Statistical Association}, year={1937}, volume={32}, number={200}, pages={675--701}, doi={10.1080/01621459.1937.10503522}}@article{page1963ordered, author={Page, Ellis Batten}, title={{Ordered hypotheses for multiple treatments: A significance test for linear ranks}}, journal={Journal of the American Statistical Association}, year={1963}, volume={58}, number={301}, pages={216--230}, doi={10.1080/01621459.1963.10500843}}