Co to jest MRP?
MRP (multilevel regression and poststratification, żartobliwie „Mister P”) to metoda szacowania opinii w populacji i jej podgrupach, np. województwach, gdy próba jest mała lub niereprezentatywna. Park, Gelman i Bafumi (2004) połączyli model wielopoziomowy znany z szacowania dla małych obszarów z informacją o populacji wykorzystywaną w poststratyfikacji.
Dwa kroki metody
Regresja. Wielopoziomowa regresja logistyczna opisuje prawdopodobieństwo odpowiedzi w zależności od płci, wieku, wykształcenia i regionu. Kategorie mają efekty losowe, więc słabo obsadzone grupy są ściągane ku średniej.
Poststratyfikacja. Model przewiduje wynik dla każdej komórki tabeli populacji (np. 16 × 2 × 4 × 3 = 384 komórki), a przewidywania uśrednia się z wagami równymi liczebnościom komórek – w całym kraju albo osobno w każdym województwie.
Kiedy MRP, a kiedy wagi
Klasyczne wagi poststratyfikacyjne zawodzą, gdy komórek jest wiele, a w części brak respondentów; raking korzysta tylko z rozkładów brzegowych. MRP radzi sobie z pustymi komórkami i daje szacunki dla podgrup. Lax i Phillips (2009) pokazali, że na danych o opinii w stanach USA daje mniejsze błędy niż dezagregacja sondaży ogólnokrajowych, zwłaszcza przy małych próbach.
Przykład
W symulowanej populacji 51.7% osób popiera pewien pomysł. Próba 1200 osób nadreprezentuje młodych i lepiej wykształconych, więc surowy odsetek wynosi 61.5%. MRP daje 52.1%. Dla 16 województw (65–99 osób w każdym) pierwiastek błędu średniokwadratowego (RMSE) spada z 0.114 przy surowych odsetkach do 0.050.
Na rysunku
Rysunek pokazuje szacunki wojewódzkie z przykładu (set.seed(7190)). W symulacji znamy prawdziwy odsetek poparcia w każdym województwie, więc widać, jak daleko od niego leży surowy odsetek w próbie, a jak daleko szacunek MRP.
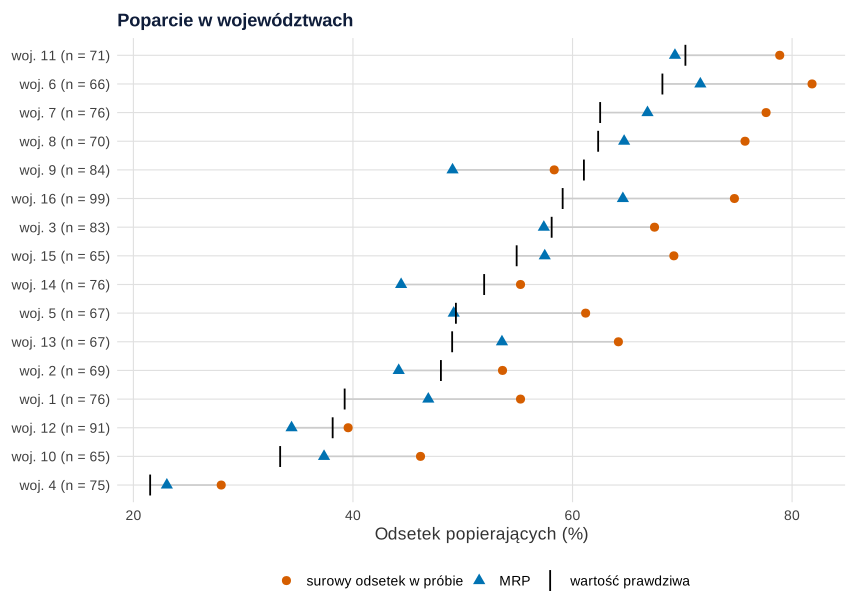
set.seed(7190)).Co widać. Surowy odsetek (kółko) leży powyżej wartości prawdziwej w 15 z 16 województw, średnio o 10.0 pp. To skutek doboru: w próbie jest za dużo młodych i lepiej wykształconych, którzy częściej popierają pomysł. Szacunki MRP (trójkąty) leżą po obu stronach kreski: 9 powyżej i 7 poniżej, a średni błąd wynosi 0.4 pp. MRP było bliżej prawdy w 13 z 16 województw, a największy błąd spadł z 16.0 do 12.0 pp.
Na co uważać. Mniejszy błąd przeciętny nie oznacza poprawy w każdym województwie. W województwach 9, 12 i 14 MRP było dalej od prawdy niż surowy odsetek, w województwie 9 o 12.0 pp zamiast 2.7 pp. Model usuwa przeciętne skrzywienie składu próby i ściąga województwa ku średniej. Województwo 9 ma wysoki prawdziwy odsetek, a jego próba przypadkiem wypadła nisko. Obie korekty przesunęły więc szacunek jeszcze niżej. W prawdziwym badaniu kresek nie widać. Dlatego szacunki wojewódzkie warto podawać z przedziałami niepewności (np. z bootstrapu) i nie układać z nich rankingów. Rysunek to wykres punktowy Clevelanda. Samo ściąganie ku średniej w modelu wielopoziomowym pokazuje wpis Model mieszany w obrazkach.
Podpis do pracy (w prawdziwym badaniu wartości prawdziwych nie znasz, więc na rysunku zostają kółka i trójkąty, a województwa porządkujesz według szacunku MRP):
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Odsetek poparcia w 16 województwach: surowy odsetek w próbie, MRP i wartość prawdziwa
suppressPackageStartupMessages({library(lme4); library(ggplot2)})

kol <- c("surowy odsetek w próbie" = "#D55E00", "MRP" = "#0072B2", "wartość prawdziwa" = "#000000")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(7190)                                   # populacja, próba i model jak w przykładzie w haśle
pop <- expand.grid(woj = factor(1:16), plec = c("K", "M"),
                   wiek = c("18-29", "30-44", "45-59", "60+"), wyk = c("podst", "sred", "wyzsze"))
pop$N <- rpois(nrow(pop), 4000 * c(1.2, 1, 1, 1.3)[as.integer(factor(pop$wiek))])
ef_woj <- rnorm(16, 0, 0.5)
pop$p <- plogis(-0.3 + ef_woj[pop$woj] + 0.3 * (pop$plec == "M") +
                c(0.6, 0.2, -0.2, -0.6)[as.integer(factor(pop$wiek))] +
                c(-0.4, 0, 0.5)[as.integer(factor(pop$wyk))])
szansa <- pop$N * c(3, 1.5, 1, 0.5)[as.integer(factor(pop$wiek))] *
          c(0.5, 1, 2.5)[as.integer(factor(pop$wyk))]
idx <- sample(nrow(pop), 1200, replace = TRUE, prob = szansa)
proba <- pop[idx, c("woj", "plec", "wiek", "wyk")]
proba$y <- rbinom(1200, 1, pop$p[idx])
m <- glmer(y ~ plec + (1 | woj) + (1 | wiek) + (1 | wyk), data = proba, family = binomial)
pop$pred <- predict(m, newdata = pop, type = "response")

wazona <- function(v) tapply(v * pop$N, pop$woj, sum) / tapply(pop$N, pop$woj, sum)
d <- data.frame(woj = levels(pop$woj), n = as.vector(table(proba$woj)),
                prawda = wazona(pop$p), surowa = as.vector(tapply(proba$y, proba$woj, mean)),
                mrp = wazona(pop$pred))
d$bl_surowa <- 100 * (d$surowa - d$prawda); d$bl_mrp <- 100 * (d$mrp - d$prawda)   # błąd w pp
round(c(surowa_powyzej_prawdy = sum(d$bl_surowa > 0), mrp_powyzej_prawdy = sum(d$bl_mrp > 0),
        sr_blad_surowa = mean(d$bl_surowa), sr_blad_mrp = mean(d$bl_mrp),
        max_abs_surowa = max(abs(d$bl_surowa)), max_abs_mrp = max(abs(d$bl_mrp)),
        mrp_blizej = sum(abs(d$bl_mrp) < abs(d$bl_surowa))), 1)
gorzej <- abs(d$bl_mrp) >= abs(d$bl_surowa)                 # gdzie MRP nie pomogło
print(data.frame(woj = d$woj, n = d$n, bl_surowa = round(d$bl_surowa, 1), bl_mrp = round(d$bl_mrp, 1))[gorzej, ],
      row.names = FALSE)

# Wykres punktowy: województwa uporządkowane według wartości prawdziwej
d$et <- factor(sprintf("woj. %s (n = %d)", d$woj, d$n), sprintf("woj. %s (n = %d)", d$woj, d$n)[order(d$prawda)])
dl <- rbind(data.frame(et = d$et, typ = "surowy odsetek w próbie", p = d$surowa),
            data.frame(et = d$et, typ = "MRP", p = d$mrp),
            data.frame(et = d$et, typ = "wartość prawdziwa", p = d$prawda))
dl$typ <- factor(dl$typ, names(kol))
p1 <- ggplot(dl, aes(100 * p, et)) +
  geom_line(aes(group = et), colour = "grey80") +
  geom_point(aes(colour = typ, shape = typ, size = typ)) +
  scale_colour_manual(NULL, values = kol) +
  scale_shape_manual(NULL, values = c(16, 17, 124)) + scale_size_manual(NULL, values = c(2.8, 2.8, 5.5)) +
  labs(title = "Poparcie w województwach", x = "Odsetek popierających (%)", y = NULL) + motyw
p1
Wynik w R
surowa_powyzej_prawdy    mrp_powyzej_prawdy        sr_blad_surowa
                 15.0                   9.0                  10.0
          sr_blad_mrp        max_abs_surowa           max_abs_mrp
                  0.4                  16.0                  12.0
           mrp_blizej
                 13.0
 woj  n bl_surowa bl_mrp
   9 84      -2.7  -12.0
  12 91       1.4   -3.8
  14 76       3.3   -7.6
Jak opisać w pracy
Na co uważać
- Tylko mierzone cechy. MRP koryguje dobór próby w takim zakresie, w jakim zależy on od zmiennych w modelu i tabeli populacji.
- Zgodne kategorie. Kategorie w ankiecie i w tabeli populacji muszą być identyczne.
- Niepewność. Szacunek punktowy to nie wszystko; margines błędu trzeba wyznaczyć np. bootstrapem, bo prosty wzór dla próby losowej tu nie działa.
- Mało poziomów. Efekt losowy dla zmiennej o 3–4 kategoriach jest słabo oszacowany; sprawdź wrażliwość, wpisując ją jako efekt stały.
Wagi krok po kroku omawia wpis Ważenie danych sondażowych krok po kroku.
MRP w R
Kod tworzy symulowaną populację w 384 komórkach, losuje z niej nielosową próbę, dopasowuje wielopoziomową regresję logistyczną lme4::glmer() i poststratyfikuje przewidywania – dla kraju i dla województw. Liczby w tekście pochodzą z tego kodu.
Regresja wielopoziomowa i poststratyfikacja
R
set.seed(7190)
library(lme4)
# Populacja (dane symulowane): 16 województw x płeć x 4 grupy wieku x 3 poziomy wykształcenia
pop <- expand.grid(woj = factor(1:16), plec = c("K", "M"),
                   wiek = c("18-29", "30-44", "45-59", "60+"), wyk = c("podst", "sred", "wyzsze"))
pop$N <- rpois(nrow(pop), 4000 * c(1.2, 1, 1, 1.3)[as.integer(factor(pop$wiek))])
ef_woj <- rnorm(16, 0, 0.5)
pop$p <- plogis(-0.3 + ef_woj[pop$woj] + 0.3 * (pop$plec == "M") +
                c(0.6, 0.2, -0.2, -0.6)[as.integer(factor(pop$wiek))] +
                c(-0.4, 0, 0.5)[as.integer(factor(pop$wyk))])
# Próba nielosowa: młodsi i lepiej wykształceni odpowiadają częściej
szansa <- pop$N * c(3, 1.5, 1, 0.5)[as.integer(factor(pop$wiek))] *
          c(0.5, 1, 2.5)[as.integer(factor(pop$wyk))]
idx <- sample(nrow(pop), 1200, replace = TRUE, prob = szansa)
proba <- pop[idx, c("woj", "plec", "wiek", "wyk")]
proba$y <- rbinom(1200, 1, pop$p[idx])
m <- glmer(y ~ plec + (1 | woj) + (1 | wiek) + (1 | wyk), data = proba, family = binomial)
print(VarCorr(m))
pop$pred <- predict(m, newdata = pop, type = "response")    # krok 1: przewidywanie w każdej komórce
mrp_kraj <- sum(pop$pred * pop$N) / sum(pop$N)              # krok 2: średnia ważona liczebnościami
round(c(prawda = sum(pop$p * pop$N) / sum(pop$N),
        surowa_proba = mean(proba$y), mrp = mrp_kraj), 3)
prawda_woj <- tapply(pop$p * pop$N, pop$woj, sum) / tapply(pop$N, pop$woj, sum)
mrp_woj <- tapply(pop$pred * pop$N, pop$woj, sum) / tapply(pop$N, pop$woj, sum)
surowa_woj <- tapply(proba$y, proba$woj, mean)
print(table(proba$woj))
rmse <- function(e) sqrt(mean((e - prawda_woj)^2))
round(c(rmse_surowa = rmse(surowa_woj), rmse_mrp = rmse(mrp_woj)), 3)
round(rbind(prawda = prawda_woj, surowa = surowa_woj, mrp = mrp_woj)[, 1:6], 2)
Wynik w R
 Groups Name        Std.Dev.
 woj    (Intercept) 0.66488
 wiek   (Intercept) 0.42752
 wyk    (Intercept) 0.37634
      prawda surowa_proba          mrp
       0.517        0.615        0.521

 1  2  3  4  5  6  7  8  9 10 11 12 13 14 15 16
76 69 83 75 67 66 76 70 84 65 71 91 67 76 65 99
rmse_surowa    rmse_mrp
      0.114       0.050
          1    2    3    4    5    6
prawda 0.39 0.48 0.58 0.22 0.49 0.68
surowa 0.55 0.54 0.67 0.28 0.61 0.82
mrp    0.47 0.44 0.57 0.23 0.49 0.72
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet lme4). Rysunek 1 przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czym MRP różni się od zwykłego ważenia poststratyfikacyjnego?
Ważenie przypisuje wagę każdej osobie i wymaga, by każda komórka miała wystarczająco wielu respondentów. MRP modeluje wynik w komórkach, więc małe i puste komórki dostają przewidywania pożyczone od podobnych grup.
Czego potrzeba do MRP?
Próby z odpowiedzią i cechami demograficznymi oraz tabeli liczebności populacji dla wszystkich kombinacji tych samych cech (np. z danych GUS lub spisu). Zmienne w modelu muszą mieć te same kategorie co tabela.
Czy MRP naprawi każdą próbę nielosową?
Nie. Usuwa obciążenie tylko w takim stopniu, w jakim wynik zależy od cech uwzględnionych w modelu i tabeli. Jeśli respondenci różnią się od reszty populacji czymś niemierzonym, szacunek nadal będzie obciążony.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Ważenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →PoradnikWielopoziomowa regresja logistyczna (GLMM)
glmer krok po kroku: ICC z π²/3 i MOR, ilorazy szans warunkowe a uśrednione, kwadratura, zbieżność, prawdopodobieństwa i wzór opisu APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Lax, J. R., & Phillips, J. H. (2009). How should we estimate public opinion in the states? American Journal of Political Science, 53(1), 107–121. https://doi.org/10.1111/j.1540-5907.2008.00360.x
- Park, D. K., Gelman, A., & Bafumi, J. (2004). Bayesian multilevel estimation with poststratification: State-level estimates from national polls. Political Analysis, 12(4), 375–385. https://doi.org/10.1093/pan/mph024
Cytowania BibTeX
@article{lax2009should, author={Lax, Jeffrey R. and Phillips, Justin H.}, title={{How should we estimate public opinion in the states?}}, journal={American Journal of Political Science}, year={2009}, volume={53}, number={1}, pages={107--121}, doi={10.1111/j.1540-5907.2008.00360.x}}@article{park2004bayesian, author={Park, David K. and Gelman, Andrew and Bafumi, Joseph}, title={{Bayesian multilevel estimation with poststratification: State-level estimates from national polls}}, journal={Political Analysis}, year={2004}, volume={12}, number={4}, pages={375--385}, doi={10.1093/pan/mph024}}