Co to jest metoda momentów?
Metoda momentów (ang. method of moments, MM) to sposób estymacji punktowej, w którym teoretyczne momenty rozkładu – średnią, wariancję, czasem wyższe – przyrównuje się do ich odpowiedników z próby i rozwiązuje powstałe równania względem parametrów. Gdy model ma k parametrów, potrzeba k równań. Pearson (1894) użył tego podejścia, żeby rozłożyć skośną krzywą częstości na dwie krzywe normalne, i musiał w tym celu policzyć wyższe momenty.
Jak liczyć
W rozkładzie gamma z kształtem k i tempem λ średnia wynosi k/λ, a wariancja k/λ². Po przyrównaniu do średniej z próby x̄ i wariancji z próby s² (dzielonej przez n) otrzymujemy:
λ̂ = x̄ / s², k̂ = x̄² / s²
Casella i Berger (2002) opisują ją w podręczniku jako pierwszą z metod znajdowania estymatorów, przed ML. Nie wymaga optymalizacji numerycznej, dlatego oszacowania MM często służą jako wartości startowe dla metody największej wiarygodności (ML).
Przykład w R
Dla 40 symulowanych czasów oczekiwania (w populacji k = 2, λ = 0.25) średnia wyniosła 9.24 min, a wariancja 41.33. Metoda momentów dała k̂ = 2.07 i λ̂ = 0.224, a ML – k̂ = 1.87 i λ̂ = 0.203. W 2000 powtórzeniach SD oszacowań kształtu wyniosło 0.621 dla MM i 0.511 dla ML.
Na rysunku
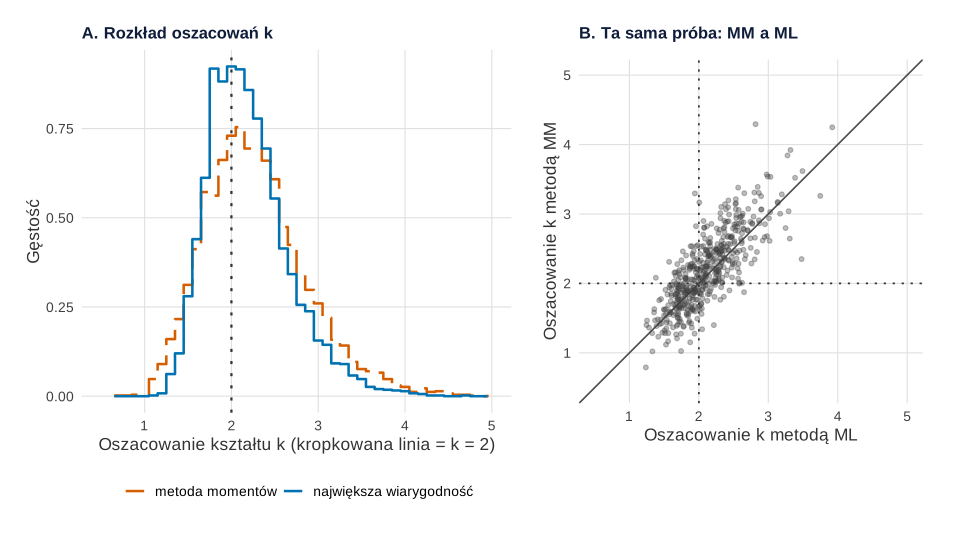
set.seed(5052)).Co widać. Symulacja losuje 5000 prób po 40 obserwacji z tego samego rozkładu gamma co w przykładzie (k = 2, λ = 0.25) i w każdej szacuje kształt obiema metodami. Oba rozkłady oszacowań (panel A) są prawoskośne i przesunięte w prawo od k = 2: średnia wynosi 2.23 dla metody momentów i 2.15 dla ML. Rozkład MM jest szerszy (SD 0.587 wobec 0.468), a pierwiastek z błędu średniokwadratowego większy (0.630 wobec 0.491), więc ML wygrywa i mniejszym obciążeniem, i mniejszym rozrzutem. Panel B pokazuje, że w tej samej próbie obie metody dają podobne wyniki (korelacja 0.81), ale punkty rozchodzą się głównie w pionie, wzdłuż osi MM: ML było bliżej prawdziwego k w 62.4% prób (błąd Monte Carlo ±0.7 pp). Parametry rozkładu i n wzięto z przykładu; ziarna nie zmieniano.
Na co uważać. Przewaga ML dotyczy sytuacji, w której model gamma jest prawdziwy. Rysunek nie pokazuje, co się dzieje, gdy dane pochodzą z innego rozkładu albo zawierają obserwacje odstające: wtedy obie metody szacują parametr złego modelu, a MM, oparta na wariancji z próby, mocno reaguje na pojedyncze skrajne wartości. Przewaga 62% to też nie pewność – w ponad jednej trzeciej prób bliżej prawdy była metoda momentów. Przy 40 obserwacjach obie metody średnio zawyżają kształt, więc mały błąd jednej metody nie znaczy braku obciążenia. Porównanie rozrzutu estymatorów jako ich efektywności rozwija hasło efektywność estymatora.
Podpis do pracy:
Kod rysunku losuje dane z ustalonym ziarnem set.seed(5052) i liczy się kilka sekund. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Kształt k rozkładu gamma: metoda momentów (MM) a ML w 5000 próbach po n = 40
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("metoda momentów" = "#D55E00", "największa wiarygodność" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

k <- 2; tempo <- 0.25; n <- 40; R <- 5000    # jak w przykładzie: czas oczekiwania, k = 2, λ = 0.25
set.seed(5052)
est <- t(replicate(R, {
  y <- rgamma(n, shape = k, rate = tempo)
  m <- mean(y); v <- mean((y - m)^2)           # momenty z próby (wariancja przez n)
  c(MM = m^2 / v,
    ML = suppressWarnings(MASS::fitdistr(y, "gamma")$estimate[["shape"]]))  # ML (pakiet MASS)
}))

# Średnia, obciążenie, SD i pierwiastek z MSE; odsetek prób, w których ML jest bliżej k niż MM
podsum <- data.frame(metoda = c("MM", "ML"), srednia = colMeans(est), obciazenie = colMeans(est) - k,
                     SD = apply(est, 2, sd), RMSE = sqrt(colMeans((est - k)^2)), row.names = NULL)
print(format(podsum, digits = 3), row.names = FALSE)
ml_blizej <- mean(abs(est[, "ML"] - k) < abs(est[, "MM"] - k))
round(c(proc_ML_blizej = 100 * ml_blizej, blad_MC_pp = 100 * sqrt(ml_blizej * (1 - ml_blizej) / R),
        korelacja_MM_ML = cor(est[, "MM"], est[, "ML"])), 2)

# Panel A: rozkłady oszacowań k (histogramy schodkowe co 0.1); przerywana linia = prawdziwe k = 2
dl <- data.frame(metoda = factor(rep(names(kol), each = R), levels = names(kol)),
                 wartosc = c(est[, "MM"], est[, "ML"]))
pA <- ggplot(dl, aes(wartosc, colour = metoda, linetype = metoda)) +
  stat_bin(aes(y = after_stat(density)), geom = "step", position = "identity",
           binwidth = 0.1, boundary = 0, linewidth = 0.9) +
  geom_vline(xintercept = k, linetype = "dotted", colour = "grey20", linewidth = 0.8) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("metoda momentów" = "longdash", "największa wiarygodność" = "solid"), name = NULL) +
  coord_cartesian(xlim = c(0.5, 5)) +
  labs(title = "A. Rozkład oszacowań k", x = "Oszacowanie kształtu k (kropkowana linia = k = 2)", y = "Gęstość") +
  motyw

# Panel B: te same próby, oszacowanie MM względem ML (co dziesiąta próba); przekątna = równe oszacowania
co10 <- seq(1, R, by = 10)
pB <- ggplot(data.frame(ML = est[co10, "ML"], MM = est[co10, "MM"]), aes(ML, MM)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey30") +
  geom_point(alpha = 0.35, size = 1.3, colour = "grey25") +
  geom_hline(yintercept = k, linetype = "dotted", colour = "grey20") +
  geom_vline(xintercept = k, linetype = "dotted", colour = "grey20") +
  coord_equal(xlim = c(0.5, 5), ylim = c(0.5, 5)) +
  labs(title = "B. Ta sama próba: MM a ML", x = "Oszacowanie k metodą ML", y = "Oszacowanie k metodą MM") +
  motyw

p <- pA + pB + plot_layout(widths = c(1.25, 1))
p
Wynik w R
 metoda srednia obciazenie    SD  RMSE
     MM    2.23      0.231 0.587 0.630
     ML    2.15      0.147 0.468 0.491
 proc_ML_blizej      blad_MC_pp korelacja_MM_ML
          62.36            0.69            0.81
Jak opisać w pracy
Na co uważać
- Mniejsza precyzja. Estymatory MM są zwykle zgodne, ale bywają mniej efektywne niż ML – w przykładzie SD było o około 20% większe (zob. efektywność estymatora).
- Wartości spoza zakresu. Przy małych próbach równania mogą dać ujemną wariancję albo niedopuszczalny parametr.
- Wyższe momenty są niestabilne. Skośność i kurtoza z próby silnie reagują na obserwacje odstające, więc oszacowania oparte na nich mają duży rozrzut.
- Brak momentów. Gdy rozkład nie ma średniej (np. rozkład Cauchy’ego), metody nie da się zastosować.
Metoda momentów w R
Kod szacuje parametry rozkładu gamma metodą momentów i metodą największej wiarygodności (fitdistr() z pakietu MASS), a potem w 2000 symulacjach porównuje rozrzut oszacowań kształtu.
Rozkład gamma: MM a ML
R
library(MASS)
set.seed(505)
x <- rgamma(40, shape = 2, rate = 0.25)    # czas oczekiwania (min), prawda: k = 2, rate = 0.25
m <- mean(x); v <- mean((x - m)^2)         # momenty z próby (wariancja przez n)
c(srednia = m, wariancja = v)
c(k_MM = m^2 / v, rate_MM = m / v)         # metoda momentów
suppressWarnings(fitdistr(x, "gamma"))$estimate  # metoda największej wiarygodności
# efektywność: 2000 prób po n = 40
sym <- replicate(2000, {
  y <- rgamma(40, shape = 2, rate = 0.25)
  my <- mean(y); vy <- mean((y - my)^2)
  c(MM = my^2 / vy,
    ML = suppressWarnings(fitdistr(y, "gamma")$estimate[["shape"]]))
})
round(apply(sym, 1, sd), 3)                # SD oszacowań k
Wynik w R
  srednia wariancja
 9.239252 41.333779
     k_MM   rate_MM
2.0652305 0.2235279
   shape     rate
1.873535 0.202780
   MM    ML
0.621 0.511
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem MASS 7.3-65 (funkcja fitdistr()). Rysunek 1 wykonano w pakietach ggplot2 i patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Ile momentów trzeba użyć w metodzie momentów?
Tyle, ile parametrów ma rozkład. Dla rozkładu Poissona wystarczy średnia, dla rozkładu normalnego i gamma potrzebne są średnia i wariancja, a dla rozkładów z trzema parametrami także moment trzeciego rzędu.
Czy metoda momentów i metoda największej wiarygodności mogą dać ten sam wynik?
Tak. W rozkładzie normalnym obie metody dają średnią z próby i wariancję dzieloną przez n, a w rozkładzie Poissona – średnią. W rozkładzie gamma wyniki się różnią i ML jest zwykle precyzyjniejsza.
Kiedy warto użyć metody momentów zamiast ML?
Gdy potrzebujesz szybkiego oszacowania bez optymalizacji, np. jako wartości startowej dla ML, w dużych próbach albo gdy funkcja wiarygodności jest trudna do zapisania lub maksymalizacji.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Casella, G., & Berger, R. L. (2002). Statistical inference (2nd ed.). Thomson Learning.
- Pearson, K. (1894). Contributions to the mathematical theory of evolution. Philosophical Transactions of the Royal Society of London. A, 185(185), 71–110. https://doi.org/10.1098/rsta.1894.0003 ● Otwarty dostęp
Cytowania BibTeX
@book{casella2002statistical, author={Casella, George and Berger, Roger L.}, title={{Statistical inference (2nd ed.)}}, year={2002}, publisher={Thomson Learning}}@article{pearson1894contributions, author={Pearson, Karl}, title={{Contributions to the mathematical theory of evolution}}, journal={Philosophical Transactions of the Royal Society of London. A}, year={1894}, volume={185}, number={185}, pages={71--110}, doi={10.1098/rsta.1894.0003}}