Kim był Jum C. Nunnally?
Jum Clarence Nunnally Jr. (1924–1982) był amerykańskim psychologiem i psychometrą, autorem podręcznika Psychometric Theory, z którego kilka pokoleń badaczy uczyło się teorii pomiaru. Urodził się 1 lutego 1924 r. w Birmingham w stanie Alabama. Po szkole średniej (1942) służył jako oficer lotnictwa armii USA, w 1946 r. zaczął studia w Birmingham-Southern College, a w 1949 r. – na Uniwersytecie Chicagowskim, gdzie w 1952 r. obronił doktorat. W latach 1954–1960 wykładał na Uniwersytecie Illinois, a ostatnie dwie dekady życia spędził na Uniwersytecie Vanderbilta, gdzie dwukrotnie kierował katedrą psychologii (1961–1964 i 1967–1970). Napisał lub współtworzył osiem książek i ponad 120 artykułów, raportów i rozdziałów (Brown, 1983). Zmarł na raka 22 sierpnia 1982 r. (Blanton i Kotsch, 1985).
Najważniejsze pomysły
- Psychometric Theory (1967, 1978). Podręcznik klasycznej teorii testu, z którego pochodzą najczęściej powtarzane zalecenia dotyczące rzetelności. Pierwsze wydanie ukazało się w 1967 r., drugie w 1978 r., a trzecie – już po śmierci autora – w 1994 r., ze współautorem Irą H. Bernsteinem (według katalogu bibliotecznego).
- Rzetelność zależna od celu. Nunnally nie podał jednej „dobrej” wartości współczynnika rzetelności. Według dosłownych cytatów u Coopera i in. (2017) w wydaniu z 1978 r. nazywa .70 rzetelnością skromną, wystarczającą we wczesnych etapach badań, .80 – adekwatną w badaniach podstawowych, a .90 – minimum, gdy na podstawie konkretnych wyników podejmuje się ważne decyzje.
- Długość testu. Cooper i in. (2017) przywołują Nunnally’ego jako klasyczne źródło zasady, że dłuższy test to mniejszy udział błędu losowego w wyniku; ilościowo opisuje to wzór Spearmana–Browna, który Kuder i Richardson pokazali jako szczególny przypadek swojej teorii (zob. Kuder i Richardson).
- Wyobrażenia o zdrowiu psychicznym. Znany był też z książki Popular Conceptions of Mental Health (1961) o społecznych postawach wobec chorób psychicznych; pisał też o analizie czynnikowej i innych zagadnieniach pomiaru (Blanton i Kotsch, 1985).
Ciekawostka
Zanim Nunnally zajął się pomiarem, latał. Według wspomnienia Browna (1983) po szkole średniej służył w Army Air Corps jako pilot samolotów transportowych, a na studia poszedł dopiero po wojnie.
Jego pierwsza głośna praca nie dotyczyła testów. Jako doktorant w Chicago współpracował z Williamem Stephensonem, twórcą techniki Q (badany porządkuje zestaw stwierdzeń, a badacz koreluje i analizuje czynnikowo te uporządkowania). Wykonał nią badanie jednej z pacjentek Carla Rogersa, opublikowane w 1955 r. jako „The Case of Miss Sun” – według Browna jedno z pierwszych i najbardziej znanych badań pojedynczego przypadku w terapii skoncentrowanej na kliencie. Podręcznik Introduction to Psychological Measurement (1970) zadedykował Stephensonowi.
Przykład na danych z pakietu R
Zbiór Science z pakietu ltm to – według pliku pomocy – odpowiedzi 392 respondentów z Wielkiej Brytanii z Eurobarometru 1992 na stwierdzenia o nauce i technice, na czterostopniowej skali od „zdecydowanie się nie zgadzam” do „zdecydowanie się zgadzam”. Bierzemy cztery stwierdzenia sformułowane pozytywnie (nauka czyni życie wygodniejszym, praca będzie ciekawsza, przyszłe pokolenia będą miały więcej możliwości, korzyści przeważają nad szkodami) i traktujemy je jak krótką skalę Likerta.
Alfa Cronbacha wynosi .598 (standaryzowana .603), a średnia korelacja między pozycjami .275 – skala nie przekracza nawet progu .70. Czy wzór Spearmana–Browna dobrze tu działa? Średnia alfa standaryzowana wszystkich par pozycji to .424 (wzór przewiduje .432), a trójek – .530 (wzór: .532). Odwracając wzór, liczymy, ile pozycji tej samej jakości trzeba, żeby dojść do kolejnych progów: 7 do .70, 11 do .80, 24 do .90 i 51 do .95. Różnica między „badaniem wstępnym” a „decyzją o osobie” to w tym przypadku ponad trzykrotnie dłuższy kwestionariusz.
Co daje rzetelność .90 zamiast .70? Weźmy wybór 10% osób z najwyższymi wynikami (np. do programu albo do dalszej diagnozy) i załóżmy, że wynik prawdziwy i obserwowany mają rozkład normalny, a ich korelacja to pierwiastek z rzetelności. Przy rzetelności .70 tylko 60.4% wskazanych osób naprawdę należy do najlepszych 10%; przy .80 – 68.0%, przy .90 – 77.6%, przy .95 – 84.3%. To rachunek dokładny (całkowanie numeryczne), nie symulacja.
Na rysunku
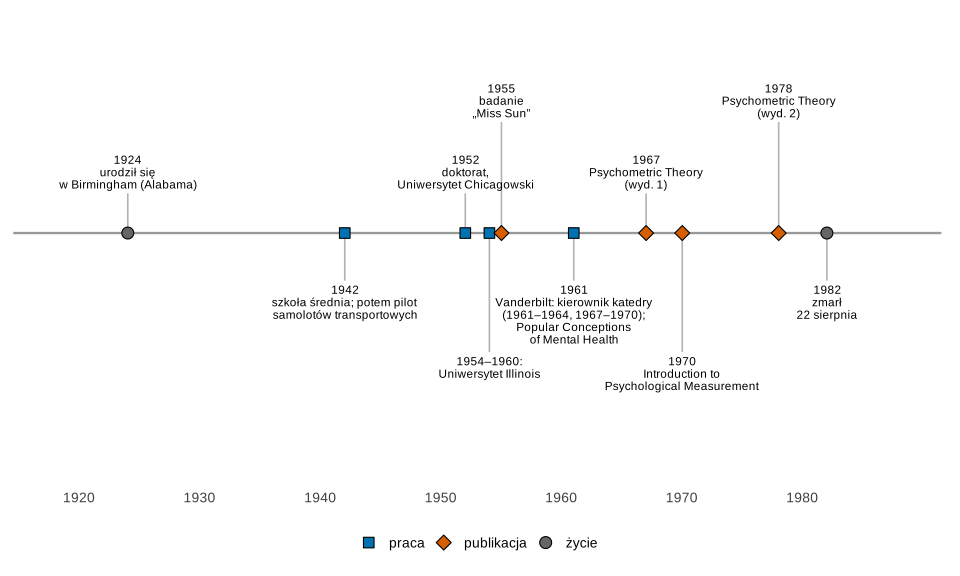
Co widać. Cała kariera akademicka Nunnally’ego zmieściła się w 30 latach po doktoracie; oba wydania Psychometric Theory powstały w Vanderbilt.
Na co uważać. Brown (1983) pisze o „ostatnich dwóch dekadach” w Vanderbilt i podaje rok objęcia kierownictwa katedry (1961), ale nie dokładną datę przejścia z Illinois; na osi Vanderbilt zaczyna się od 1961.
Podpis do pracy:
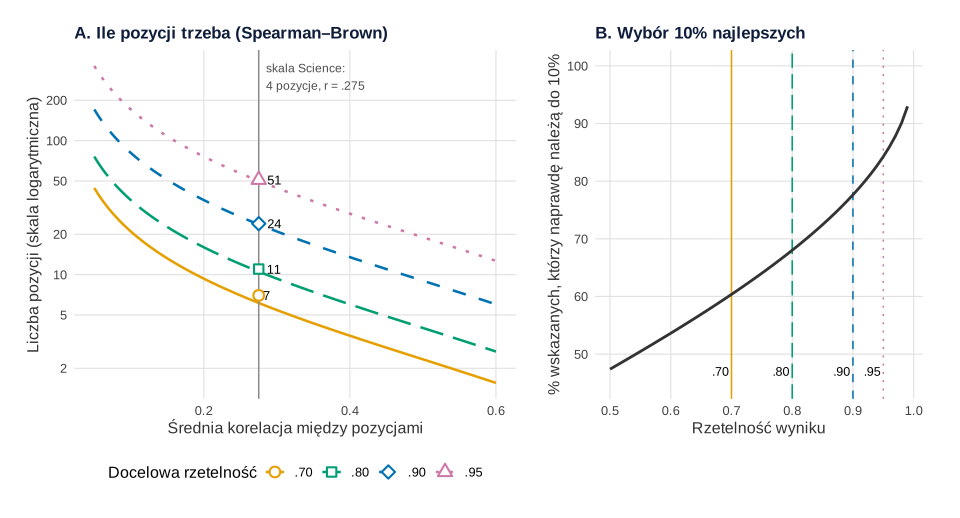
ltm::Science, cztery pozycje, n = 392. Panel B – rachunek dla rozkładu normalnego. Obliczenia i rysunek: R, pakiety psych, ggplot2 i patchwork (bez losowania).Co widać. W panelu A przy słabo skorelowanych pozycjach wymagana długość skali rośnie gwałtownie, a każdy kolejny próg kosztuje więcej pozycji niż poprzedni. Panel B pokazuje, dlaczego Nunnally żądał .90 przy decyzjach o osobach: przy .70 prawie 40% osób, które naprawdę należą do najlepszych 10%, zostaje pominiętych.
Na co uważać. Wzór Spearmana–Browna zakłada, że nowe pozycje są tak samo dobre jak dotychczasowe; w praktyce długie skale męczą badanych. Panel B zakłada rozkład normalny i jeden próg odcięcia.
Podpis do pracy:
Gdzie spotkasz Nunnally’ego w swojej pracy
Najczęściej w jednym zdaniu metodologii: „rzetelność skali przekroczyła zalecany próg .70 (Nunnally, 1978)”. Jak korzystać z tego odwołania uczciwie:
- dopasuj próg do celu: badanie wstępne, badanie podstawowe czy decyzja o konkretnej osobie; przy diagnozie i selekcji ważniejszy od samego współczynnika jest standardowy błąd pomiaru;
- gdy skala ma niską alfę, sprawdź najpierw pozycje (analiza pozycji testu), a potem policz, ile podobnych pozycji trzeba by dodać – podpowiedzi we wpisie Alfa Cronbacha poniżej .70;
- pamiętaj, że niska rzetelność obniża korelacje z innymi zmiennymi (korekta na atenuację);
- alfa to tylko jedna z miar; szerzej w hasłach o spójności wewnętrznej i omedze McDonalda oraz w biogramach Lee Cronbacha i Rodericka McDonalda.
Spory, mity i trudne strony
- „Próg .70 według Nunnally’ego”. W wielu pracach .70 występuje jako uniwersalna granica „akceptowalnej” rzetelności z odwołaniem do Nunnally’ego (1978). Tymczasem – jak pokazują cytowane dosłownie fragmenty (Cooper i in., 2017) – .70 to u niego rzetelność „skromna”, dobra na wczesnym etapie badań, a do badań podstawowych proponował .80, do ważnych decyzji o osobach – co najmniej .90. Lance, Butts i Michels (2006) prześledzili cztery często cytowane progi odcięcia do ich rzekomych źródeł i znaleźli w nich tylko częściowe prawdy; zalecają sprawdzanie, co źródło naprawdę mówi.
- Próg to nie dowód jakości. Rzetelność rośnie z liczbą pozycji (przykład), więc długa skala z przeciętnymi pozycjami łatwo przekroczy .70, a krótka, sensowna skala – nie.
- Które wydanie? W literaturze krążą odwołania do wydań z 1967, 1978 i 1994 r.; cytuj to wydanie i tę stronę, które naprawdę sprawdziłeś.
Progi rzetelności i wzór Spearmana–Browna w R
Kod wczytuje dane Science, liczy alfę i średnią korelację czterech pozycji, sprawdza wzór Spearmana–Browna na wszystkich parach i trójkach pozycji, wyznacza liczbę pozycji potrzebną do progów .70–.95, liczy (całkowaniem numerycznym) trafność wyboru 10% najlepszych przy różnej rzetelności i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu. Kod nie losuje.
1. Liczba pozycji i decyzje: rysunek 2
Kod R rysunku 2
# Nunnally: ile pozycji potrzeba do rzetelności .70, .80, .90 i co te progi znaczą przy decyzjach (ltm::Science)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(`.70` = "#E69F00", `.80` = "#009E73", `.90` = "#0072B2", `.95` = "#CC79A7")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(Science, package = "ltm")
# Eurobarometr 1992, Wielka Brytania, n = 392; 4 kategorie od „strongly disagree” do „strongly agree”.
# Bierzemy cztery stwierdzenia sformułowane pozytywnie (nauka i technika czynią życie lepszym)
X <- sapply(Science[, c("Comfort", "Work", "Future", "Benefit")], as.integer)
R <- cor(X); k0 <- ncol(X)
r_sr <- mean(R[lower.tri(R)])                              # średnia korelacja między pozycjami
alfa <- psych::alpha(X, warnings = FALSE)$total
round(c(n = nrow(X), alfa = alfa$raw_alpha, alfa_stand = alfa$std.alpha, r_sr = r_sr), 3)

# 1. Wzór Spearmana–Browna: rzetelność skali z k pozycjami przy średniej korelacji r
sb <- function(k, r) k * r / (1 + (k - 1) * r)
# sprawdzenie na danych: średnia alfa standaryzowana wszystkich podzbiorów 2 i 3 pozycji vs przewidywanie
alfa_st <- function(idx) { rr <- R[idx, idx]; m <- mean(rr[lower.tri(rr)]); sb(length(idx), m) }
podzbiory <- sapply(2:3, function(m) mean(apply(combn(k0, m), 2, alfa_st)))
round(rbind(dane = c(k2 = podzbiory[1], k3 = podzbiory[2], k4 = alfa$std.alpha),
            wzor = sb(2:4, r_sr)), 3)

# 2. Odwrócony wzór: ile pozycji o tej samej jakości trzeba, by osiągnąć próg
ile_pozycji <- function(cel, r) ceiling(cel * (1 - r) / (r * (1 - cel)))
progi <- c(0.70, 0.80, 0.90, 0.95)
data.frame(prog = progi, pozycji = ile_pozycji(progi, r_sr), rzetelnosc = round(sb(ile_pozycji(progi, r_sr), r_sr), 3))

# 3. Decyzja o osobie: próg odcięcia na górnych 10% (wynik prawdziwy T i obserwowany X standaryzowane, cor = sqrt(rxx))
blad_klasyfikacji <- function(rxx, kwantyl = 0.90) {
  c0 <- qnorm(kwantyl); rho <- sqrt(rxx)
  # P(T > c0 i X <= c0): osoba naprawdę powyżej progu, a wynik obserwowany poniżej
  pominieci <- integrate(function(t) dnorm(t) * pnorm((c0 - rho * t) / sqrt(1 - rho^2)), c0, Inf)$value
  c(pominieci = pominieci, trafnie_wskazani = 1 - pominieci / (1 - kwantyl))   # rozkłady T i X są takie same
}
siatka <- data.frame(rxx = seq(0.50, 0.99, by = 0.01))
siatka <- cbind(siatka, t(sapply(siatka$rxx, blad_klasyfikacji)))
round(siatka[siatka$rxx %in% c(0.6, progi, 0.99), ], 3)

# Rysunek: A – liczba pozycji potrzebna do progu w funkcji średniej korelacji; B – trafność wskazania górnych 10%
krzywe <- expand.grid(r = seq(0.05, 0.60, by = 0.005), prog = progi)
krzywe$k <- with(krzywe, prog * (1 - r) / (r * (1 - prog)))
krzywe$prog <- factor(sub("^0", "", sprintf("%.2f", krzywe$prog)), levels = names(kol))
punkty <- data.frame(r = r_sr, k = ile_pozycji(progi, r_sr), prog = factor(names(kol), levels = names(kol)))
pA <- ggplot(krzywe, aes(r, k, colour = prog, linetype = prog)) +
  geom_line(linewidth = 0.9) +
  geom_vline(xintercept = r_sr, colour = "grey55") +
  geom_point(data = punkty, aes(shape = prog), size = 3, fill = "white", stroke = 1.1) +
  geom_text(data = punkty, aes(label = k), colour = "black", hjust = -0.6, size = 3.4) +
  annotate("text", x = r_sr + 0.01, y = 300, hjust = 0, size = 3.2, colour = "grey30",
           label = sprintf("skala Science:\n4 pozycje, r = %s", sub("^0", "", sprintf("%.3f", r_sr)))) +
  scale_y_log10(breaks = c(1, 2, 5, 10, 20, 50, 100, 200, 500)) +
  scale_colour_manual(values = kol, name = "Docelowa rzetelność") +
  scale_linetype_manual(values = c("solid", "longdash", "dashed", "dotted"), name = "Docelowa rzetelność") +
  scale_shape_manual(values = c(21, 22, 23, 24), name = "Docelowa rzetelność") +
  labs(title = "A. Ile pozycji trzeba (Spearman–Brown)", x = "Średnia korelacja między pozycjami",
       y = "Liczba pozycji (skala logarytmiczna)") +
  motyw
pB <- ggplot(siatka, aes(rxx, 100 * trafnie_wskazani)) +
  geom_vline(xintercept = progi, colour = kol, linetype = c("solid", "longdash", "dashed", "dotted")) +
  geom_line(linewidth = 1, colour = "grey20") +
  annotate("text", x = progi, y = 47, label = names(kol), hjust = 1.15, size = 3.3) +
  scale_y_continuous(limits = c(45, 100), breaks = seq(50, 100, 10)) +
  labs(title = "B. Wybór 10% najlepszych", x = "Rzetelność wyniku",
       y = "% wskazanych, którzy naprawdę należą do 10%") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.35, 1))
p2
Wynik w R
         n       alfa alfa_stand       r_sr
   392.000      0.598      0.603      0.275
        k2    k3    k4
dane 0.424 0.530 0.603
wzor 0.432 0.532 0.603
  prog pozycji rzetelnosc
1 0.70       7      0.727
2 0.80      11      0.807
3 0.90      24      0.901
4 0.95      51      0.951
    rxx pominieci trafnie_wskazani
11 0.60     0.046            0.536
21 0.70     0.040            0.604
31 0.80     0.032            0.680
41 0.90     0.022            0.776
46 0.95     0.016            0.843
50 0.99     0.007            0.930
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Jum C. Nunnally (1924–1982) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1924, 1942, 1952, 1954, 1955, 1961, 1967, 1970, 1978, 1982),
  opis = c("urodził się\nw Birmingham (Alabama)", "szkoła średnia; potem pilot\nsamolotów transportowych",
           "doktorat,\nUniwersytet Chicagowski", "1954–1960:\nUniwersytet Illinois", "badanie\n„Miss Sun”",
           "Vanderbilt: kierownik katedry\n(1961–1964, 1967–1970);\nPopular Conceptions\nof Mental Health",
           "Psychometric Theory\n(wyd. 1)", "Introduction to\nPsychological Measurement", "Psychometric Theory\n(wyd. 2)",
           "zmarł\n22 sierpnia"),
  rodzaj = c("życie", "praca", "praca", "praca", "publikacja", "praca", "publikacja", "publikacja",
             "publikacja", "życie"),
  poziom = c(0.5, -0.6, 0.5, -1.5, 1.4, -0.6, 0.5, -1.5, 1.4, -0.6),   # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5))
zdarzenia$etykieta <- ifelse(grepl("–", zdarzenia$opis) & zdarzenia$rok == 1954, zdarzenia$opis,
                             paste0(zdarzenia$rok, "\n", zdarzenia$opis))
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1918, 1988), breaks = seq(1920, 1980, by = 10)) +
  scale_y_continuous(limits = c(-2.9, 2.5)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (dane – pakiet ltm; alfa – funkcja alpha() z pakietu psych; całkowanie – integrate() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ltm (wersja 1.2.0): Rizopoulos, D. (2006). ltm: An R package for latent variable modeling and item response theory analyses. Journal of Statistical Software, 17(5), 1–25. https://doi.org/10.18637/jss.v017.i05
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Jum C. Nunnally?
Amerykańskim psychologiem i psychometrą (1924–1982). Po służbie jako pilot w lotnictwie armii USA zrobił doktorat na Uniwersytecie Chicagowskim (1952), wykładał na Uniwersytecie Illinois (1954–1960), a potem na Uniwersytecie Vanderbilta, gdzie dwukrotnie kierował katedrą psychologii. Napisał podręcznik Psychometric Theory (1967, wyd. 2 1978).
Czy Nunnally napisał, że alfa musi wynosić co najmniej .70?
Nie w takiej formie. W wydaniu z 1978 r. nazywa .70 rzetelnością skromną, wystarczającą we wczesnych etapach badań; w badaniach podstawowych uważa za adekwatne .80, a gdy na podstawie wyników podejmuje się ważne decyzje o osobach – .90 jako minimum. Uniwersalny próg .70 to uproszczenie cytujących.
Ile pozycji trzeba dodać, żeby podnieść rzetelność skali?
Odpowiada na to odwrócony wzór Spearmana–Browna. Dla czterech pozycji o średniej korelacji .275 (dane Science, alfa .60) do rzetelności .70 potrzeba 7 podobnych pozycji, do .80 – 11, do .90 – 24, a do .95 – 51.
Jaką rzetelność wymagać, gdy wynik decyduje o konkretnej osobie?
Nunnally proponował co najmniej .90. W przykładzie z wyborem 10% najwyższych wyników przy rzetelności .70 tylko około 60% wskazanych osób naprawdę należy do tej grupy, przy .90 – około 78%, przy .95 – około 84%.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Alfa Cronbacha poniżej .70
Pozycje odwrócone, kody braków, liczba pozycji, podskale i alfa po usunięciu pozycji: co sprawdzić przy niskiej alfie i jak ją opisać w pracy.
Czytaj →PoradnikRzetelność i błąd pomiaru – wizualizacja
Wynik prawdziwy i błąd przy rzetelności .9/.7/.5, atenuacja w 1000 badań, alfa a liczba pozycji, nachylenie regresji i SEM – pięć rysunków z R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Blanton, R., & Kotsch, W. (1985). Jum Clarence Nunnally (1924–1982). American Psychologist, 40(8), 960. https://doi.org/10.1037/h0092211
- Brown, S. R. (1983). Jum Clarence Nunnally, Jr. Operant Subjectivity, 6(2). https://doi.org/10.22488/okstate.83.100511 ● Otwarty dostęp
- Cooper, S. R., Gonthier, C., Barch, D. M., & Braver, T. S. (2017). The role of psychometrics in individual differences research in cognition: A case study of the AX-CPT. Frontiers in Psychology, 8, Article 1482. https://doi.org/10.3389/fpsyg.2017.01482 ● Otwarty dostęp
- Lance, C. E., Butts, M. M., & Michels, L. C. (2006). The sources of four commonly reported cutoff criteria: What did they really say? Organizational Research Methods, 9(2), 202–220. https://doi.org/10.1177/1094428105284919
- Nunnally, J. C. (1978). Psychometric theory (2nd ed.). McGraw-Hill.
Cytowania BibTeX
@article{blanton1985jum, author={Blanton, Richard and Kotsch, William}, title={{Jum Clarence Nunnally (1924–1982)}}, journal={American Psychologist}, year={1985}, volume={40}, number={8}, pages={960}, doi={10.1037/h0092211}}@article{brown1983jum, author={Brown, Steven R.}, title={{Jum Clarence Nunnally, Jr.}}, journal={Operant Subjectivity}, year={1983}, volume={6}, number={2}, doi={10.22488/okstate.83.100511}}@article{cooper2017role, author={Cooper, Shelly R. and Gonthier, Corentin and Barch, Deanna M. and Braver, Todd S.}, title={{The role of psychometrics in individual differences research in cognition: A case study of the AX-CPT}}, journal={Frontiers in Psychology}, year={2017}, volume={8}, eid={1482}, doi={10.3389/fpsyg.2017.01482}}@article{lance2006sources, author={Lance, Charles E. and Butts, Marcus M. and Michels, Lawrence C.}, title={{The sources of four commonly reported cutoff criteria: What did they really say?}}, journal={Organizational Research Methods}, year={2006}, volume={9}, number={2}, pages={202--220}, doi={10.1177/1094428105284919}}@book{nunnally1978psychometric, author={Nunnally, Jum C.}, title={{Psychometric theory}}, year={1978}, edition={2nd ed.}, publisher={McGraw-Hill}, url={https://openlibrary.org/works/OL3928872W}}