Kim był Joseph Berkson?
Joseph Berkson (1899–1982) był amerykańskim lekarzem i statystykiem (Snoep i in., 2014). Studiował fizykę na Uniwersytecie Columbia, a w Johns Hopkins zdobył dyplom lekarza i – w 1928 r. – doktorat ze statystyki. Przez trzy lata był tam asystentem i wtedy z Lowellem Reedem opisał w 1929 r. zastosowanie funkcji logistycznej do danych doświadczalnych. Potem przeniósł się do Mayo Clinic, gdzie do końca kariery był głównym statystykiem; w latach 30. publikował głównie prace medyczne i z zakresu zdrowia publicznego (Cramer, 2002).
Do historii statystyki przeszedł z trzech powodów: nazwał model logitowy, opisał pułapkę danych szpitalnych nazywaną dziś błędem Berksona i przez dziesięciolecia spierał się z głównym nurtem statystyki – o logity, o metodę estymacji i o palenie tytoniu.
Najważniejsze pomysły
- Logit (1944). W pracy o biotestach zaproponował funkcję logistyczną jako alternatywę dla rozkładu normalnego i ukuł słowo „logit” na wzór „probitu” Chestera Blissa (Cramer, 2002). Logit to logarytm szansy, log[p/(1 − p)] – zob. transformacja logitowa i regresja probitowa.
- Minimum chi-kwadrat. Równolegle atakował metodę największej wiarygodności i zalecał estymację metodą minimum chi-kwadrat. Jak pisze Cramer (2002), styl Berksona bywał prowokacyjny, a jego wymiana zdań z Ronaldem Fisherem w „Biometrics” w 1954 r. była wyjątkowo ostra.
- Tabele czteropolowe z danych szpitalnych (1946). Berkson zauważył, że w eksperymencie grupy tworzy się przed wystąpieniem skutku, a w danych klinicznych – po tym, jak wszystkie skutki już zaszły; tabele wyglądają tak samo, ale ich interpretacja może być inna (Berkson, 1946). Jego przykład dotyczył zapalenia pęcherzyka żółciowego u pacjentów z cukrzycą i z wadami refrakcji (Snoep i in., 2014).
Ciekawostka
Słowo, z którego się śmiano. „Logit” jest dziś w każdym podręczniku, ale według Cramera (2002) Berkson był za tę propozycję początkowo wyśmiewany. Statystycy zajmujący się biotestami uważali logit za gorszy od probitu, bo nie dało się go wyprowadzić z rozkładu wrażliwości osobników. Berkson nie ustąpił i walczył o logit przez kilka dziesięcioleci.
Z metodą największej wiarygodności spierał się do końca życia. W 1980 r., jako osiemdziesięciolatek, opublikował w „The Annals of Statistics” artykuł zatytułowany z wykrzyknikiem: „Minimum chi-square, not maximum likelihood!”. Przekonywał w nim, że statystyka jest nauką, a nie matematyką czy filozofią, więc każdą zaletę estymatora należy sprawdzić eksperymentem Monte Carlo (Berkson, 1980).
Przykład: błąd Berksona w symulacji
Liczby w przykładzie nie pochodzą z pracy Berksona – to symulacja w duchu jego rozumowania. W populacji 1 000 000 osób trzy choroby występują niezależnie: zapalenie pęcherzyka żółciowego (3%), cukrzyca (1%) i wada refrakcji (10%). Każda z nich niezależnie od pozostałych prowadzi do szpitala z prawdopodobieństwem odpowiednio .15, .05 i .20. Parametry dobraliśmy ręcznie tak, by efekt był wyraźny; ziarno (set.seed(1946)) ustaliliśmy raz.
W całej populacji zapalenie pęcherzyka ma 2.95% osób z cukrzycą i 2.90% osób z wadą refrakcji – iloraz szans OR = 1.02, 95% CI [0.90, 1.16]. Wśród pacjentów szpitala te same odsetki wynoszą 9.98% (51 z 511) i 4.54% (922 z 20 296): OR = 2.33, 95% CI [1.73, 3.13], a test chi-kwadrat daje χ²(1) = 31.85, p < .001. Badacz porównujący pacjentów „uznałby”, że cukrzyca sprzyja zapaleniu pęcherzyka, choć w populacji związku nie ma. Wartości oczekiwane bez losowania to 10.64% i 4.72%.
Na rysunku
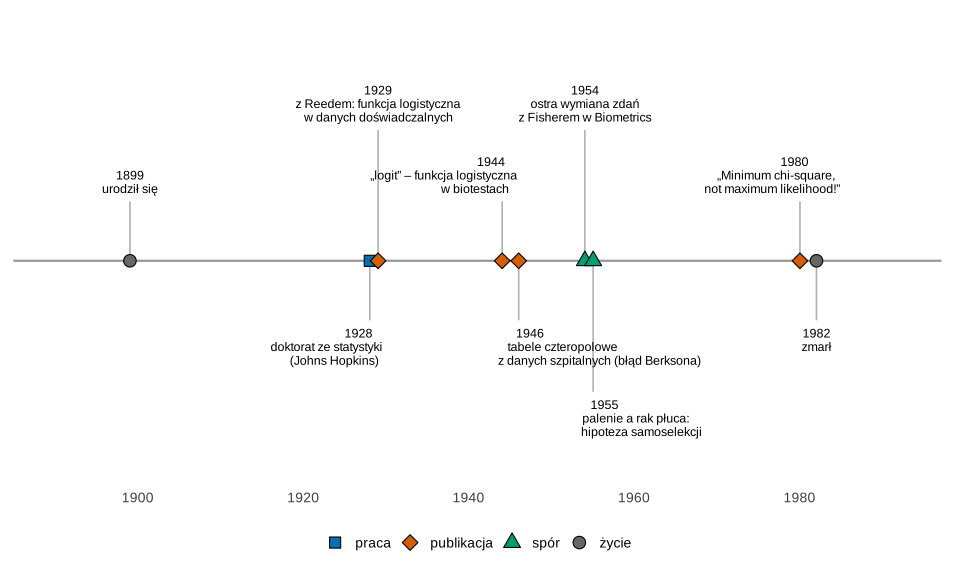
Co widać. Prace, z których Berkson jest dziś znany, powstały, gdy miał 45–47 lat; spory o logit i estymację ciągnęły się potem aż do 1980 r.
Na co uważać. Roku przejścia do Mayo Clinic nie podajemy: Cramer (2002) pisze tylko, że Berkson przeniósł się tam po trzech latach asystentury w Johns Hopkins.
Podpis do pracy:
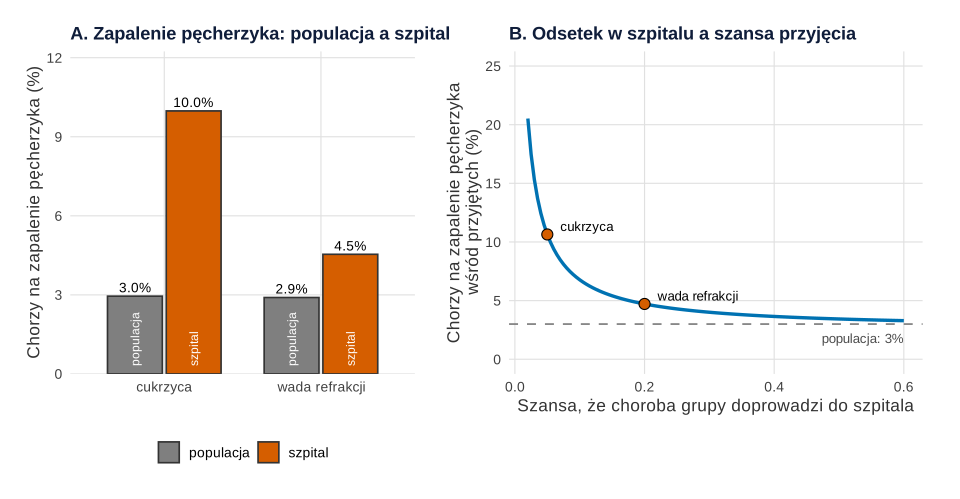
set.seed(1946)).Co widać. W populacji słupki w panelu A są równe, w szpitalu – nie. Panel B wyjaśnia dlaczego: do szpitala trafiają osoby, które mają jakikolwiek powód przyjęcia. Gdy choroba grupy rzadko prowadzi do szpitala (cukrzyca, .05), duża część jej pacjentów została przyjęta z powodu drugiej choroby – stąd nadreprezentacja zapalenia pęcherzyka. Gdy obie grupy trafiałyby do szpitala równie często, odsetki byłyby równe, choć wyższe niż w populacji.
Na co uważać. To jeden mechanizm, nie jedyny: zmiana parametrów może dać związek dodatni, ujemny albo zerowy. Błąd wynika z doboru próby, więc nie usunie go ani większa liczba pacjentów, ani test istotności.
Podpis do pracy:
Gdzie spotkasz Berksona w swojej pracy
- Regresja logistyczna. Każdy współczynnik modelu logitowego to zmiana logarytmu szansy – nazwa „logit” pochodzi od Berksona.
- Próba z poradni lub szpitala. Jeśli badasz osoby z jednej placówki, zapytaj, co decyduje o tym, że ktoś do niej trafił. Ten sam mechanizm opisują hasła błąd selekcji i zmienna zderzeniowa, a w praktyce – wpis błąd selekcji i zmienna zderzeniowa w praktyce. Na diagramie przyczynowym hospitalizacja jest wspólnym skutkiem obu chorób.
- Badanie kliniczno-kontrolne. W badaniu kliniczno-kontrolnym z kontrolami szpitalnymi opisz, z jakich powodów przyjęto kontrole. Snoep i in. (2014) pokazują, że przy nowych (incydentnych) przypadkach i wykluczeniu osób przyjętych z innych powodów błąd Berksona staje się mało prawdopodobny.
Spory, mity i trudne strony
- Palenie a rak płuca. Berkson należał do sceptyków co do przyczynowego związku palenia z rakiem płuca. Według Snoepa i in. (2014) nie powoływał się przy tym na własny błąd szpitalny. W pracy z 1955 r. argumentował, że palenie wiąże się z wieloma chorobami, co jego zdaniem wskazywało raczej na błąd niż na przyczynę, i zaproponował hipotezę samoselekcji. Autorzy komentarza zauważają, że aby wyjaśnić siłę obserwowanego związku, musiał założyć nierealistyczne interakcje. Druga strona sporu: hasła Jerome Cornfield i Austin Bradford Hill.
- Jak ważny jest błąd Berksona? Przez lata go lekceważono. W 1978 r. Roberts i współpracownicy w danych z badania gospodarstw domowych znaleźli fałszywe związki dla większości z 28 par chorób wśród niedawno hospitalizowanych, a w 1979 r. Sackett nazwał zjawisko błędem wskaźnika przyjęć (admission rate bias) (Snoep i in., 2014). Snoep i in. (2014) oceniają, że klasyczna postać błędu rzadko zagraża dziś epidemiologii, bo choroby rzadko bada się jako przyczyny innych chorób.
Błąd Berksona w R
Kod losuje populację 1 000 000 osób z trzema niezależnymi chorobami, wybiera pacjentów szpitala, porównuje odsetki i ilorazy szans w populacji i w szpitalu, liczy test chi-kwadrat oraz wartości oczekiwane bez losowania i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod działa około sekundy.
1. Populacja i szpital: rysunek 2
Kod R rysunku 2
# Błąd Berksona w symulacji: trzy niezależne choroby i próba szpitalna (parametry ilustracyjne, nie liczby Berksona)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(populacja = "grey50", szpital = "#D55E00", krzywa = "#0072B2")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
# A – zapalenie pęcherzyka żółciowego, B – cukrzyca, C – wada refrakcji; w populacji choroby są niezależne
set.seed(1946)
N <- 1e6
czestosc <- c(A = 0.03, B = 0.01, C = 0.10)    # odsetek chorych w populacji
hosp     <- c(A = 0.15, B = 0.05, C = 0.20)    # szansa, że dana choroba doprowadzi do przyjęcia do szpitala
A <- rbinom(N, 1, czestosc[["A"]]); B <- rbinom(N, 1, czestosc[["B"]]); C <- rbinom(N, 1, czestosc[["C"]])
# Każda choroba niezależnie może skierować chorego do szpitala; wystarczy jedna
szpital <- (rbinom(N, 1, hosp[["A"]]) * A + rbinom(N, 1, hosp[["B"]]) * B + rbinom(N, 1, hosp[["C"]]) * C) > 0
grupa <- ifelse(B == 1 & C == 0, "cukrzyca", ifelse(C == 1 & B == 0, "wada refrakcji", NA))   # jak u Berksona: dwie rozłączne grupy
tab_pop <- table(grupa, pecherzyk = A)
tab_szp <- table(grupa[szpital], pecherzyk = A[szpital], dnn = c("grupa", "pecherzyk"))
odsetek <- function(t) round(100 * t[, "1"] / rowSums(t), 2)
iloraz <- function(t) {                         # OR z 95% CI (metoda Woolfa): szansa zapalenia pęcherzyka, cukrzyca vs wada refrakcji
  or <- (t[1, 2] * t[2, 1]) / (t[1, 1] * t[2, 2]); se <- sqrt(sum(1 / t))
  round(c(OR = or, CI_dolna = exp(log(or) - 1.96 * se), CI_gorna = exp(log(or) + 1.96 * se)), 2)
}
tab_pop; odsetek(tab_pop); iloraz(tab_pop)     # cała populacja
tab_szp; odsetek(tab_szp); iloraz(tab_szp)     # tylko pacjenci szpitala
chisq.test(tab_szp)
# Wartość oczekiwana bez losowania: odsetek chorych na A wśród przyjętych z chorobą X, gdy X przyjmuje z szansą h
w_szpitalu <- function(h, pA = czestosc[["A"]], hA = hosp[["A"]]) {
  przyjety_z_A <- 1 - (1 - hA) * (1 - h)
  100 * pA * przyjety_z_A / (pA * przyjety_z_A + (1 - pA) * h)
}
round(c(cukrzyca = w_szpitalu(hosp[["B"]]), wada_refrakcji = w_szpitalu(hosp[["C"]]), przy_h_0.5 = w_szpitalu(0.5)), 2)

# Rysunek 2A: odsetek chorych na zapalenie pęcherzyka w populacji i w szpitalu
d <- data.frame(grupa = rep(c("cukrzyca", "wada refrakcji"), 2), proba = rep(c("populacja", "szpital"), each = 2),
                odsetek = c(odsetek(tab_pop), odsetek(tab_szp)))
pA <- ggplot(d, aes(grupa, odsetek, fill = proba)) +
  geom_col(position = position_dodge(width = 0.75), width = 0.7, colour = "grey20") +
  geom_text(aes(label = sprintf("%.1f%%", odsetek)), position = position_dodge(width = 0.75), vjust = -0.4, size = 3.6) +
  geom_text(aes(y = 0.3, label = proba), position = position_dodge(width = 0.75), angle = 90, hjust = 0, size = 3.2,
            colour = "white") +                                         # etykieta w słupku: kolor nie jest jedynym nośnikiem
  scale_fill_manual(values = kol[c("populacja", "szpital")], name = NULL) +
  scale_y_continuous(limits = c(0, 12), expand = expansion(mult = c(0, 0.02))) +
  labs(title = "A. Zapalenie pęcherzyka: populacja a szpital", x = NULL, y = "Chorzy na zapalenie pęcherzyka (%)") +
  motyw
# Rysunek 2B: im rzadziej choroba grupy prowadzi do szpitala, tym bardziej zawyżony odsetek
krzywa <- data.frame(h = seq(0.02, 0.6, by = 0.005)); krzywa$odsetek <- w_szpitalu(krzywa$h)
punkty <- data.frame(h = hosp[c("B", "C")], odsetek = w_szpitalu(hosp[c("B", "C")]), etykieta = c("cukrzyca", "wada refrakcji"))
pB <- ggplot(krzywa, aes(h, odsetek)) +
  geom_hline(yintercept = 100 * czestosc[["A"]], colour = kol[["populacja"]], linetype = "dashed") +
  annotate("text", x = 0.6, y = 100 * czestosc[["A"]] - 1.2, label = "populacja: 3%", hjust = 1, size = 3.5, colour = "grey30") +
  geom_line(colour = kol[["krzywa"]], linewidth = 1.2) +
  geom_point(data = punkty, shape = 21, size = 3.5, fill = kol[["szpital"]]) +
  geom_text(data = punkty, aes(label = etykieta), nudge_x = 0.02, nudge_y = 0.7, hjust = 0, size = 3.5) +
  scale_y_continuous(limits = c(0, 25)) +
  labs(title = "B. Odsetek w szpitalu a szansa przyjęcia", x = "Szansa, że choroba grupy doprowadzi do szpitala",
       y = "Chorzy na zapalenie pęcherzyka\nwśród przyjętych (%)") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.2))
p2
Wynik w R
                pecherzyk
grupa                0     1
  cukrzyca        8641   263
  wada refrakcji 96261  2871
      cukrzyca wada refrakcji
          2.95           2.90
      OR CI_dolna CI_gorna
    1.02     0.90     1.16
                pecherzyk
grupa                0     1
  cukrzyca         460    51
  wada refrakcji 19374   922
      cukrzyca wada refrakcji
          9.98           4.54
      OR CI_dolna CI_gorna
    2.33     1.73     3.13

	Pearson's Chi-squared test with Yates' continuity correction

data:  tab_szp
X-squared = 31.854, df = 1, p-value = 1.662e-08

      cukrzyca wada_refrakcji     przy_h_0.5
         10.64           4.72           3.43
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Joseph Berkson, 1899–1982 – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1899, 1928, 1929, 1944, 1946, 1954, 1955, 1980, 1982),
  opis = c("urodził się", "doktorat ze statystyki\n(Johns Hopkins)", "z Reedem: funkcja logistyczna\nw danych doświadczalnych",
           "„logit” – funkcja logistyczna\nw biotestach", "tabele czteropolowe\nz danych szpitalnych (błąd Berksona)",
           "ostra wymiana zdań\nz Fisherem w Biometrics", "palenie a rak płuca:\nhipoteza samoselekcji",
           "„Minimum chi-square,\nnot maximum likelihood!”", "zmarł"),
  rodzaj = c("życie", "praca", "publikacja", "publikacja", "publikacja", "spór", "spór", "publikacja", "życie"))
zdarzenia$strona     <- c(1, -1, 1, 1, -1, 1, -1, 1, -1)
zdarzenia$poziom     <- c(0.5, 0.5, 1.1, 0.5, 0.5, 1.1, 1.1, 0.5, 0.5)
zdarzenia$wyrownanie <- c(0.5, 0.9, 0.5, 0.9, 0.1, 0.5, 0.1, 0.7, 0.5)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "spór" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "spór" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom * strona), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 4, colour = "black") +
  geom_text(aes(y = (poziom + 0.07) * strona, label = paste0(rok, "\n", opis), vjust = ifelse(strona > 0, 0, 1), hjust = wyrownanie),
            size = 3.3, lineheight = 0.9) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1890, 1992), breaks = seq(1900, 1980, by = 20)) +
  scale_y_continuous(limits = c(-1.7, 1.9)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie – rbinom(), test chi-kwadrat – chisq.test() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Joseph Berkson?
Amerykańskim lekarzem i statystykiem (1899–1982). Studiował fizykę na Uniwersytecie Columbia, w Johns Hopkins zdobył dyplom lekarza i w 1928 r. doktorat ze statystyki, a potem przez resztę kariery był głównym statystykiem Mayo Clinic (Cramer, 2002).
Co to jest błąd (paradoks) Berksona?
To błąd doboru próby: dwie choroby niezależne w populacji mogą wydawać się powiązane wśród pacjentów szpitala, bo do szpitala trafiają osoby, które mają jakikolwiek powód przyjęcia. Berkson opisał go w 1946 r. na przykładzie zapalenia pęcherzyka żółciowego u chorych na cukrzycę (Berkson, 1946; Snoep i in., 2014).
Skąd się wzięło słowo „logit”?
Ukuł je Berkson w 1944 r., gdy zaproponował funkcję logistyczną w biotestach – na wzór „probitu” Chestera Blissa. Początkowo był za to wyśmiewany, a logit uchodził za gorszy od probitu (Cramer, 2002).
Czy Berkson uważał, że palenie powoduje raka płuca?
Nie – był sceptykiem. W 1955 r. argumentował, że palenie wiąże się z wieloma chorobami, co jego zdaniem wskazywało na błąd, i zaproponował hipotezę samoselekcji; według Snoepa i in. (2014) wymagało to założenia nierealistycznych interakcji.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Berkson, J. (1946). Limitations of the application of fourfold table analysis to hospital data. Biometrics Bulletin, 2(3), 47–53. https://doi.org/10.2307/3002000
- Berkson, J. (1980). Minimum chi-square, not maximum likelihood! The Annals of Statistics, 8(3), 457–487. https://doi.org/10.1214/aos/1176345003 ● Otwarty dostęp
- Cramer, J. S. (2002). The origins of logistic regression (Tinbergen Institute Discussion Paper 02-119/4). Tinbergen Institute. https://papers.tinbergen.nl/02119.pdf ● Otwarty dostęp
- Snoep, J. D., Morabia, A., Hernández-Díaz, S., Hernán, M. A., & Vandenbroucke, J. P. (2014). Commentary: A structural approach to Berkson’s fallacy and a guide to a history of opinions about it. International Journal of Epidemiology, 43(2), 515–521. https://doi.org/10.1093/ije/dyu026 ● Otwarty dostęp
Cytowania BibTeX
@article{berkson1946limitations, author={Berkson, Joseph}, title={{Limitations of the application of fourfold table analysis to hospital data}}, journal={Biometrics Bulletin}, year={1946}, volume={2}, number={3}, pages={47--53}, doi={10.2307/3002000}}@article{berkson1980minimum, author={Berkson, Joseph}, title={{Minimum chi-square, not maximum likelihood!}}, journal={The Annals of Statistics}, year={1980}, volume={8}, number={3}, pages={457--487}, doi={10.1214/aos/1176345003}}@techreport{cramer2002origins, author={Cramer, Jan Salomon}, title={{The origins of logistic regression}}, year={2002}, institution={Tinbergen Institute}, url={https://papers.tinbergen.nl/02119.pdf}}@article{snoep2014commentary, author={Snoep, Jaapjan D. and Morabia, Alfredo and Hern{\'a}ndez-D{\'i}az, Sonia and Hern{\'a}n, Miguel A. and Vandenbroucke, Jan P.}, title={{Commentary: A structural approach to Berkson’s fallacy and a guide to a history of opinions about it}}, journal={International Journal of Epidemiology}, year={2014}, volume={43}, number={2}, pages={515--521}, doi={10.1093/ije/dyu026}}