Kim był George W. Snedecor?
George Waddel Snedecor (1881–1974) był amerykańskim statystykiem. Był pierwszym dyrektorem Laboratorium Statystycznego w Iowa State College i autorem podręcznika Statistical Methods dla badaczy rolnictwa i biologii. Urodził się 20 października 1881 r. w Memphis w stanie Tennessee. W 1905 r. ukończył matematykę i fizykę na University of Alabama, a potem uczył m.in. w Austin College w Teksasie (O’Connor i Robertson, 2010; Iowa State University Library, b.d.).
W 1913 r. zdobył magisterium z fizyki na University of Michigan i w tym samym roku został asystentem w katedrze matematyki Iowa State College w Ames. Profesorem nadzwyczajnym został w 1914 r., zwyczajnym w 1931 r. W roku akademickim 1914/1915 uczelnia wprowadziła kurs rachunku prawdopodobieństwa i metody najmniejszych kwadratów (O’Connor i Robertson, 2010). W 1924 r. razem z Henrym A. Wallace’em zorganizował seminaria, od których w Iowa State zaczęło się specjalne zainteresowanie badaniami statystycznymi. W 1927 r. uczelnia powołała pod jego kierunkiem Mathematics Statistical Service, czyli pracownię konsultacji i obliczeń (Iowa State University Library, b.d.).
W 1933 r. pracownia przekształciła się w Laboratorium Statystyczne, a Snedecor został jego pierwszym dyrektorem. Do powstania tak wczesnej jednostki przyczynili się, według Davida (1998), Wallace i Ronald Fisher. Laboratorium kierował do 30 czerwca 1947 r.; 1 lipca 1947 r. powstał wydział statystyki, w którym Snedecor był profesorem do 1958 r. (O’Connor i Robertson, 2010). W 1948 r. był prezesem American Statistical Association – jako pierwszy przedstawiciel badań rolniczych na tym stanowisku. Potem doradzał laboratorium marynarki wojennej w San Diego. Zmarł 15 lutego 1974 r. w Amherst w stanie Massachusetts (Iowa State University Library, b.d.).
Najważniejsze pomysły
- Tablice rozkładu F (1934). W monografii o obliczaniu i interpretacji analizy wariancji i kowariancji Snedecor oznaczył rozkład ilorazu dwóch średnich kwadratów literą F; Fisher posługiwał się w tym miejscu wielkością z (Snedecor, 1934, 1946). Dziś rozkład F stoi za każdym testem w tabeli ANOVA.
- Podręcznik dla praktyków (1937). Statistical Methods pisał dla początkujących eksperymentatorów: jedyną matematyką w książce miała być arytmetyka (Snedecor, 1946). Za jego życia podręcznik miał siedem wydań i wiele przekładów (Iowa State University Library, b.d.). Później współautorem został William G. Cochran, któremu Snedecor dziękował za pomoc już w przedmowie z 1940 r. (Snedecor, 1946).
- Statystyka jako usługa dla nauki. Pracownia z 1927 r. prowadziła konsultacje i obliczenia dla całej uczelni (Iowa State University Library, b.d.). W laboratorium pracowała m.in. Gertrude Cox, którą Snedecor w 1933 r. namówił do powrotu z Berkeley (Anderson, 1990).
- Most między Fisherem a Ameryką. W przedmowie z 1937 r. Snedecor pisał, że Fisher dzięki pobytom w Iowa State jako profesor wizytujący i dzięki swoim pismom wywarł głęboki wpływ na techniki eksperymentalne i statystyczne uczelni (Snedecor, 1946).
Ciekawostka
Skąd litera F? Snedecor wyjaśnił to sam w podręczniku. Iloraz średniego kwadratu między grupami i średniego kwadratu wewnątrz grup ma rozkład odkryty przez Fishera, a Snedecor nazwał go F na jego cześć: „I named it F in his honor” (Snedecor, 1946, s. 219). Fisher tablicował ten rozkład w innej postaci, jako z = ln √F. Fisher i Yates w swoich tablicach mówili po prostu o ilorazie wariancji. Prasanta Chandra Mahalanobis, który według Snedecora pierwszy go policzył, oznaczał go literą x (Snedecor, 1946).
Sam Fisher nie nazwał więc swojego rozkładu literą F – nadał mu ją Snedecor. Stąd spotykane dziś nazwy: rozkład F Fishera, F Snedecora albo rozkład Fishera–Snedecora.
Przykład na historycznych danych
Zbiór Alfalfa z pakietu nlme pochodzi – według pliku pomocy – z siódmego wydania podręcznika Snedecora i Cochrana z 1980 r. To doświadczenie w układzie split-plot: trzy odmiany lucerny (Cossack, Ladak, Ranger) i cztery terminy trzeciego koszenia w 1943 r. (bez koszenia, 1 września, 20 września, 7 października). Doświadczenie założono w sześciu blokach; odmiany losowano na większe jednostki, a terminy – na cztery poletka w ich obrębie. Mierzono plon w 1944 r. w tonach z akra.
Średni plon był najniższy po koszeniu 1 września (od 1.30 do 1.41 t/akr) i najwyższy bez trzeciego koszenia (od 1.70 do 1.88 t/akr). Analiza wariancji daje dla terminu koszenia F(3, 45) = 23.39, p < .001. Średni kwadrat terminu (0.654) jest ponad 23 razy większy niż błędu podpoletek (0.028). Odmiany różnią się słabo, F(2, 10) = 0.65, p = .541 – tu mianownikiem jest zmienność całych poletek (0.136), a nie podpoletek. Interakcja nie jest istotna, F(6, 45) = 1.26, p = .297.
Ta sama decyzja w zapisie Fishera: z = ½ ln F = 1.576, a wartość krytyczna z dla α = .05 wynosi 0.517. W zapisie Snedecora wynik porównujemy wprost z F krytycznym 2.81. Czy statystyka naprawdę ma rozkład F? Losujemy terminy od nowa w obrębie każdego poletka, jak w doświadczeniu, 10 000 razy (set.seed(1934)). Przy prawdziwej H0 95. centyl takiego rozkładu wynosi 2.85 wobec 2.81 z tablic F, a próg 2.81 przekracza 5.2% losowań. Największe F z 10 000 losowań to 8.69, więc żadne nie zbliżyło się do obserwowanego 23.39.
Na rysunku
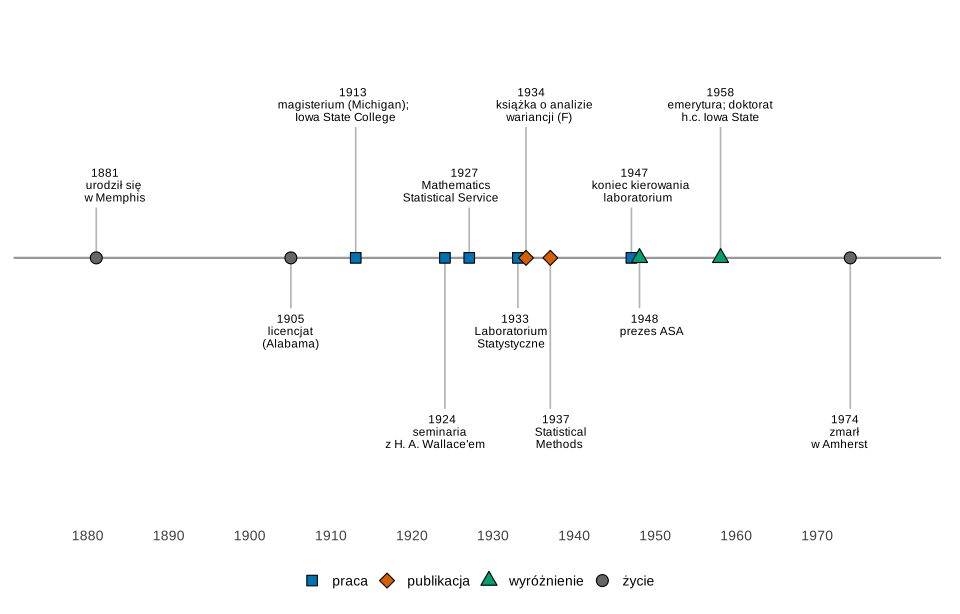
Co widać. Prawie całe zawodowe życie Snedecora to Iowa State – od asystenta matematyki po dyrektora laboratorium.
Na co uważać. Rok prezesury ASA podajemy za archiwum Iowa State (1948); MacTutor podaje 1947.
Podpis do pracy:
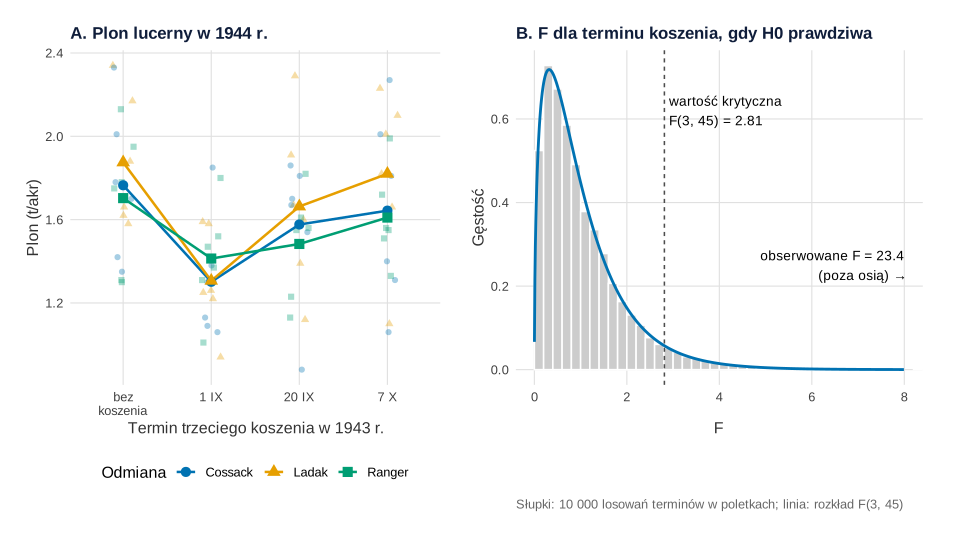
nlme::Alfalfa (z podręcznika Snedecora i Cochrana, wyd. 7, 1980). Obliczenia i rysunek: R, pakiety nlme, ggplot2 i patchwork (set.seed(1934), 10 000 losowań).Co widać. W panelu A linie odmian są prawie równoległe, stąd słaba interakcja. W panelu B histogram z losowań prawie pokrywa się z krzywą F(3, 45).
Na co uważać. Losowania sprawdzają tylko test dla terminu, nie dla odmian. Krzywa F zakłada normalność i równe wariancje; przy małych, skośnych danych może odbiegać od rozkładu z losowań.
Podpis do pracy:
Gdzie spotkasz Snedecora w swojej pracy
- Każda tabela ANOVA. Zapis F(2, 57) = 4.21 to iloraz średnich kwadratów porównany z rozkładem F o dwóch liczbach stopni swobody. Wartości krytyczne znajdziesz w tablicach rozkładów t, χ² i F.
- Plany z blokami i poletkami. Bloki i split-plot wywodzą się z doświadczeń polowych. Przykłady Snedecora i Cochrana są w pakietach R.
- Testy randomizacyjne. Gdy wątpisz w założenia testu F, możesz porównać wynik z rozkładem z losowań, jak w przykładzie – zob. test permutacyjny.
Spory, mity i trudne strony
- „F Fishera” czy „F Snedecora”? Obie nazwy mają uzasadnienie: rozkład wyprowadził Fisher, ale literę F i tablice w tej postaci wprowadził Snedecor, a pierwsze obliczenia przypisywał Mahalanobisowi (Snedecor, 1946).
Rozkład F na danych o lucernie w R
Kod liczy średnie plony, analizę wariancji dla schematu split-plot, statystykę F dla terminu koszenia ręcznie z sum kwadratów, jej odpowiednik z Fishera i rozkład F z 10 000 losowych przydziałów terminów w obrębie poletek. Rysuje też rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Ziarno: set.seed(1934); punkty pojedynczych poletek w panelu A są lekko rozsunięte w poziomie (geom_jitter).
1. Analiza wariancji i rozkład F: rysunek 2
Kod R rysunku 2
# Rozkład F na danych rolniczych: lucerna (Snedecor i Cochran), doświadczenie split-plot
# iloraz średnich kwadratów, F Snedecora a z Fishera, rozkład randomizacyjny F a teoretyczny F
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
data(Alfalfa, package = "nlme")
lucerna <- as.data.frame(Alfalfa)          # Yield: plon w 1944 r. (t/akr), Date: termin trzeciego koszenia w 1943 r.
kol <- c(Cossack = "#0072B2", Ladak = "#E69F00", Ranger = "#009E73")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# 1. Średnie plony: termin koszenia × odmiana
round(with(lucerna, tapply(Yield, list(Variety, Date), mean)), 3)

# 2. ANOVA dla schematu split-plot: odmiany na poletkach głównych w blokach, terminy koszenia na podpoletkach
model <- aov(Yield ~ Variety * Date + Error(Block / Variety), data = lucerna)
summary(model)

# 3. F jako iloraz średnich kwadratów – ręcznie dla terminu koszenia (warstwa podpoletek)
lucerna$poletko <- interaction(lucerna$Block, lucerna$Variety)
sredniaP <- ave(lucerna$Yield, lucerna$poletko)                      # średnia poletka głównego
SS_wewn <- sum((lucerna$Yield - sredniaP)^2)                          # zmienność wewnątrz poletek głównych
F_terminu <- function(y, termin) {
  m <- mean(y)
  sr_t <- ave(y, termin); sr_v <- ave(y, lucerna$Variety); sr_vt <- ave(y, lucerna$Variety, termin)
  SS_t <- sum((sr_t - m)^2)                                           # termin koszenia (3 df)
  SS_vt <- sum((sr_vt - sr_v - sr_t + m)^2)                           # interakcja odmiana × termin (6 df)
  SS_res <- SS_wewn - SS_t - SS_vt                                    # błąd podpoletek (45 df)
  (SS_t / 3) / (SS_res / 45)
}
F_obs <- F_terminu(lucerna$Yield, lucerna$Date)
round(F_obs, 3)
signif(pf(F_obs, 3, 45, lower.tail = FALSE), 3)   # p z rozkładu F(3, 45)

# 4. Ta sama decyzja w zapisie Fishera: z = ½·ln F (Fisher tablicował z, Snedecor – samo F)
z_obs <- 0.5 * log(F_obs); z_kryt <- 0.5 * log(qf(0.95, 3, 45))
round(c(F = F_obs, F_krytyczne = qf(0.95, 3, 45), z = z_obs, z_krytyczne = z_kryt), 4)

# 5. Rozkład randomizacyjny: terminy koszenia losowane od nowa wewnątrz każdego poletka głównego
set.seed(1934)
B <- 10000
poletka <- split(seq_len(nrow(lucerna)), lucerna$poletko)
F_perm <- replicate(B, {
  termin <- lucerna$Date
  for (i in poletka) termin[i] <- sample(termin[i])
  F_terminu(lucerna$Yield, termin)
})
round(c(kwantyl_95_randomizacja = unname(quantile(F_perm, 0.95)), kwantyl_95_F = qf(0.95, 3, 45),
        P_F_powyzej_2.81_randomizacja = mean(F_perm >= qf(0.95, 3, 45)),
        p_randomizacyjne = mean(F_perm >= F_obs), max_F_perm = max(F_perm)), 4)

# Rysunek: A – średnie plony według terminu koszenia i odmiany; B – rozkład randomizacyjny F i krzywa F(3, 45)
sr <- aggregate(Yield ~ Variety + Date, data = lucerna, FUN = mean)
pA <- ggplot(sr, aes(Date, Yield, colour = Variety, shape = Variety, group = Variety)) +
  geom_jitter(data = lucerna, aes(Date, Yield, colour = Variety, shape = Variety), inherit.aes = FALSE,
              width = 0.12, height = 0, alpha = 0.35, size = 1.8) +
  geom_line(linewidth = 0.9) + geom_point(size = 3.2) +
  scale_colour_manual(values = kol, name = "Odmiana") + scale_shape_manual(values = c(16, 17, 15), name = "Odmiana") +
  scale_x_discrete(labels = c(None = "bez\nkoszenia", S1 = "1 IX", S20 = "20 IX", O7 = "7 X")) +
  labs(title = "A. Plon lucerny w 1944 r.", x = "Termin trzeciego koszenia w 1943 r.", y = "Plon (t/akr)") +
  motyw
x <- seq(0.001, 8, by = 0.01)
pB <- ggplot(data.frame(F = F_perm), aes(F)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 0.2, boundary = 0, fill = "grey80", colour = "white") +
  geom_line(data = data.frame(F = x, g = df(x, 3, 45)), aes(F, g), colour = "#0072B2", linewidth = 1) +
  geom_vline(xintercept = qf(0.95, 3, 45), linetype = "22", colour = "grey30") +
  annotate("text", x = qf(0.95, 3, 45) + 0.1, y = 0.62, hjust = 0, size = 3.6,
           label = "wartość krytyczna\nF(3, 45) = 2.81") +
  annotate("text", x = 8, y = 0.25, hjust = 1, size = 3.6,
           label = paste0("obserwowane F = ", round(F_obs, 1), "\n(poza osią) →")) +
  coord_cartesian(xlim = c(0, 8)) +
  labs(title = "B. F dla terminu koszenia, gdy H0 prawdziwa", x = "F",
       y = "Gęstość", caption = "Słupki: 10 000 losowań terminów w poletkach; linia: rozkład F(3, 45)") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.1))
p2
Wynik w R
         None    S1   S20    O7
Cossack 1.765 1.302 1.577 1.643
Ladak   1.875 1.307 1.663 1.820
Ranger  1.703 1.413 1.483 1.610

Error: Block
          Df Sum Sq Mean Sq F value Pr(>F)
Residuals  5   4.15    0.83

Error: Block:Variety
          Df Sum Sq Mean Sq F value Pr(>F)
Variety    2  0.178 0.08901   0.653  0.541
Residuals 10  1.362 0.13623

Error: Within
             Df Sum Sq Mean Sq F value   Pr(>F)
Date          3 1.9625  0.6542  23.390 2.83e-09 ***
Variety:Date  6 0.2106  0.0351   1.255    0.297
Residuals    45 1.2585  0.0280
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
[1] 23.39
[1] 2.83e-09
          F F_krytyczne           z z_krytyczne
    23.3897      2.8115      1.5761      0.5169
      kwantyl_95_randomizacja                  kwantyl_95_F
                       2.8539                        2.8115
P_F_powyzej_2.81_randomizacja              p_randomizacyjne
                       0.0520                        0.0000
                   max_F_perm
                       8.6940
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: George W. Snedecor (1881–1974) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1881, 1905, 1913, 1924, 1927, 1933, 1934, 1937, 1947, 1948, 1958, 1974),
  opis = c("urodził się\nw Memphis", "licencjat\n(Alabama)", "magisterium (Michigan);\nIowa State College",
           "seminaria\nz H. A. Wallace'em", "Mathematics\nStatistical Service", "Laboratorium\nStatystyczne",
           "książka o analizie\nwariancji (F)", "Statistical\nMethods", "koniec kierowania\nlaboratorium",
           "prezes ASA", "emerytura; doktorat\nh.c. Iowa State", "zmarł\nw Amherst"),
  rodzaj = c("życie", "życie", "praca", "praca", "praca", "praca", "publikacja", "publikacja", "praca",
             "wyróżnienie", "wyróżnienie", "życie"),
  poziom = c(0.5, -0.5, 1.3, -1.5, 0.5, -0.5, 1.3, -1.5, 0.5, -0.5, 1.3, -1.5),   # wysokość etykiety
  wyrownanie = c(0.2, 0.5, 0.6, 0.6, 0.7, 0.6, 0.3, 0.3, 0.4, 0.3, 0.5, 0.7))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1876, 1980), breaks = seq(1880, 1970, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.2)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (analiza wariancji – aov(), rozkład F – pf(), qf(), df() z pakietu stats; dane – pakiet nlme; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- nlme (wersja 3.1.168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models [R package]. https://doi.org/10.32614/CRAN.package.nlme
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był George W. Snedecor?
Amerykańskim statystykiem (1881–1974) z Iowa State College w Ames. W 1933 r. został pierwszym dyrektorem tamtejszego Laboratorium Statystycznego, w 1937 r. wydał podręcznik Statistical Methods, a w 1948 r. był prezesem American Statistical Association (Iowa State University Library, b.d.).
Dlaczego rozkład F nazywa się F?
Bo tak nazwał go Snedecor na cześć Ronalda Fishera, który odkrył ten rozkład. Sam Fisher tablicował go w postaci z = ln √F, a Mahalanobis, który według Snedecora pierwszy go policzył, oznaczał go literą x (Snedecor, 1946, s. 219).
Czym różni się F Snedecora od z Fishera?
Tylko zapisem: z = ½ ln F, więc oba prowadzą do tej samej decyzji. W przykładzie z lucerną F(3, 45) = 23.39 przy wartości krytycznej 2.81, a w zapisie Fishera z = 1.576 przy wartości krytycznej 0.517.
Co to było Laboratorium Statystyczne w Iowa State?
Jednostka utworzona w 1933 r. z pracowni konsultacji i obliczeń statystycznych z 1927 r., kierowana przez Snedecora do 1947 r. Doradzała badaczom całej uczelni; pracowała w niej m.in. Gertrude Cox (Anderson, 1990; David, 1998).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Anderson, R. L. (1990). Gertrude Mary Cox, January 13, 1900–October 17, 1978. In Biographical memoirs: Volume 59 (pp. 117–132). National Academy Press. https://www.nasonline.org/wp-content/uploads/2024/10/Cox_Gertrude.pdf
- David, H. A. (1998). Statistics in U.S. universities in 1933 and the establishment of the Statistical Laboratory at Iowa State. Statistical Science, 13(1), 66–74. https://doi.org/10.1214/ss/1028905974 ● Otwarty dostęp
- Iowa State University Library, Special Collections Department. (b.d.). George Waddel Snedecor papers, 1925–1978 (RS 13/24/51): Biographical note. Iowa State University Library Special Collections and University Archives. Pobrano 22 listopada 2026 z https://findingaids.lib.iastate.edu/spcl/arch/rgrp/13-24-51.html ● Otwarty dostęp
- O’Connor, J. J., & Robertson, E. F. (2010). George Waddel Snedecor. MacTutor History of Mathematics Archive. https://mathshistory.st-andrews.ac.uk/Biographies/Snedecor/ ● Otwarty dostęp
- Snedecor, G. W. (1934). Calculation and interpretation of analysis of variance and covariance. Collegiate Press.
- Snedecor, G. W. (1946). Statistical methods applied to experiments in agriculture and biology (4th ed.). Iowa State College Press. https://archive.org/details/dli.ernet.233798 ● Otwarty dostęp
Cytowania BibTeX
@incollection{anderson1990gertrude, author={Anderson, Richard L.}, title={{Gertrude Mary Cox, January 13, 1900–October 17, 1978}}, booktitle={Biographical memoirs: Volume 59}, year={1990}, pages={117--132}, publisher={National Academy Press}, url={https://www.nasonline.org/wp-content/uploads/2024/10/Cox_Gertrude.pdf}}@article{david1998statistics, author={David, Herbert A.}, title={{Statistics in U.S. universities in 1933 and the establishment of the Statistical Laboratory at Iowa State}}, journal={Statistical Science}, year={1998}, volume={13}, number={1}, pages={66--74}, doi={10.1214/ss/1028905974}}@misc{iowastatesnedecorpapersnd, author={{Iowa State University Library, Special Collections Department}}, title={{George Waddel Snedecor papers, 1925–1978 (RS 13/24/51): Biographical note}}, howpublished={Iowa State University Library Special Collections and University Archives}, publisher={Iowa State University Library}, url={https://findingaids.lib.iastate.edu/spcl/arch/rgrp/13-24-51.html}}@misc{oconnor2010snedecor, author={O'Connor, John J. and Robertson, Edmund F.}, title={{George Waddel Snedecor}}, howpublished={MacTutor History of Mathematics Archive}, year={2010}, publisher={University of St Andrews, School of Mathematics and Statistics}, url={https://mathshistory.st-andrews.ac.uk/Biographies/Snedecor/}}@book{snedecor1934calculation, author={Snedecor, George W.}, title={{Calculation and interpretation of analysis of variance and covariance}}, year={1934}, publisher={Collegiate Press}}@book{snedecor1946statistical, author={Snedecor, George W.}, title={{Statistical methods applied to experiments in agriculture and biology}}, year={1946}, edition={4}, publisher={Iowa State College Press}, url={https://archive.org/details/dli.ernet.233798}}