Co to jest wykres Gardnera–Altmana?
Wykres Gardnera–Altmana (ang. Gardner–Altman plot, estimation plot) pokazuje porównanie dwóch grup w dwóch częściach. Po lewej są surowe wyniki każdej osoby w obu grupach. Po prawej, na osobnej osi, jest różnica średnich z 95% przedziałem ufności. Zero osi różnicy leży na wysokości średniej grupy kontrolnej, więc różnicę czyta się w tych samych jednostkach co wyniki.
Gardner i Altman (1986) zalecali zamiast podziału wyników według wartości p podawać wielkość różnicy z przedziałem ufności, także na rysunku. Ho i in. (2019) nazywają taki rysunek wykresem estymacji i opisują jego przewagi nad konwencjonalnymi wykresami. Ten sam kierunek – od testowania istotności do estymacji – Cumming (2014) nazywa „nową statystyką”.
Jak czytać wykres
- Lewa część – rozrzut i nakładanie się grup.
- Kropka po prawej – różnica średnich. Leży na poziomie średniej drugiej grupy.
- Pionowy odcinek – 95% przedział ufności różnicy. To, czy obejmuje zero prawej osi, w przybliżeniu odpowiada wynikowi testu dwustronnego na poziomie .05.
- Szary kształt – rozkład bootstrapowy różnicy: pokazuje, które wartości efektu są z danymi zgodne bardziej, a które mniej.
Dla trzech i więcej grup rysuje się wykres Cumminga z osobnym panelem różnic (rysunek 2).
Przykład
Porównano wynik testu w grupie kontrolnej i dwóch grupach treningowych, po 25 osób (dane symulowane). Średnie w populacji ustawiono ręcznie na 20, 25 i 22 punkty przy SD = 6, żeby pokazać jeden wyraźny i jeden niepewny efekt; ziarna (736) nie zmieniano. Trening A dał różnicę 4.15 punktu, bootstrapowy 95% CI [0.71, 7.44] (przedział Welcha [0.66, 7.65], p = .021, d Cohena = 0.68). Trening B dał różnicę 0.51 punktu, 95% CI [−2.84, 3.97], p = .778.
Na rysunku
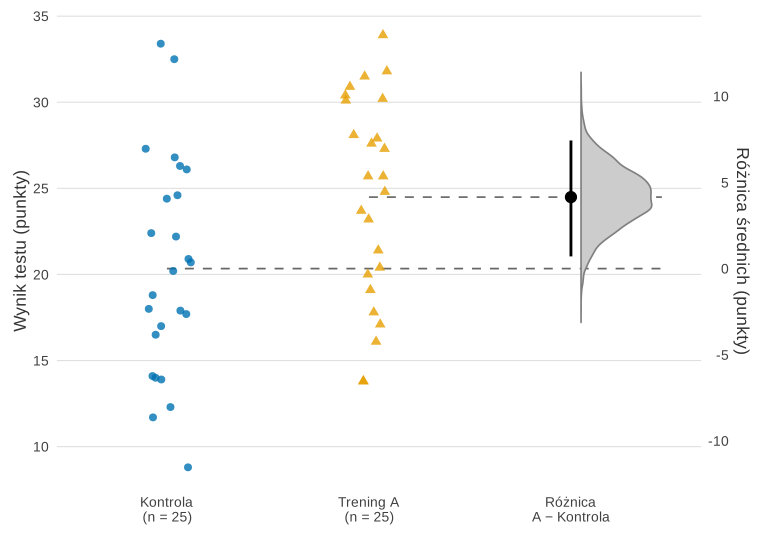
set.seed(736), 5000 losowań bootstrapowych).Co widać. Rozkłady obu grup mocno na siebie zachodzą. Przedział ufności różnicy nie obejmuje zera, ale jest szeroki: od mniej niż jednego do ponad siedmiu punktów. Dane są więc zgodne zarówno z efektem bardzo małym, jak i całkiem dużym – tego nie mówi samo „p = .021”.
Na co uważać. Przedział dotyczy różnicy średnich, a nie wyników pojedynczych osób – wiele osób z grupy kontrolnej ma wyniki wyższe niż przeciętna osoba po treningu. Przy pomiarach powtarzanych potrzebna jest wersja dla par.
Podpis do pracy:
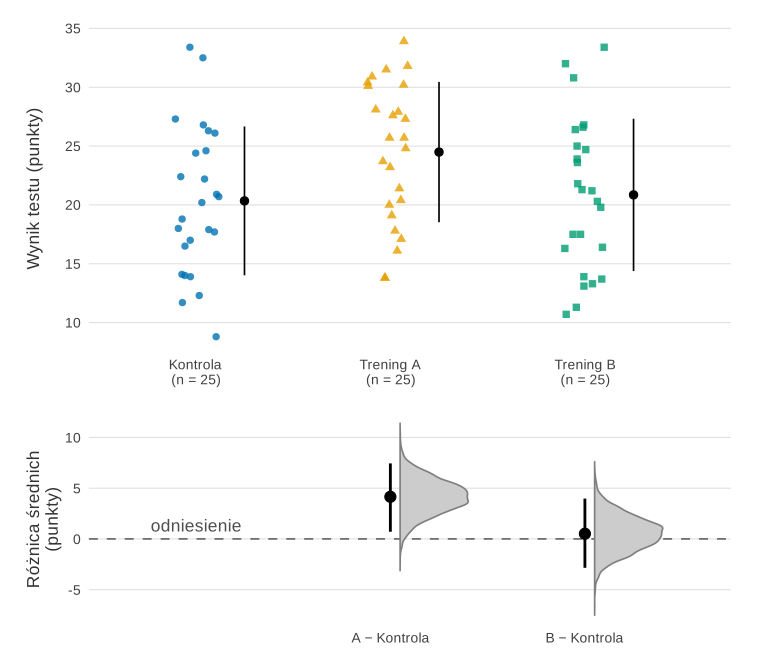
Co widać. Dolny panel zestawia oba efekty na jednej skali. Przedział dla treningu B obejmuje zero, ale sięga też prawie 4 punktów – wynik nieistotny nie znaczy tu „brak efektu”, tylko „efekt oszacowany nieprecyzyjnie”.
Na co uważać. Panel różnic pokazuje tylko porównania z grupą odniesienia; różnicy między treningami A i B trzeba szukać osobno. Jak czytać nakładanie się przedziałów i co znaczy „95%”, pokazuje wpis przedział ufności w obrazkach, a sam bootstrap – bootstrap na obrazkach.
Podpis do pracy:
Jak opisać w pracy
Na co uważać
- Podaj, jak liczono przedział. Bootstrap percentylowy, BCa i przedział testu Welcha dają podobne, ale nie identyczne granice (tu [0.71, 7.44] i [0.66, 7.65]).
- Podpisz prawą oś tak, by było jasne, którą grupę od której odejmujesz.
Wykres Gardnera–Altmana w R
Kod symuluje trzy grupy, liczy bootstrapowe przedziały różnic średnich względem kontroli (losowanie ze zwracaniem osobno w każdej grupie), dla porównania przedział Welcha, p i d Cohena, a potem buduje oba rysunki w ggplot2. Rysunki na stronie powstały z tych samych obiektów p1 i p2 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Bootstrap różnic średnich i rysunki 1–2
R
# Wykres Gardnera–Altmana i wykres Cumminga: trzy grupy po 25 osób (dane symulowane), bootstrap różnic średnich
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c("Kontrola" = "#0072B2", "Trening A" = "#E69F00", "Trening B" = "#009E73")   # Okabe–Ito
ksz <- c("Kontrola" = 16, "Trening A" = 17, "Trening B" = 15)                         # kształt też różni grupy
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), panel.grid.major.x = element_blank())
set.seed(736)
n <- 25
gr <- c("Kontrola", "Trening A", "Trening B")
d <- data.frame(grupa = factor(rep(gr, each = n), levels = gr),
                wynik = round(c(rnorm(n, 20, 6), rnorm(n, 25, 6), rnorm(n, 22, 6)), 1))
aggregate(wynik ~ grupa, d, function(x) round(c(M = mean(x), SD = sd(x)), 2))
k <- d$wynik[d$grupa == "Kontrola"]
B <- 5000                                                 # losowania bootstrapowe w każdej grupie osobno
boot <- sapply(gr[2:3], function(g) {
  x <- d$wynik[d$grupa == g]
  replicate(B, mean(sample(x, replace = TRUE)) - mean(sample(k, replace = TRUE)))
})
wyn <- t(sapply(gr[2:3], function(g) {
  x <- d$wynik[d$grupa == g]; tt <- t.test(x, k)       # dla porównania: przedział Welcha
  c(roznica = mean(x) - mean(k), boot_dolna = quantile(boot[, g], .025, names = FALSE),
    boot_gorna = quantile(boot[, g], .975, names = FALSE), welch_dolna = tt$conf.int[1],
    welch_gorna = tt$conf.int[2], p = tt$p.value, d_Cohena = (mean(x) - mean(k)) / sqrt((var(x) + var(k)) / 2))
}))
round(wyn, 3)

# Rozkład bootstrapowy jako „półskrzypce” obok osi różnic
polowka <- function(b, x0, y0 = 0, szer = 0.35) {
  g <- density(b, n = 256)
  data.frame(x = c(x0, x0 + szer * g$y / max(g$y), x0), y = y0 + c(g$x[1], g$x, g$x[256]))
}
mk <- mean(k)
# Rysunek 1: wykres Gardnera–Altmana (Kontrola i Trening A; prawa oś = różnica, jej zero na średniej kontroli)
d1 <- droplevels(subset(d, grupa != "Trening B"))
ma <- mean(d1$wynik[d1$grupa == "Trening A"])
p1 <- ggplot(d1, aes(as.numeric(grupa), wynik)) +
  annotate("segment", x = c(1, 2), xend = 3.45, y = c(mk, ma), yend = c(mk, ma), linetype = "dashed", colour = "grey40") +
  geom_point(aes(colour = grupa, shape = grupa), position = position_jitter(width = 0.12, height = 0, seed = 1),
             size = 2.4, alpha = 0.8) +
  geom_polygon(data = polowka(boot[, "Trening A"], 3.05, mk), aes(x, y), fill = "grey80", colour = "grey50") +
  annotate("errorbar", x = 3, ymin = mk + wyn["Trening A", "boot_dolna"], ymax = mk + wyn["Trening A", "boot_gorna"],
           width = 0, linewidth = 1) +
  annotate("point", x = 3, y = ma, size = 3.5) +
  scale_colour_manual(values = kol, guide = "none") + scale_shape_manual(values = ksz, guide = "none") +
  scale_x_continuous(breaks = 1:3, labels = c("Kontrola\n(n = 25)", "Trening A\n(n = 25)", "Różnica\nA − Kontrola"),
                     limits = c(0.6, 3.5)) +
  scale_y_continuous(sec.axis = sec_axis(~ . - mk, name = "Różnica średnich (punkty)", breaks = seq(-10, 20, 5))) +
  labs(x = NULL, y = "Wynik testu (punkty)") + motyw

# Rysunek 2: wykres Cumminga – surowe dane trzech grup (góra) i różnice względem kontroli (dół)
sr <- aggregate(wynik ~ grupa, d, function(x) c(M = mean(x), SD = sd(x)))
sr <- data.frame(grupa = sr$grupa, M = sr$wynik[, "M"], SD = sr$wynik[, "SD"])
gora <- ggplot(d, aes(as.numeric(grupa), wynik)) +
  geom_point(aes(colour = grupa, shape = grupa), position = position_jitter(width = 0.12, height = 0, seed = 1),
             size = 2.2, alpha = 0.8) +
  geom_linerange(data = sr, aes(x = as.numeric(grupa) + 0.25, ymin = M - SD, ymax = M + SD), inherit.aes = FALSE) +
  geom_point(data = sr, aes(x = as.numeric(grupa) + 0.25, y = M), inherit.aes = FALSE, size = 2.5) +
  scale_colour_manual(values = kol, guide = "none") + scale_shape_manual(values = ksz, guide = "none") +
  scale_x_continuous(breaks = 1:3, labels = paste0(gr, "\n(n = 25)"), limits = c(0.6, 3.6)) +
  labs(x = NULL, y = "Wynik testu (punkty)")
pol <- rbind(cbind(polowka(boot[, "Trening A"], 2.05), g = "A"), cbind(polowka(boot[, "Trening B"], 3.05), g = "B"))
dol <- ggplot() +
  geom_hline(yintercept = 0, linetype = "dashed", colour = "grey40") +
  geom_polygon(data = pol, aes(x, y, group = g), fill = "grey80", colour = "grey50") +
  geom_errorbar(aes(x = 2:3, ymin = wyn[, "boot_dolna"], ymax = wyn[, "boot_gorna"]), width = 0, linewidth = 1) +
  geom_point(aes(x = 2:3, y = wyn[, "roznica"]), size = 3.5) +
  annotate("text", x = 1, y = 0, label = "odniesienie", colour = "grey30", vjust = -0.6) +
  scale_x_continuous(breaks = 1:3, labels = c("", "A − Kontrola", "B − Kontrola"), limits = c(0.6, 3.6)) +
  labs(x = NULL, y = "Różnica średnich\n(punkty)")
p2 <- (gora / dol) + plot_layout(heights = c(2, 1.3)) & motyw
p1
p2
Wynik w R
      grupa wynik.M wynik.SD
1  Kontrola   20.34     6.32
2 Trening A   24.49     5.96
3 Trening B   20.85     6.47
          roznica boot_dolna boot_gorna welch_dolna welch_gorna     p d_Cohena
Trening A   4.152      0.708      7.440       0.657       7.647 0.021    0.676
Trening B   0.512     -2.844      3.972      -3.127       4.151 0.778    0.080
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (bootstrap i t.test() w pakietach bazowych; rysunki 1–2 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Co pokazuje prawa oś na wykresie Gardnera–Altmana?
Różnicę średnich, a nie wyniki osób. Jej zero leży na wysokości średniej grupy kontrolnej, więc kropka różnicy wypada dokładnie na poziomie średniej drugiej grupy, a pionowy odcinek to 95% przedział ufności tej różnicy.
Czym wykres Cumminga różni się od wykresu Gardnera–Altmana?
Wykres Cumminga to wersja dla trzech i więcej grup: u góry są surowe dane wszystkich grup, a w osobnym panelu pod spodem – różnice względem grupy odniesienia z przedziałami ufności. Przy dwóch grupach osie obok siebie wystarczą.
Jak zrobić wykres Gardnera–Altmana w R?
Policz rozkład bootstrapowy różnicy średnich (losowanie ze zwracaniem osobno w każdej grupie) i jego 2.5 oraz 97.5 percentyl, a potem w ggplot2 narysuj punkty grup, różnicę z przedziałem i drugą oś przez sec_axis(~ . - średnia_kontroli).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Przedział ufności w obrazkach
Sto przedziałów na jednym wykresie, szerokość a liczebność, poziom ufności, skośne dane, SD i przedział predykcji – sześć symulacji z kodem R.
Czytaj →PoradnikBootstrap – wizualizacja na obrazkach
Kulki losowane ze zwracaniem, rozkład średniej i mediany, 1000 badań o tym, kiedy przedział percentylowy zawodzi, różnica median i korelacja – pięć rysunków z kodem R.
Czytaj →PoradnikPorównanie grup na wykresie: od słupka do raincloud
Jeden zbiór na pięciu wykresach w R: słupek ± SE i ± SD, pudełko, skrzypce, punkty z 95% CI i raincloud – co każdy ukrywa, podpisy i zdania do Wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Gardner, M. J., & Altman, D. G. (1986). Confidence intervals rather than P values: Estimation rather than hypothesis testing. BMJ, 292(6522), 746–750. https://doi.org/10.1136/bmj.292.6522.746 ● Otwarty dostęp
- Ho, J., Tumkaya, T., Aryal, S., Choi, H., & Claridge-Chang, A. (2019). Moving beyond P values: Data analysis with estimation graphics. Nature Methods, 16(7), 565–566. https://doi.org/10.1038/s41592-019-0470-3 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{gardner1986confidence, author={Gardner, M. J. and Altman, D. G.}, title={{Confidence intervals rather than P values: Estimation rather than hypothesis testing}}, journal={BMJ}, year={1986}, volume={292}, number={6522}, pages={746--750}, doi={10.1136/bmj.292.6522.746}}@article{ho2019moving, author={Ho, Joses and Tumkaya, Tayfun and Aryal, Sameer and Choi, Hyungwon and Claridge-Chang, Adam}, title={{Moving beyond P values: Data analysis with estimation graphics}}, journal={Nature Methods}, year={2019}, volume={16}, number={7}, pages={565--566}, doi={10.1038/s41592-019-0470-3}}