Co to jest test KPSS?
Test KPSS (Kwiatkowski i in., 1992; nazwa pochodzi od pierwszych liter nazwisk czterech autorów) sprawdza stacjonarność szeregu czasowego, ale z hipotezami ustawionymi odwrotnie niż w teście Dickeya–Fullera. W ADF hipoteza zerowa zakłada pierwiastek jednostkowy (Dickey i Fuller, 1979), a w KPSS – stacjonarność. Duża wartość statystyki KPSS przemawia więc przeciw stacjonarności.
Test ma dwa warianty: stacjonarność wokół stałej średniej (Level) i wokół trendu liniowego (Trend). Statystyka sumuje narastająco reszty z regresji szeregu na stałej (albo na stałej i czasie) i porównuje je z długookresową wariancją reszt. Gdy szereg błądzi, sumy szybko rosną.
Przykład
Na 200 symulowanych obserwacjach szereg z trendem liniowym i stacjonarnymi odchyleniami AR(1) odrzucił stacjonarność wokół stałej (KPSS = 3.90, p < .01), ale nie wokół trendu (KPSS = 0.046, p > .10); ADF = −5.24, p < .01. Dla błądzenia losowego KPSS (trend) = 0.454, p < .01, a ADF = −2.22, p = .485 – oba testy wskazują pierwiastek jednostkowy. Po różnicowaniu: KPSS = 0.067, p > .10.
Na rysunku
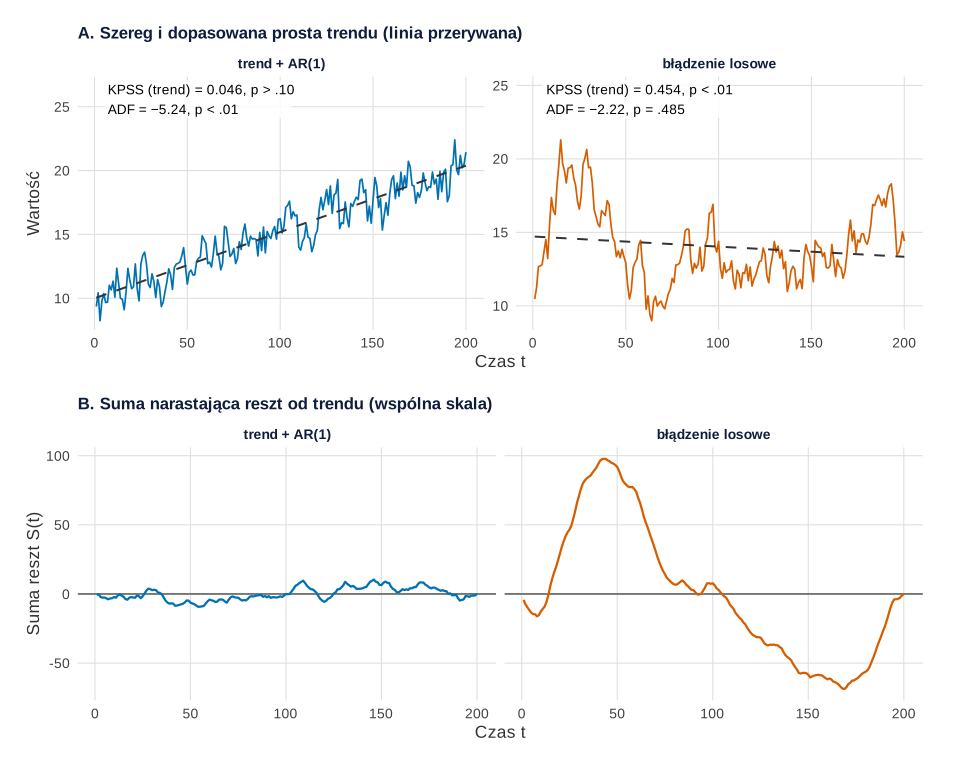
set.seed(6330)).Co widać. Te same dwa szeregi co w przykładzie. Szereg z trendem i odchyleniami AR(1) często przecina prostą trendu, więc reszty szybko zmieniają znak, a ich suma narastająca (panel B) nie odchodzi daleko od zera – największa wartość bezwzględna to 10.4. Błądzenie losowe długo trzyma się po jednej stronie prostej, a suma reszt dochodzi do 97.7. Statystyka KPSS to w uproszczeniu suma kwadratów tych sum podzielona przez n² i wariancję długookresową, dlatego dla błądzenia jest blisko dziesięć razy większa (0.454 wobec 0.046). ADF, z odwrotną hipotezą zerową, daje wniosek zgodny: −5.24 (p < .01) wobec −2.22 (p = .485).
Na co uważać. Prosta trendu w prawym panelu jest lekko opadająca, choć błądzenie losowe nie ma żadnego trendu – to złudzenie typowe dla szeregów z pierwiastkiem jednostkowym (por. korelacja pozorna). Na wykresie nie widać wariancji długookresowej, która jest mianownikiem statystyki i zależy od liczby opóźnień; przy silnej, ale stacjonarnej autokorelacji suma reszt też potrafi się oddalić od zera. Zgodność KPSS i ADF jest tu wyraźna, bo szeregi są modelowe; przy krótkich szeregach testy często się nie zgadzają. Wartości p na etykietach są ucięte do zakresu .01–.10, bo kpss.test() interpoluje je z tablic.
Podpis do pracy:
Ziarno set.seed(6330) to ziarno danych z przykładu; nie było zmieniane. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Szereg trend-stacjonarny i błądzenie losowe: dane z prostą trendu (A) i sumy narastające reszt, z których liczy się KPSS (B)
suppressPackageStartupMessages({library(tseries); library(ggplot2); library(patchwork)})
kol <- c("trend + AR(1)" = "#0072B2", "błądzenie losowe" = "#D55E00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "none",
        plot.background = element_rect(fill = "white", colour = NA))

set.seed(6330)                                           # te same dane co w przykładzie wyżej
n <- 200
e <- rnorm(n)
stac <- 10 + 0.05 * (1:n) + arima.sim(list(ar = 0.5), n)
bl   <- 10 + cumsum(e)
szeregi <- list("trend + AR(1)" = as.numeric(stac), "błądzenie losowe" = bl)
tt <- 1:n
d <- do.call(rbind, lapply(names(szeregi), function(s) {
  x <- szeregi[[s]]
  r <- resid(lm(x ~ tt))                                 # reszty z regresji na stałej i trendzie
  data.frame(szereg = s, t = tt, x = x, trend = fitted(lm(x ~ tt)), S = cumsum(r))
}))
wyniki <- sapply(szeregi, function(x) {
  k <- suppressWarnings(kpss.test(x, null = "Trend")); a <- suppressWarnings(adf.test(x))
  c(KPSS_trend = unname(k$statistic), p_KPSS = k$p.value, ADF = unname(a$statistic), p_ADF = a$p.value)
})
round(wyniki, 3)
round(tapply(abs(d$S), d$szereg, max), 1)                # największa |suma narastająca reszt|

d$szereg <- factor(d$szereg, names(kol))
etyk <- data.frame(szereg = factor(names(kol), names(kol)),
                   tekst = c(sprintf("KPSS (trend) = %.3f, p > .10\nADF = %.2f, p < .01", wyniki[1, 1], wyniki[3, 1]),
                             sprintf("KPSS (trend) = %.3f, p < .01\nADF = %.2f, p = %s", wyniki[1, 2], wyniki[3, 2],
                                     sub("^0", "", sprintf("%.3f", wyniki[4, 2])))))
etyk$tekst <- gsub("-", "\u2212", etyk$tekst)                # znak minus w etykietach
pa <- ggplot(d, aes(t, x, colour = szereg)) +
  geom_line(linewidth = 0.6) +
  geom_line(aes(y = trend), colour = "grey20", linetype = "dashed", linewidth = 0.7) +
  geom_label(data = etyk, aes(x = 5, y = Inf, label = tekst), inherit.aes = FALSE,
             hjust = 0, vjust = 1.1, size = 3.6, linewidth = 0, fill = "white", alpha = 0.85) +
  facet_wrap(~ szereg, scales = "free_y") + scale_colour_manual(values = kol) +
  scale_y_continuous(expand = expansion(mult = c(0.05, 0.35))) +   # miejsce na etykiety nad danymi
  labs(title = "A. Szereg i dopasowana prosta trendu (linia przerywana)", x = "Czas t", y = "Wartość")
pb <- ggplot(d, aes(t, S, colour = szereg)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_line(linewidth = 0.8) +
  facet_wrap(~ szereg) + scale_colour_manual(values = kol) +
  labs(title = "B. Suma narastająca reszt od trendu (wspólna skala)", x = "Czas t", y = "Suma reszt S(t)")
p1 <- (pa / pb) & motyw
p1
Wynik w R (rysunek 1)
           trend + AR(1) błądzenie losowe
KPSS_trend         0.046            0.454
p_KPSS             0.100            0.010
ADF               -5.244           -2.218
p_ADF              0.010            0.485
błądzenie losowe    trend + AR(1)
            97.7             10.4
Jak opisać w pracy
Na co uważać
- Czytaj KPSS razem z ADF. Brak odrzucenia H0 nie dowodzi H0. Gdy ADF odrzuca, a KPSS nie – szereg jest stacjonarny; gdy odwrotnie – różnicuj. Gdy oba odrzucają albo żaden, wynik jest niejednoznaczny: obejrzyj wykres i sprawdź, czy nie ma załamania (test Pettitta).
- Wariant ma znaczenie. Szereg z trendem w wariancie Level prawie zawsze „wypada” niestacjonarnie.
- Wartość p pochodzi z tablic. Funkcja
kpss.test()ucina ją na .01 i .10, więc raportuj p < .01 lub p > .10. - Silna autokorelacja szeregu stacjonarnego może prowadzić do zbyt częstego odrzucania H0; wynik zależy też od liczby opóźnień w estymacji wariancji długookresowej.
Test KPSS w R
Kod symuluje trzy szeregi i dla każdego liczy KPSS w obu wariantach oraz ADF. Liczby w tekście pochodzą z tego kodu.
KPSS (Level i Trend) i ADF dla trzech szeregów
R
suppressMessages(library(tseries))
set.seed(6330)
n <- 200
e <- rnorm(n)
stac <- 10 + 0.05 * (1:n) + arima.sim(list(ar = 0.5), n)  # trend + stacjonarne odchylenia
bl   <- 10 + cumsum(e)                                     # błądzenie losowe
wyn <- function(x, nazwa) {
  k1 <- suppressWarnings(kpss.test(x, null = "Level"))
  k2 <- suppressWarnings(kpss.test(x, null = "Trend"))
  a  <- suppressWarnings(adf.test(x))
  data.frame(szereg = nazwa, KPSS_poziom = round(k1$statistic, 3), p_poziom = round(k1$p.value, 3),
             KPSS_trend = round(k2$statistic, 3), p_trend = round(k2$p.value, 3),
             ADF = round(a$statistic, 2), p_ADF = round(a$p.value, 3), row.names = NULL)
}
rbind(wyn(stac, "trend + AR(1)"), wyn(bl, "błądzenie losowe"), wyn(diff(bl), "różnice błądzenia"))
Wynik w R
             szereg KPSS_poziom p_poziom KPSS_trend p_trend   ADF p_ADF
1     trend + AR(1)       3.903    0.010      0.046    0.10 -5.24 0.010
2  błądzenie losowe       0.570    0.026      0.454    0.01 -2.22 0.485
3 różnice błądzenia       0.067    0.100      0.067    0.10 -6.75 0.010
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem tseries 0.10-61. Rysunek 1 wykonano w pakietach ggplot2 4.0.2 i patchwork 1.3.2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- tseries (wersja 0.10.61): Trapletti, A., & Hornik, K. (2026). tseries: Time series analysis and computational finance (R package version 0.10-61) [Computer software]. https://doi.org/10.32614/CRAN.package.tseries
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Dlaczego test KPSS i test ADF mogą dać sprzeczne wyniki?
Bo mają odwrócone hipotezy i oba mają ograniczoną moc. Jeśli ADF nie odrzuca pierwiastka jednostkowego, a KPSS nie odrzuca stacjonarności, dane po prostu nie rozstrzygają sprawy – często przy krótkim szeregu. Jeśli oba odrzucają swoje H0, przyczyną bywa załamanie strukturalne albo bardzo trwała, ale stacjonarna zależność.
Który wariant testu KPSS wybrać: Level czy Trend?
Zdecyduj na podstawie wykresu i teorii: gdy szereg waha się wokół stałego poziomu, użyj wariantu Level; gdy wyraźnie rośnie lub maleje liniowo, użyj wariantu Trend. Szereg z trendem testowany wariantem Level prawie zawsze odrzuci stacjonarność, co nie znaczy, że trzeba go różnicować.
Jak wykonać test KPSS w R?
W pakiecie tseries służy do tego kpss.test(x, null = "Level") lub kpss.test(x, null = "Trend"). Funkcja ndiffs() z pakietu forecast domyślnie używa testu KPSS, aby wskazać liczbę różnicowań potrzebnych do uzyskania stacjonarności.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dickey, D. A., & Fuller, W. A. (1979). Distribution of the estimators for autoregressive time series with a unit root. Journal of the American Statistical Association, 74(366a), 427–431. https://doi.org/10.1080/01621459.1979.10482531 ● Otwarty dostęp: pełny tekst
- Kwiatkowski, D., Phillips, P. C. B., Schmidt, P., & Shin, Y. (1992). Testing the null hypothesis of stationarity against the alternative of a unit root. Journal of Econometrics, 54(1–3), 159–178. https://doi.org/10.1016/0304-4076(92)90104-y
Cytowania BibTeX
@article{dickey1979distribution, author={Dickey, David A. and Fuller, Wayne A.}, title={{Distribution of the estimators for autoregressive time series with a unit root}}, journal={Journal of the American Statistical Association}, year={1979}, volume={74}, number={366a}, pages={427--431}, doi={10.1080/01621459.1979.10482531}}@article{kwiatkowski1992testing, author={Kwiatkowski, Denis and Phillips, Peter C. B. and Schmidt, Peter and Shin, Yongcheol}, title={{Testing the null hypothesis of stationarity against the alternative of a unit root}}, journal={Journal of Econometrics}, year={1992}, volume={54}, number={1–3}, pages={159--178}, doi={10.1016/0304-4076(92)90104-y}}