Kim był Rensis Likert?
Rensis Likert (1903–1981) był amerykańskim psychologiem społecznym i organizatorem badań sondażowych. Kish (1990) podaje, że urodził się w 1903 r. w Cheyenne w stanie Wyoming, w 1922 r. zaczął studiować inżynierię lądową na University of Michigan, ale na ostatnim roku, w 1926 r., przeniósł się na socjologię i ekonomię, a doktorat z psychologii zrobił na Columbia University. Jego praca doktorska, wydana w 1932 r. jako „A technique for the measurement of attitudes” (Likert, 1932), dała nazwę skali Likerta – narzędziu, z którym spotyka się prawie każdy autor ankiety.
Stetz (2025) przypomina, że skala to tylko część jego dorobku: Likert rozwijał techniki wywiadu sondażowego, nadzorował prace nad doborem losowym prób, współtworzył rachunkowość zasobów ludzkich i teorię zarządzania organizacjami, a także kierował kilkoma wpływowymi instytucjami badawczymi. Z University of Michigan związany był Institute for Social Research (ISR), założony w 1946 r.; sam Likert (1978) opisywał, jak zarządzać tym interdyscyplinarnym instytutem. Zmarł w 1981 r. (Kish, 1990).
Najważniejsze pomysły
- Skala sumaryczna (1932). W monografii Likert (1932) opisał metodę sigma i prostszą metodę punktowania odpowiedzi, sprawdził rzetelność i trafność skal postaw i porównał je z metodą Louisa Thurstone’a. Według Kisha (1990) pokazał empirycznie, że prosta skala pięciostopniowa daje wyniki bardzo podobne do znacznie bardziej pracochłonnej skali Thurstone’a.
- Wynik to suma, nie jedna odpowiedź. Istotą pomysłu jest łączenie odpowiedzi na kilka stwierdzeń o tym samym konstrukcie w jeden wynik – dlatego mówi się o skali sumarycznej (summated rating scale), a nie o samym formacie „zgadzam się – nie zgadzam się”.
- Badania sondażowe. Pod jego kierunkiem rozwijano procedury doboru prób losowych i techniki wywiadu (Stetz, 2025); ISR, którego zasady działania opisał Likert (1978), prowadził badania na dużą skalę.
- Zarządzanie. Pisał o kierowaniu ludźmi w organizacjach, m.in. w książce „New Patterns of Management” (Likert, 1961); Stetz (2025) zalicza teorię zarządzania do jego głównych osiągnięć.
Ciekawostka
Nazwisko pada na zajęciach z metodologii niemal codziennie, a mało kto zastanawia się, jak je wymówić. Stetz (2025) zaczyna rozdział o Likercie właśnie od tej sprawy: poprawnie brzmi ono „Lick-urt”, a nie „Like-urt” – czyli z krótkim „i”, mniej więcej tak, jak „Likert” przeczytane po polsku, a nie „Lajkert”.
Druga mało znana rzecz: Likert zaczynał jako student inżynierii lądowej (Kish, 1990). Kish widzi ślad tego wykształcenia w samej skali – to pomysł pragmatyczny i inżynierski: zamiast teoretycznie eleganckiej, ale żmudnej procedury wybrał prosty sposób punktowania, który w praktyce dawał niemal to samo.
Przykład na danych kwestionariuszowych
Danych Likerta z 1932 r. nie ma w pakietach R, więc bierzemy prawdziwe dane współczesne: zbiór bfi z pakietu psych. Według pliku pomocy to 25 pozycji osobowości z puli IPIP, zebranych w internetowym projekcie SAPA od 2800 osób na skali od 1 (bardzo nietrafne) do 6 (bardzo trafne). Bierzemy pięć pozycji neurotyczności N1–N5, sformułowanych w tym samym kierunku (np. N1 „Łatwo się złoszczę”), więc nie trzeba niczego odwracać. Kompletne odpowiedzi ma 2694 osoby.
Pojedyncza pozycja przyjmuje tylko 6 wartości, a suma pięciu – 26 (od 5 do 30; M = 15.82, SD = 5.97). Na N1 aż 23.4% osób zaznaczyło 1, a tylko 7.1% – 6. Korelacja każdej pozycji z sumą pozostałych czterech wynosi od .49 (N5) do .67 (N3): każda pozycja mierzy wspólną cechę tylko częściowo, a suma uśrednia ich swoiste błędy.
Drugie porównanie nawiązuje do monografii z 1932 r. Policzyliśmy wynik na dwa sposoby: prostymi punktami 1–6 oraz punktowaniem normalizującym, w którym każda kategoria dostaje średnią z odcinka rozkładu normalnego odpowiadającego jej odsetkowi odpowiedzi (wariant w duchu metody sigma). Oba wyniki korelują na poziomie r = .996 (rho Spearmana = .997) – prosta suma porządkuje osoby praktycznie tak samo. To nasze przeliczenie na danych bfi, nie wynik z pracy Likerta.
Na rysunku
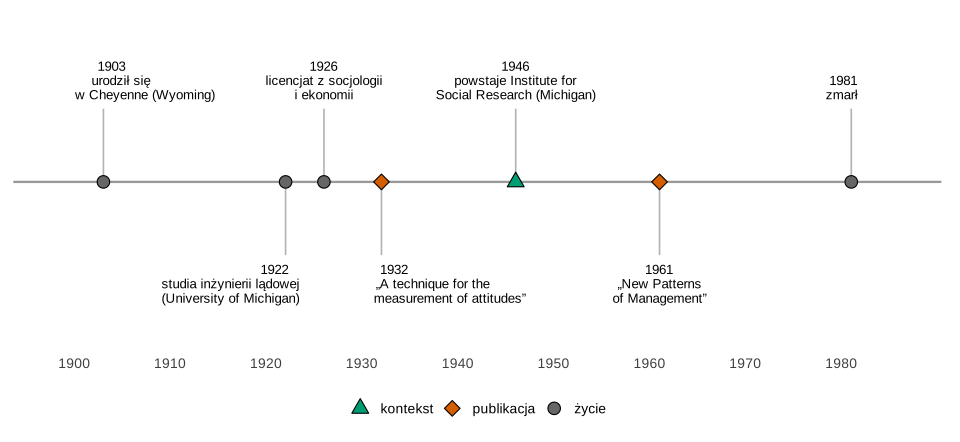
Co widać. Skala powstała jako praca doktorska młodego badacza, sześć lat po zmianie kierunku studiów z inżynierii na nauki społeczne. Późniejsze daty dotyczą już badań sondażowych w Michigan i teorii zarządzania.
Na co uważać. Oś pokazuje tylko zdarzenia, których daty podają cytowane źródła. Nie ma na niej np. pracy Likerta dla administracji federalnej przed 1946 r. ani lat kierowania ISR, bo nie mogliśmy ich sprawdzić w źródłach, które przeczytaliśmy.
Podpis do pracy:
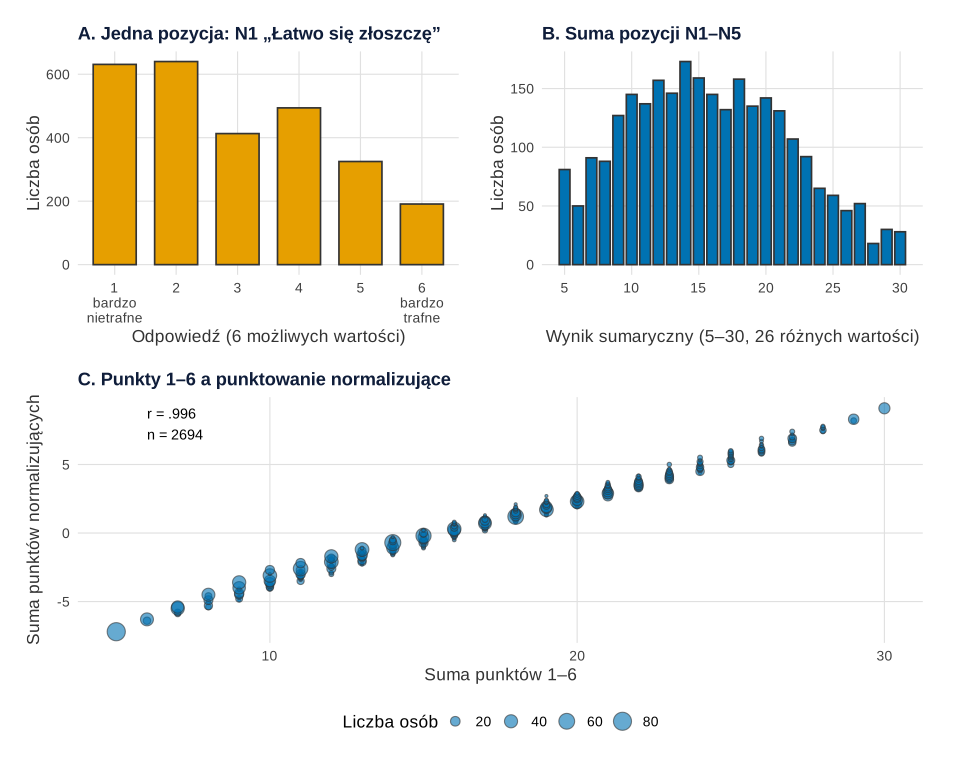
psych::bfi (n = 2694). Obliczenia i rysunek: R, pakiety psych, ggplot2 i patchwork (dane rzeczywiste, bez losowania).Co widać. Panel A to sześć słupków – tyle informacji niesie jedna odpowiedź. Panel B to już 26 wartości i rozkład znacznie bliższy ciągłemu, choć nadal lekko prawoskośny. Panel C pokazuje, że osoby ułożone według prostej sumy i według punktowania normalizującego tworzą niemal idealną rosnącą linię: korelacja wynosi .996.
Na co uważać. Wysoka zgodność dwóch sposobów punktowania nie dowodzi, że odstępy między kategoriami są równe – mówi tylko, że w tych danych wybór punktacji prawie nie zmienia uporządkowania osób. Rozkład sumy zależy też od tego, czy pozycje mierzą jedną cechę; przy pozycjach z różnych konstruktów suma traci sens bez względu na punktację.
Podpis do pracy:
Gdzie spotkasz Likerta w swojej pracy
Za każdym razem, gdy w ankiecie pytasz o stopień zgody i liczysz z kilku pozycji jeden wynik, korzystasz z pomysłu Likerta. W praktyce:
- wynik skali liczysz po przekodowaniu pozycji odwróconych i dopiero wtedy opisujesz go średnią i SD – zasady zebrało hasło skala Likerta;
- liczbę kategorii i ich etykiety dobierasz świadomie – zob. Ile stopni skali Likerta wybrać? i hasło kafeteria odpowiedzi;
- przed zsumowaniem sprawdzasz spójność wewnętrzną, najczęściej współczynnikiem alfa Lee Cronbacha;
- rozkłady odpowiedzi na pojedyncze pozycje pokazujesz na rozbieżnym wykresie skumulowanym, a nie średnimi.
Spory, mity i trudne strony
- Pozycja czy skala? Nazwą „skala Likerta” określa się dziś zarówno jedno pytanie z pięcioma odpowiedziami, jak i cały zestaw pozycji. U Likerta (1932) chodziło o to drugie: o wynik sumaryczny wielu pozycji. Pojedyncza pozycja to raczej „pozycja typu Likerta”.
- Średnia czy mediana? Spór o to, czy odpowiedzi można traktować jak liczby, wiąże się z poziomami pomiaru Stanleya Smitha Stevensa: pojedyncza pozycja jest porządkowa, a wynik wielu pozycji bywa analizowany jak ilościowy. Argumenty obu stron zebrał wpis Skala Likerta: średnia czy mediana?.
- Pięć kategorii to nie dogmat. Kish (1990) pisze o skali pięciostopniowej, ale istotą metody jest sumowanie, a nie liczba odpowiedzi – dane bfi z przykładu mają sześć kategorii i działają tak samo.
Pozycja a wynik sumaryczny w R
Kod wczytuje dane bfi z pakietu psych, liczy wynik sumaryczny pięciu pozycji neurotyczności, korelacje pozycja–reszta oraz zgodność prostej punktacji 1–6 z punktowaniem normalizującym, a na końcu rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. Pozycja, suma i dwie punktacje: rysunek 2
Kod R rysunku 2
# Rensis Likert: pojedyncza pozycja a wynik sumaryczny; punkty 1–6 a punktowanie normalizujące (psych::bfi)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(poz = "#E69F00", suma = "#0072B2", pkt = "grey25")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(bfi, package = "psych")
# N1–N5: pięć pozycji neurotyczności (1 = bardzo nietrafne … 6 = bardzo trafne), wszystkie w tym samym kierunku
poz <- c("N1", "N2", "N3", "N4", "N5")
d <- na.omit(bfi[, poz])
n <- nrow(d)
suma <- rowSums(d)                                   # prosty wynik Likerta: suma punktów 1–6
# Punktowanie normalizujące: kategoria dostaje średnią z odcinka rozkładu normalnego,
# który odpowiada jej odsetkowi odpowiedzi w próbie
sigma_punkty <- function(x) {
  p <- cumsum(prop.table(table(factor(x, levels = 1:6))))
  gora <- qnorm(pmin(p, 1)); dol <- qnorm(c(0, head(p, -1)))
  w <- (dnorm(dol) - dnorm(gora)) / diff(c(0, p))
  unname(w[x])
}
suma_sigma <- rowSums(sapply(d, sigma_punkty))
# Ile różnych wartości przyjmuje jedna pozycja, a ile suma pięciu
c(n = n, wartosci_N1 = length(unique(d$N1)), wartosci_sumy = length(unique(suma)))
round(c(M_sumy = mean(suma), SD_sumy = sd(suma), min = min(suma), max = max(suma)), 2)
# Odsetki odpowiedzi na N1 (proc.)
round(100 * prop.table(table(d$N1)), 1)
# Korelacja każdej pozycji z sumą czterech pozostałych (pozycja – reszta)
round(sapply(poz, function(v) cor(d[[v]], rowSums(d[, setdiff(poz, v)]))), 3)
# Punkty 1–6 a punktowanie normalizujące: zgodność wyników sumarycznych
round(c(r_Pearsona = cor(suma, suma_sigma), r_Spearmana = cor(suma, suma_sigma, method = "spearman")), 4)

# Rysunek 2A: rozkład jednej pozycji (N1)
etyk <- c("1\nbardzo\nnietrafne", "2", "3", "4", "5", "6\nbardzo\ntrafne")
pA <- ggplot(data.frame(odp = factor(d$N1, levels = 1:6)), aes(odp)) +
  geom_bar(fill = kol[["poz"]], colour = "grey20", width = 0.7) +
  scale_x_discrete(labels = etyk, drop = FALSE) +
  labs(title = "A. Jedna pozycja: N1 „Łatwo się złoszczę”", x = "Odpowiedź (6 możliwych wartości)", y = "Liczba osób") +
  motyw
# Rysunek 2B: rozkład sumy pięciu pozycji
pB <- ggplot(data.frame(suma = suma), aes(suma)) +
  geom_bar(fill = kol[["suma"]], colour = "grey20", width = 0.8) +
  scale_x_continuous(breaks = seq(5, 30, by = 5)) +
  labs(title = "B. Suma pozycji N1–N5", x = sprintf("Wynik sumaryczny (5–30, %d różnych wartości)", length(unique(suma))), y = "Liczba osób") +
  motyw
# Rysunek 2C: suma punktów 1–6 a suma punktów normalizujących (rozmiar punktu = liczba osób)
pary <- aggregate(list(liczba = rep(1, n)), list(suma = suma, sigma = round(suma_sigma, 1)), sum)
pC <- ggplot(pary, aes(suma, sigma)) +
  geom_point(aes(size = liczba), shape = 21, fill = kol[["suma"]], colour = "grey20", alpha = 0.6) +
  annotate("text", x = 6, y = max(pary$sigma), hjust = 0, vjust = 1, size = 3.8,
           label = sprintf("r = %s\nn = %d", sub("^0", "", sprintf("%.3f", cor(suma, suma_sigma))), n)) +
  scale_size_area(max_size = 6, name = "Liczba osób") +
  labs(title = "C. Punkty 1–6 a punktowanie normalizujące", x = "Suma punktów 1–6", y = "Suma punktów normalizujących") +
  motyw
p2 <- (pA + pB) / pC + plot_layout(heights = c(1, 1.1))
p2
Wynik w R
            n   wartosci_N1 wartosci_sumy
         2694             6            26
 M_sumy SD_sumy     min     max
  15.82    5.97    5.00   30.00

   1    2    3    4    5    6
23.4 23.8 15.3 18.3 12.1  7.1
   N1    N2    N3    N4    N5
0.666 0.651 0.673 0.542 0.487
 r_Pearsona r_Spearmana
     0.9958      0.9972
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Rensis Likert, 1903–1981 – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1903, 1922, 1926, 1932, 1946, 1961, 1981),
  opis = c("urodził się\nw Cheyenne (Wyoming)", "studia inżynierii lądowej\n(University of Michigan)", "licencjat z socjologii\ni ekonomii",
           "„A technique for the\nmeasurement of attitudes”", "powstaje Institute for\nSocial Research (Michigan)", "„New Patterns\nof Management”", "zmarł"),
  rodzaj = c("życie", "życie", "życie", "publikacja", "kontekst", "publikacja", "życie"))
zdarzenia$strona <- rep(c(1, -1), length.out = nrow(zdarzenia))   # etykiety na przemian nad i pod osią
zdarzenia$wyrownanie <- c(0.2, 0.9, 0.5, 0.05, 0.5, 0.5, 0.8)        # rozsunięcie bliskich etykiet (1922 i 1932)
ksztalty <- c("życie" = 21, "publikacja" = 23, "kontekst" = 24)
kolory <- c("życie" = "grey40", "publikacja" = "#D55E00", "kontekst" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = 0.55 * strona), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 4, colour = "black") +
  geom_text(aes(y = 0.62 * strona, label = paste0(rok, "\n", opis), vjust = ifelse(strona > 0, 0, 1), hjust = wyrownanie), size = 3.5, lineheight = 0.9) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1898, 1986), breaks = seq(1900, 1980, by = 10)) +
  scale_y_continuous(limits = c(-1.15, 1.15)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (dane – pakiet psych; korelacje i punktowanie – funkcje bazowe cor(), qnorm(), dnorm(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Rensis Likert?
Amerykańskim psychologiem społecznym (1903–1981). Studiował inżynierię, socjologię i ekonomię na University of Michigan, doktorat z psychologii zrobił na Columbia University, a jego praca doktorska z 1932 r. o pomiarze postaw dała początek skali Likerta. Później rozwijał badania sondażowe w Institute for Social Research w Michigan i teorię zarządzania.
Jak poprawnie wymawia się nazwisko Likert?
Z krótkim „i”: „Lick-urt”, a nie „Like-urt” – tak zaznacza Stetz (2025) w rozdziale o Likercie. Po polsku najbliżej jest więc wymowa „Likert”, zgodna z pisownią, a nie „Lajkert”.
Czy pięć odpowiedzi od „zdecydowanie się nie zgadzam” do „zdecydowanie się zgadzam” to już skala Likerta?
To dopiero pozycja typu Likerta. W monografii z 1932 r. istotą metody było zsumowanie odpowiedzi na wiele stwierdzeń o tym samym konstrukcie w jeden wynik. Liczba kategorii nie jest tu najważniejsza – sens ma dopiero suma lub średnia wielu pozycji.
Co poza skalą zawdzięczamy Likertowi?
Rozwój badań sondażowych: pod jego kierunkiem doskonalono dobór losowy prób i techniki wywiadu, a z University of Michigan związany był Institute for Social Research, założony w 1946 r. Pisał też o zarządzaniu, m.in. w książce „New Patterns of Management” (1961).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Ile stopni skali Likerta wybrać?
4, 5, 7 czy więcej punktów: co mówią badania, środek skali, etykiety, tabela decyzyjna, symulacja w R i wzór opisu do pracy.
Czytaj →PoradnikSkala Likerta: średnia czy mediana?
Pozycja jest porządkowa, wynik skali – zwykle ilościowy. Kiedy mediana i odsetki, kiedy M, SD i test t, z przykładem w R i opisem APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Kish, L. (1990). A CHOICES profile: Rensis Likert: Social scientist and entrepreneur. Choices, 5(4), 1–3. https://doi.org/10.22004/ag.econ.131305 ● Otwarty dostęp: pełny tekst
- Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 5–55. https://archive.org/details/likert-1932
- Likert, R. (1961). New patterns of management. McGraw-Hill.
- Likert, R. (1978). Managing an interdisciplinary research institute: The Institute for Social Research. Academy of Management Proceedings, 1978(1), 384–388. https://doi.org/10.5465/ambpp.1978.4977421
- Stetz, T. A. (2025). Rensis Likert (1903–1981). In L. Koppes Bryan & A. J. Vinchur (Eds.), Key thinkers in industrial and organizational psychology (pp. 230–236). Routledge. https://doi.org/10.4324/9781003403258-30
Cytowania BibTeX
@article{kish1990likert, author={Kish, Leslie}, title={{A CHOICES profile: Rensis Likert: Social scientist and entrepreneur}}, journal={Choices}, year={1990}, volume={5}, number={4}, pages={1--3}, doi={10.22004/ag.econ.131305}}@article{likert1932technique, author={Likert, Rensis}, title={{A technique for the measurement of attitudes}}, journal={Archives of Psychology}, year={1932}, volume={22}, number={140}, pages={5--55}, url={https://archive.org/details/likert-1932}}@book{likert1961new, author={Likert, Rensis}, title={{New patterns of management}}, year={1961}, publisher={McGraw-Hill}}@article{likert1978managing, author={Likert, Rensis}, title={{Managing an interdisciplinary research institute: The Institute for Social Research}}, journal={Academy of Management Proceedings}, year={1978}, volume={1978}, number={1}, pages={384--388}, doi={10.5465/ambpp.1978.4977421}}@incollection{stetz2025likert, author={Stetz, Thomas A.}, title={{Rensis Likert (1903–1981)}}, booktitle={Key thinkers in industrial and organizational psychology}, year={2025}, pages={230--236}, publisher={Routledge}, doi={10.4324/9781003403258-30}}