Kim był Georg Rasch?
Georg Rasch (1901–1980) urodził się 21 września 1901 r. w Odense (Wright, 1980). Studiował matematykę na Uniwersytecie Kopenhaskim i w 1930 r., mając 29 lat, uzyskał doktorat za rozprawę o rachunku macierzowym i jego zastosowaniach w teorii równań różniczkowych i różnicowych. Uchodził za jednego z najzdolniejszych duńskich matematyków młodego pokolenia, ale nie stworzono dla niego odpowiedniego stanowiska, więc został konsultantem w dziedzinie analizy danych i statystyki (Andersen, 1982).
W połowie lat 30. pracował w Londynie u Ronalda Fishera, którego idee – największa wiarygodność, statystyki dostateczne – przeniósł do Danii (Andersen, 1982; Wright, 1980). W latach 1940–1956 kierował założonym przez siebie działem biostatystyki Państwowego Instytutu Surowic, gdzie terminowało u niego niemal całe następne pokolenie duńskich statystyków, m.in. Anders Hald. O katedrę statystyki Uniwersytetu Kopenhaskiego postarał się dopiero w 1961 r., mając prawie 60 lat; profesorem był w latach 1962–1972. Zmarł w 1980 r. w wieku 79 lat (Andersen, 1982).
Najważniejsze pomysły
- Model Rascha. Według Andersena (1982) psychologia i pedagogika zajęły Rascha na dobre od połowy lat 50., gdy był konsultantem ministerstwa spraw społecznych, wojskowej służby psychologicznej i Duńskiego Instytutu Badań Pedagogicznych; Wright (1980) wymienia wcześniejsze zlecenia – standaryzację testu inteligencji dla ministerstwa obrony w 1945 r. i badanie czytania na początku lat 50. Rasch odrzucił metody oparte na analizie czynnikowej i w 1960 r. w pełni sformułował model, w którym szansa poprawnej odpowiedzi zależy tylko od różnicy między zdolnością osoby a trudnością zadania (Andersen, 1982; Rasch, 1960/1980).
- Model Poissona dla czytania. Punktem wyjścia były powtarzane testy głośnego czytania młodzieży z trudnościami w nauce: Rasch opisał szybkość i liczbę błędów multiplikatywnym modelem opartym na rozkładzie Poissona – osobny parametr dla osoby, osobny dla tekstu (Wright, 1980).
- Wnioskowanie warunkowe i obiektywność specyficzna. Liczba poprawnych odpowiedzi jest statystyką dostateczną dla zdolności, więc po warunkowaniu na niej parametry osób znikają z wiarygodności, a trudności zadań da się oszacować bez nich. Rasch nazwał tę własność obiektywnością specyficzną: porównanie zadań nie zależy od tego, kto je rozwiązywał, a porównanie osób – od tego, jakie zadania dostały (Wright, 1980). Andersen (1970) udowodnił, że estymatory warunkowej metody największej wiarygodności są zgodne, a Andersen (1973) zbudował na nich test dopasowania modelu.
Ciekawostka
Najważniejszą własność swojego modelu Rasch zrozumiał w pełni podczas rozmowy z ekonomistą. Na jubileuszu Uniwersytetu Kopenhaskiego w 1959 r. tłumaczył norweskiemu ekonomiście Ragnarowi Frischowi model Poissona na przykładzie szybkości czytania: jeśli warunkuje się na łącznej liczbie słów przeczytanych w dwóch tekstach, podział tej liczby między teksty zależy tylko od ich trudności, a parametr ucznia się skraca. Frisch – jak wspominał sam Rasch – wykrzyknął kilka razy: „It was eliminated, that is most interesting!” (Wright, 1980).
Od tej uwagi Rasch zaczął traktować rozdzielenie parametrów osób i zadań jako zasadniczą cechę całej klasy modeli. Rok później L. J. Savage sprowadził go z wykładami do Chicago; słuchał ich Benjamin Wright, który potem uznał książkę Rascha za najważniejsze dzieło psychometrii od czasów Thurstone’a (Wright, 1980).
Przykład: pięć zadań testu LSAT
Używamy klasycznych danych z pakietu ltm: odpowiedzi 1000 osób na 5 zadań sekcji VI testu Law School Admission Test – według pliku pomocy pochodzą one z pracy Bocka i Liebermana z 1970 r.. Odsetki poprawnych odpowiedzi wynoszą od .553 (Z3) do .924 (Z1); 298 osób rozwiązało wszystko, a 3 nic. Warunkowa metoda największej wiarygodności (pakiet eRm) daje trudności od −1.256 (Z1, SE = 0.104) do 1.236 (Z3, SE = 0.069) logita.
Ten sam model można dopasować jako regresję logistyczną z osobnym efektem każdej osoby i każdego zadania. Wtedy 699 osób z wynikiem od 1 do 4 wymaga 703 parametrów, a trudności wychodzą 1.27 razy bardziej rozciągnięte (np. Z3: 1.629 zamiast 1.236). To problem parametrów ubocznych opisany przez Andersena (1970) – i powód, dla którego Rasch warunkował na wyniku surowym, tak jak robi to warunkowa regresja logistyczna.
Obiektywność specyficzną widać wprost w liczbach. Bierzemy osoby, które rozwiązały dokładnie jedno z pary zadań Z1 i Z3: logarytm ilorazu „rozwiązało Z1” do „rozwiązało Z3” wynosi 2.69, 2.87 i 2.45 w grupach z 1, 2 i 3 poprawnymi odpowiedziami w pozostałych zadaniach, a model przewiduje 2.49 niezależnie od zdolności. Wreszcie test ilorazu wiarygodności Andersena, porównujący trudności oszacowane osobno u słabszych (wynik 0–3) i mocniejszych (4–5), daje LR = 0.168, df = 4, p = .997 – brak śladu niedopasowania.
Na rysunku
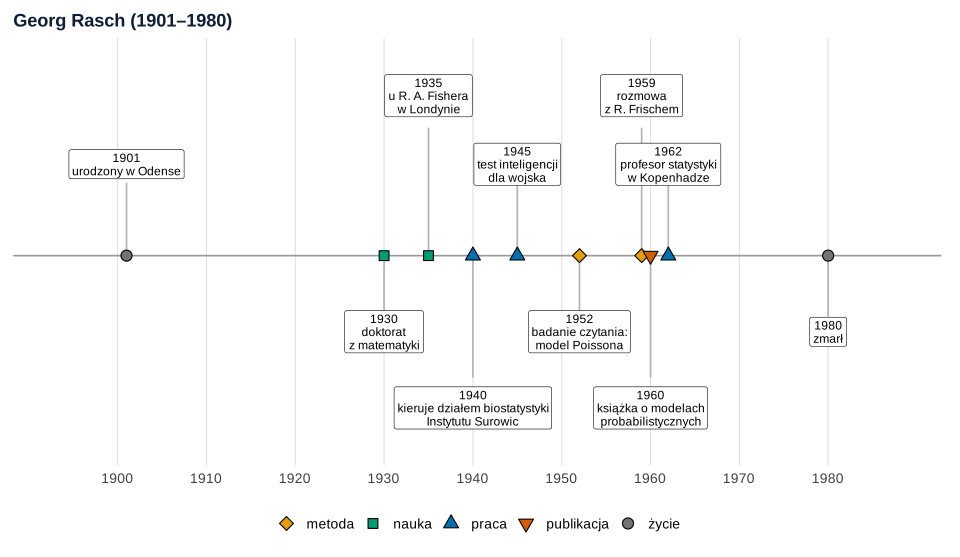
Co widać. Przez trzydzieści lat Rasch był matematykiem i biostatystykiem; zdarzenia związane z modelem mieszczą się w latach 1945–1962, a sama teoria powstała – jak pisze Andersen (1982) – w ciągu trzech, czterech lat.
Na co uważać. Źródła różnią się w szczegółach: Wright (1980) datuje przyjazd do Fishera na wrzesień 1934 r., Andersen (1982) na lata 1935–1936; badanie czytania przypada na lata 1951–1952 zależnie od relacji, a Andersen (1982) pisze, że zastosowaniami w psychologii Rasch zajął się dopiero w połowie lat 50. Na osi przyjęto lata 1935 i 1952.
Podpis do pracy:
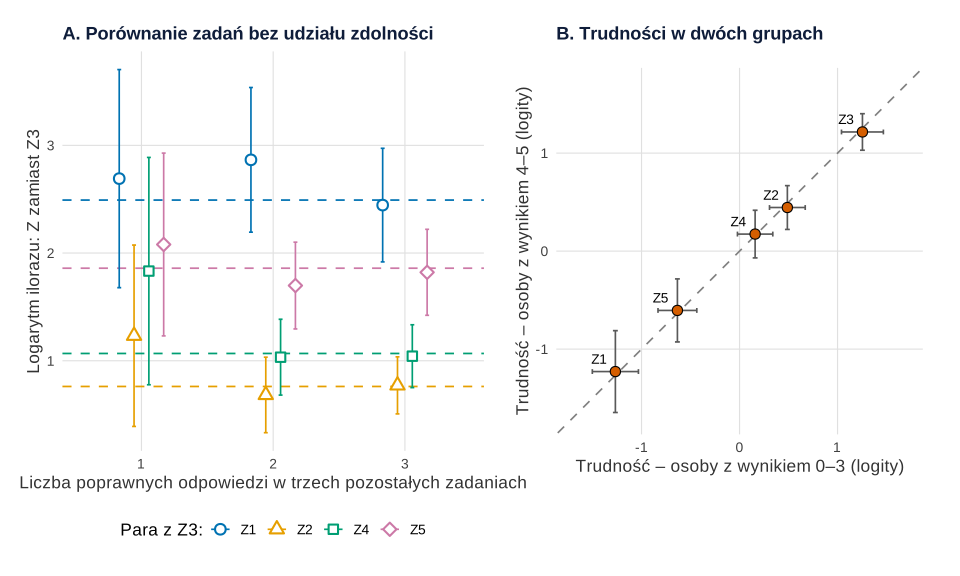
Co widać. Na panelu A porównanie dwóch zadań daje mniej więcej tę samą liczbę w każdej grupie zdolności – po to Rasch skonstruował swój model. Na panelu B trudności z dwóch grup osób leżą na przekątnej.
Na co uważać. Test ma tylko pięć łatwych zadań, więc grupy z niskim wynikiem są małe, a przedziały szerokie. Grupa „3” na panelu A to dla wszystkich par ten sam wzorzec odpowiedzi (wszystko poprawnie poza jednym zadaniem), więc te punkty nie są niezależne.
Podpis do pracy:
Gdzie spotkasz Rascha w swojej pracy
- Walidacja testu lub skali. Gdy analizujesz test wiedzy albo kwestionariusz, model Rascha sprawdza, czy pozycje tworzą jedną skalę – zob. model Rascha krok po kroku, mapę Wrighta i krzywą charakterystyczną pozycji.
- Oceny sędziów. Gdy wynik zależy też od surowości oceniającego, stosuje się wieloaspektowy model Rascha.
- Szersza teoria IRT. Model Rascha to najprostszy model teorii odpowiedzi na pozycje, którą w USA rozwijał Frederic Lord.
Spory, mity i trudne strony
- Model czy dane? Rasch nie przyjmował modelu na wiarę: zanim go zaakceptował, sprawdzał dopasowanie setkami prostych tabel i wykresów (Andersen, 1982).
- Trudny człowiek. Andersen (1982) pisze w nekrologu, że współpraca z Raschem bywała trudna, ale tym, którzy przyjęli jego styl i pracowali z nim blisko, okazywał otwartość, hojność i lojalność.
Rasch w R
Kod rysuje oś czasu, dopasowuje model Rascha do danych LSAT warunkową metodą największej wiarygodności (eRm) i jako regresję logistyczną z efektami osób i zadań (glm), liczy porównania par zadań w grupach zdolności i test Andersena. Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
rozkład wyników, odsetki poprawnych odpowiedzi, trudności z CML i JML, porównania par zadań z Z3 w grupach zdolności i test Andersena z trudnościami w dwóch grupach.
Kod R rysunków 1 i 2
# Georg Rasch: oś czasu i model Rascha na danych LSAT (sekcja VI, 1000 osób, 5 zadań)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(eRm)})
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", zielony = "#009E73",
        fiolet = "#CC79A7", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu (lata według Andersena 1982 i przedmowy Wrighta do wydania z 1980 r.)
zdarzenia <- data.frame(
  rok = c(1901, 1930, 1935, 1940, 1945, 1952, 1959, 1960, 1962, 1980),
  opis = c("urodzony w Odense", "doktorat\nz matematyki", "u R. A. Fishera\nw Londynie", "kieruje działem biostatystyki\nInstytutu Surowic",
           "test inteligencji\ndla wojska", "badanie czytania:\nmodel Poissona", "rozmowa\nz R. Frischem",
           "książka o modelach\nprobabilistycznych", "profesor statystyki\nw Kopenhadze", "zmarł"),
  rodzaj = c("życie", "nauka", "nauka", "praca", "praca", "metoda", "metoda", "publikacja", "praca", "życie"))
zdarzenia$y <- c(1.2, -1, 2.1, -2, 1.2, -1, 2.1, -2, 1.2, -1)   # wysokość etykiet, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = rok, yend = y * 0.8), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(y = y, label = paste0(rok, "\n", opis)), size = 3.2, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c("życie" = 21, "nauka" = 22, "praca" = 24, "metoda" = 23, "publikacja" = 25), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["szary"]], "nauka" = oi[["zielony"]], "praca" = oi[["niebieski"]],
                               "metoda" = oi[["pomaranczowy"]], "publikacja" = oi[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1900, 1980, 10), limits = c(1893, 1988)) + scale_y_continuous(limits = c(-2.5, 2.6)) +
  labs(title = "Georg Rasch (1901–1980)", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. Dane: Law School Admission Test, sekcja VI (Bock i Lieberman 1970), odpowiedzi 0/1
data(LSAT, package = "ltm")
X <- as.matrix(LSAT)
colnames(X) <- paste0("Z", 1:5)
table(wynik = rowSums(X))
round(colMeans(X), 3)                       # odsetek poprawnych odpowiedzi

# 3. Model Rascha warunkową metodą największej wiarygodności (CML): wynik surowy jest statystyką
#    dostateczną dla zdolności, więc po warunkowaniu na nim parametry osób znikają z wiarygodności.
m_cml <- RM(X)
trudnosc_cml <- setNames(-m_cml$betapar, colnames(X))   # eRm podaje łatwość; trudność = −łatwość (suma = 0)
round(cbind(trudnosc = trudnosc_cml, SE = m_cml$se.beta), 3)

# 4. Ten sam model jako regresja logistyczna z efektem każdej osoby i każdego zadania (łączna wiarygodność, JML).
#    Osoby z wynikiem 0 lub 5 nie wnoszą informacji o zadaniach, więc je pomijamy.
srodek <- rowSums(X) > 0 & rowSums(X) < 5
dl <- data.frame(osoba = factor(rep(which(srodek), 5)), zadanie = factor(rep(colnames(X), each = sum(srodek))),
                 y = c(X[srodek, ]))
m_jml <- glm(y ~ 0 + osoba + zadanie, family = binomial, data = dl)
b <- c(Z1 = 0, coef(m_jml)[paste0("zadanie", colnames(X)[-1])])
trudnosc_jml <- setNames(-(b - mean(b)), colnames(X))
round(rbind(CML = trudnosc_cml, JML = trudnosc_jml), 3)
c(osoby_w_glm = sum(srodek), parametry_glm = length(coef(m_jml)))
round(sd(trudnosc_jml) / sd(trudnosc_cml), 3)   # ile razy rozpiętość trudności z JML przekracza CML

# 5. Obiektywność specyficzna w liczbach: dla pary zadań (i, Z3) bierzemy osoby, które rozwiązały
#    dokładnie jedno z nich. Logarytm ilorazu „rozwiązało i, nie Z3” do „rozwiązało Z3, nie i” szacuje
#    różnicę trudności b(Z3) − b(i) i według modelu nie zależy od zdolności – sprawdzamy to w grupach
#    wyniku na trzech pozostałych zadaniach.
pary <- do.call(rbind, lapply(c("Z1", "Z2", "Z4", "Z5"), function(i) {
  reszta <- rowSums(X[, setdiff(colnames(X), c(i, "Z3"))])
  do.call(rbind, lapply(1:3, function(s) {
    n_i <- sum(X[, i] == 1 & X[, "Z3"] == 0 & reszta == s)
    n_3 <- sum(X[, i] == 0 & X[, "Z3"] == 1 & reszta == s)
    data.frame(zadanie = i, reszta = s, n_i = n_i, n_Z3 = n_3, log_iloraz = log(n_i / n_3),
               se = sqrt(1 / n_i + 1 / n_3), z_modelu = trudnosc_cml[["Z3"]] - trudnosc_cml[[i]])
  }))
}))
pary$dolna <- pary$log_iloraz - 1.96 * pary$se
pary$gorna <- pary$log_iloraz + 1.96 * pary$se
print(transform(pary, log_iloraz = round(log_iloraz, 2), se = round(se, 2), z_modelu = round(z_modelu, 2),
                dolna = round(dolna, 2), gorna = round(gorna, 2)), row.names = FALSE)

# 6. Test Andersena: trudności oszacowane osobno w grupie słabszej (wynik 0–3) i mocniejszej (4–5)
lr <- LRtest(m_cml, splitcr = "mean", se = TRUE)
lr
grupy <- data.frame(zadanie = colnames(X),
                    slabsi = -lr$betalist$low, se_slabsi = lr$selist$low,
                    mocniejsi = -lr$betalist$high, se_mocniejsi = lr$selist$high)
grupy[, -1] <- round(grupy[, -1], 3)
print(grupy, row.names = FALSE)

# Rysunek 2A: różnica trudności w parach zadań w trzech grupach zdolności
pA <- ggplot(pary, aes(factor(reszta), log_iloraz, colour = zadanie, shape = zadanie, group = zadanie)) +
  geom_hline(aes(yintercept = z_modelu, colour = zadanie), linetype = "dashed", linewidth = 0.6, show.legend = FALSE) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.12, position = position_dodge(width = 0.45)) +
  geom_point(size = 3, fill = "white", stroke = 1.1, position = position_dodge(width = 0.45)) +
  scale_colour_manual(values = c(Z1 = oi[["niebieski"]], Z2 = oi[["pomaranczowy"]], Z4 = oi[["zielony"]], Z5 = oi[["fiolet"]]),
                      name = "Para z Z3:") +
  scale_shape_manual(values = c(Z1 = 21, Z2 = 24, Z4 = 22, Z5 = 23), name = "Para z Z3:") +
  labs(title = "A. Porównanie zadań bez udziału zdolności",
       x = "Liczba poprawnych odpowiedzi w trzech pozostałych zadaniach",
       y = "Logarytm ilorazu: Z zamiast Z3") +
  motyw + theme(legend.position = "bottom")
# Rysunek 2B: trudności w dwóch grupach (test Andersena)
pB <- ggplot(grupy, aes(slabsi, mocniejsi)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey50", linetype = "dashed") +
  geom_errorbar(aes(ymin = mocniejsi - 1.96 * se_mocniejsi, ymax = mocniejsi + 1.96 * se_mocniejsi), width = 0.05, colour = "grey35") +
  geom_errorbar(aes(xmin = slabsi - 1.96 * se_slabsi, xmax = slabsi + 1.96 * se_slabsi), width = 0.05,
                orientation = "y", colour = "grey35") +
  geom_point(shape = 21, size = 3.2, fill = oi[["cynober"]]) +
  geom_text(aes(label = zadanie), nudge_x = -0.17, nudge_y = 0.13, size = 3.6) +
  coord_equal(xlim = c(-1.7, 1.7), ylim = c(-1.7, 1.7)) +
  labs(title = "B. Trudności w dwóch grupach",
       x = "Trudność – osoby z wynikiem 0–3 (logity)", y = "Trudność – osoby z wynikiem 4–5 (logity)") +
  motyw
p_metoda <- pA + pB + plot_layout(widths = c(1.15, 1))
p_os
p_metoda
Wynik w R
wynik
  0   1   2   3   4   5
  3  20  85 237 357 298
   Z1    Z2    Z3    Z4    Z5
0.924 0.709 0.553 0.763 0.870
   trudnosc    SE
Z1   -1.256 0.104
Z2    0.475 0.070
Z3    1.236 0.069
Z4    0.168 0.073
Z5   -0.623 0.086
        Z1    Z2    Z3    Z4     Z5
CML -1.256 0.475 1.236 0.168 -0.623
JML -1.549 0.561 1.629 0.165 -0.806
  osoby_w_glm parametry_glm
          699           703
[1] 1.27
 zadanie reszta n_i n_Z3 log_iloraz   se z_modelu dolna gorna
      Z1      1  59    4       2.69 0.52     2.49  1.68  3.70
      Z1      2 158    9       2.87 0.34     2.49  2.19  3.54
      Z1      3 173   15       2.45 0.27     2.49  1.92  2.97
      Z2      1  24    7       1.23 0.43     0.76  0.39  2.07
      Z2      2  93   47       0.68 0.18     0.76  0.33  1.03
      Z2      3 173   80       0.77 0.14     0.76  0.51  1.04
      Z4      1  25    4       1.83 0.54     1.07  0.78  2.89
      Z4      2 118   42       1.03 0.18     1.07  0.68  1.39
      Z4      3 173   61       1.04 0.15     1.07  0.75  1.33
      Z5      1  48    6       2.08 0.43     1.86  1.23  2.93
      Z5      2 153   28       1.70 0.21     1.86  1.30  2.10
      Z5      3 173   28       1.82 0.20     1.86  1.42  2.22

Andersen LR-test:
LR-value: 0.168
Chi-square df: 4
p-value:  0.997

 zadanie slabsi se_slabsi mocniejsi se_mocniejsi
      Z1 -1.267     0.120    -1.229        0.213
      Z2  0.488     0.093     0.445        0.114
      Z3  1.254     0.109     1.216        0.095
      Z4  0.159     0.092     0.174        0.124
      Z5 -0.634     0.101    -0.605        0.164
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (model Rascha – pakiet eRm; dane – pakiet ltm; regresja logistyczna – funkcja glm() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- eRm (wersja 1.0.10): Mair, P., & Hatzinger, R. (2007). Extended Rasch modeling: The eRm package for the application of IRT models in R. Journal of Statistical Software, 20(9). https://doi.org/10.18637/jss.v020.i09
- ltm (wersja 1.2.0): Rizopoulos, D. (2006). ltm: An R package for latent variable modeling and item response theory analyses. Journal of Statistical Software, 17(5), 1–25. https://doi.org/10.18637/jss.v017.i05
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Georg Rasch?
Duńskim matematykiem i statystykiem (1901–1980). Po doktoracie z matematyki (1930) pracował jako konsultant statystyczny, w połowie lat 30. u R. A. Fishera w Londynie, potem kierował działem biostatystyki Państwowego Instytutu Surowic, a w latach 1962–1972 był profesorem statystyki Uniwersytetu Kopenhaskiego.
Skąd Rasch wziął pomysł swojego modelu?
Z analizy prawdziwych danych: powtarzanych testów głośnego czytania, które opisał modelem Poissona z osobnym parametrem dla ucznia i dla tekstu, oraz testów inteligencji dla duńskiego wojska. Model dla odpowiedzi 0/1 przedstawił w książce z 1960 r.
Co to jest obiektywność specyficzna?
Tak Rasch nazwał własność swojego modelu: porównanie dwóch zadań nie zależy od tego, które osoby je rozwiązywały, a porównanie dwóch osób – od tego, jakie zadania dostały. Wynika to z tego, że wynik surowy jest statystyką dostateczną i po warunkowaniu na nim parametry osób znikają.
Dlaczego model Rascha szacuje się warunkowo?
Bo dopasowanie z osobnym parametrem dla każdej osoby (np. regresją logistyczną z efektami osób) przy kilku zadaniach daje obciążone trudności – w danych LSAT o 27% zbyt rozciągnięte. Warunkowa metoda największej wiarygodności usuwa parametry osób i daje estymatory zgodne.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Model Rascha krok po kroku
Trudności w eRm, mapa Wrighta, Q3, infit i outfit z bootstrapem, rzetelność separacji, DIF i test Andersena, RSM a PCM – na jednym teście wiedzy w R.
Czytaj →PoradnikTeoria reagowania na pozycje testowe (IRT)
Czym jest item response theory: modele Rascha, 2PL, 3PL i GRM, informacja testu, rzetelność warunkowa oraz IRT a klasyczna teoria testów i CFA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Andersen, E. B. (1970). Asymptotic properties of conditional maximum-likelihood estimators. Journal of the Royal Statistical Society: Series B (Methodological), 32(2), 283–301. https://doi.org/10.1111/j.2517-6161.1970.tb00842.x
- Andersen, E. B. (1973). A goodness of fit test for the Rasch model. Psychometrika, 38(1), 123–140. https://doi.org/10.1007/bf02291180
- Andersen, E. B. (1982). Georg Rasch (1901–1980). Psychometrika, 47(4), 375–376. https://doi.org/10.1007/bf02293703
- Rasch, G. (1980). Probabilistic models for some intelligence and attainment tests (Expanded ed.). University of Chicago Press.
- Wright, B. D. (1980). Foreword. In G. Rasch, Probabilistic models for some intelligence and attainment tests (Expanded ed.). University of Chicago Press. https://www.rasch.org/memo63.htm ● Otwarty dostęp
Cytowania BibTeX
@article{andersen1970asymptotic, author={Andersen, Erling B.}, title={{Asymptotic properties of conditional maximum-likelihood estimators}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1970}, volume={32}, number={2}, pages={283--301}, doi={10.1111/j.2517-6161.1970.tb00842.x}}@article{andersen1973goodness, author={Andersen, Erling B.}, title={{A goodness of fit test for the Rasch model}}, journal={Psychometrika}, year={1973}, volume={38}, number={1}, pages={123--140}, doi={10.1007/bf02291180}}@article{andersen1982georg, author={Andersen, Erling B.}, title={{Georg Rasch (1901–1980)}}, journal={Psychometrika}, year={1982}, volume={47}, number={4}, pages={375--376}, doi={10.1007/bf02293703}}@book{rasch1980probabilistic, author={Rasch, Georg}, title={{Probabilistic models for some intelligence and attainment tests}}, year={1980}, edition={Expanded ed.}, publisher={University of Chicago Press}}@incollection{wright1980foreword, author={Wright, Benjamin D.}, title={{Foreword}}, booktitle={G. Rasch, Probabilistic models for some intelligence and attainment tests}, year={1980}, edition={Expanded ed.}, publisher={University of Chicago Press}, url={https://www.rasch.org/memo63.htm}}