Co to jest linia najlepszego dopasowania?
Linia najlepszego dopasowania (linia regresji, prosta regresji, ang. line of best fit, regression line) to prosta poprowadzona przez chmurę punktów na wykresie rozrzutu tak, by jak najlepiej przewidywała wartości zmiennej Y na podstawie zmiennej X. „Najlepiej” ma tu ścisłe znaczenie. W standardowym ujęciu chodzi o prostą, dla której suma kwadratów pionowych odległości punktów od linii jest najmniejsza. To kryterium metody najmniejszych kwadratów (MNK), a odległości te to reszty.
Linia najlepszego dopasowania jest graficzną postacią regresji prostej. W psychologii pojawia się na wykresach rozrzutu w rozdziałach wyników, w opisach związków (np. czasu nauki z wynikiem testu) i w programach, które dodają ją jednym kliknięciem jako „linię trendu”. Metodę najmniejszych kwadratów opublikował Legendre na początku XIX wieku. Stigler (1981) analizuje spór o pierwszeństwo z Gaussem i argumentuje, choć nie rozstrzygająco, że Gauss znał metodę wcześniej.
Wzór: nachylenie i wyraz wolny
Nachylenie b mówi, o ile średnio zmienia się przewidywane Y, gdy X rośnie o jedną jednostkę. Wyraz wolny a to przewidywane Y przy X = 0. Ma sens tylko wtedy, gdy zero leży w zakresie danych. Z wzorów wynikają trzy własności, które przydają się przy czytaniu wykresów:
- Linia przechodzi przez punkt średnich (Mx, My).
- Reszty sumują się do zera – punkty nad linią i pod nią się równoważą.
- Nachylenie ma znak korelacji Pearsona, a dla zmiennych standaryzowanych jest jej równe. Linia jest płaska (b = 0) wtedy i tylko wtedy, gdy r = 0.
Bewick i in. (2003) omawiają obliczanie i interpretację współczynnika korelacji i równania regresji, testy i przedziały ufności dla parametrów oraz częste nadużycia tych technik. Najważniejsze z nadużyć opisujemy w części o błędach.
Przykład: czas nauki a wynik kolokwium
Trzydziestu studentów (dane symulowane) podało, ile godzin uczyło się do kolokwium ze statystyki (M = 10.01, SD = 4.66). Zanotowano też ich wyniki w punktach 0–50 (M = 32.47, SD = 7.28). Korelacja wyniosła r = .58. Krok po kroku:
- Nachylenie: b = .578 × 7.281 / 4.655 = 0.90 punktu na każdą godzinę nauki.
- Wyraz wolny: a = 32.467 − 0.905 × 10.013 = 23.41.
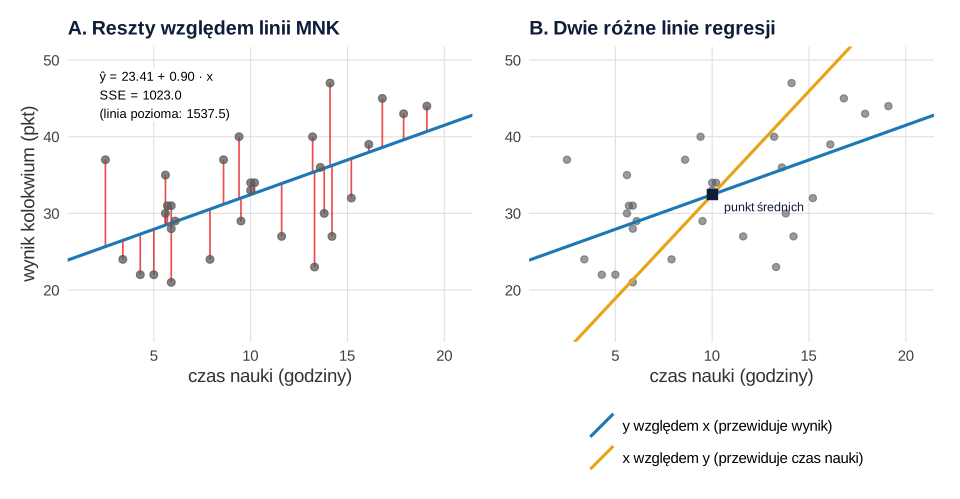
- Równanie linii: ŷ = 23.41 + 0.90 · x. Student, który uczył się 12 godzin, ma przewidywany wynik 23.41 + 0.905 × 12 ≈ 34.3 punktu.
Funkcja lm() daje te same liczby oraz 95% CI dla nachylenia [0.41, 1.40]. Linia wyjaśnia R² = .335 wariancji wyników (zob. współczynnik determinacji). Typowy błąd przewidywania wynosi około 6.04 punktu.
Dlaczego ta linia jest „najlepsza”? Suma kwadratów reszt (SSE) wynosi dla niej 1023.0. Każda inna prosta daje więcej. Przy nachyleniu większym o 20% SSE rośnie do 1043.5. Pozioma linia na poziomie średniej, czyli przewidywanie bez X, daje 1537.5. Prosta poprowadzona „na oko” przez punkty skrajne (najkrótszy i najdłuższy czas nauki) daje aż 2949.1. Stosunek 1023.0 do 1537.5 to dokładnie 1 − R²: linia zmniejsza błąd przewidywania o 33.5% w porównaniu z samą średnią.
Dlaczego są dwie linie, a nie jedna
MNK minimalizuje odległości pionowe, bo celem jest przewidywanie Y. Jeśli zamienisz role zmiennych i będziesz przewidywać czas nauki z wyniku, minimalizujesz odległości poziome i dostajesz inną prostą. W przykładzie nachylenie linii y względem x wynosi 0.90. Linia x względem y, narysowana w tym samym układzie, ma nachylenie 2.70 (rysunek 1B). Obie linie pokrywają się tylko przy r = ±1. Im słabsza korelacja, tym bardziej się rozchodzą. Jest to bezpośredni ślad regresji do średniej: przewidywania z każdej strony są „ściągane” ku średniej drugiej zmiennej.
Wniosek praktyczny: wybierz zmienną objaśnianą zgodnie z pytaniem, a nie z wygody rysowania. Jeśli obie zmienne traktujesz symetrycznie i chcesz tylko opisać związek, wystarczy korelacja z wykresem rozrzutu.
Wrażliwość na obserwacje nietypowe
Kwadrat odległości sprawia, że punkty daleko od linii ważą bardzo dużo. Gdy do danych z przykładu dopiszemy jedną osobę, która uczyła się 20 godzin i dostała 8 punktów, nachylenie spada z 0.90 do 0.46, a korelacja z .58 do .27. Jedna obserwacja z 31 zmieniła więc wniosek o sile związku o połowę. Yu i Yao (2017) podkreślają, że estymatory najmniejszych kwadratów są bardzo wrażliwe na nietypowe wartości predyktorów i odstające wartości zmiennej zależnej. Porównują też odporne metody regresji, które ograniczają wpływ takich punktów. Zanim zaufasz linii, sprawdź obserwacje odstające i ich wpływ (odległość Cooka). Praktyczne kroki opisuje poradnik jak wykryć wartości odstające.
Linia prosta jest też najlepsza tylko wśród prostych. Jeśli związek jest zakrzywiony, np. wynik rośnie z czasem nauki coraz wolniej, prosta systematycznie myli się w określonych zakresach X. Widać to na wykresie reszt. Wtedy dopasuj krzywą (regresja krzywoliniowa).
Jak opisać linię w pracy (APA)
Schober i Vetter (2021) pokazują na przykładzie, że interpretacja regresji liniowej opiera się na współczynniku nachylenia, jego 95% przedziale ufności i R². Tak też ją opisz, a wykres rozrzutu z linią dodaj jako rysunek.
Gdy predyktorów jest więcej, linia staje się płaszczyzną, a opis – tabelą współczynników (zob. regresja wieloraka i regresja wieloraka krok po kroku).
Linia najlepszego dopasowania w R
Kod liczy nachylenie i wyraz wolny ze wzorów i w lm(), porównuje sumy kwadratów reszt dla kilku linii, pokazuje różnicę między regresją y na x i x na y oraz wpływ jednej nietypowej obserwacji.
Wzory, lm(), SSE i obserwacja nietypowa
R
# Dane symulowane: 30 studentów, czas nauki do kolokwium (godziny) i wynik kolokwium (0–50 pkt)
set.seed(202)
n <- 30
nauka <- round(runif(n, 2, 20), 1)
wynik <- round(pmin(pmax(18 + 1.2 * nauka + rnorm(n, sd = 6), 0), 50))
dane <- data.frame(nauka, wynik)

# 1. Linia najlepszego dopasowania „ręcznie”: b = r · SDy / SDx, a = średnia y − b · średnia x
r <- cor(nauka, wynik)
b <- r * sd(wynik) / sd(nauka)
a <- mean(wynik) - b * mean(nauka)
round(c(sr_x = mean(nauka), sr_y = mean(wynik), SD_x = sd(nauka), SD_y = sd(wynik), r = r, b = b, a = a), 3)

cor.test(nauka, wynik)                          # r z testem istotności

# 2. To samo w lm()
m <- lm(wynik ~ nauka, data = dane)
round(coef(m), 3)
round(c(R2 = summary(m)$r.squared, sigma = summary(m)$sigma), 3)
round(confint(m), 3)

# 3. Suma kwadratów reszt (SSE): linia MNK ma najmniejszą możliwą
sse <- function(a, b) sum((wynik - (a + b * nauka))^2)
round(c(SSE_MNK = sse(a, b),
        SSE_nachylenie_plus_20proc = sse(mean(wynik) - 1.2 * b * mean(nauka), 1.2 * b),
        SSE_przez_skrajne_punkty = {
          i <- which.min(nauka); j <- which.max(nauka)
          bb <- (wynik[j] - wynik[i]) / (nauka[j] - nauka[i]); sse(wynik[i] - bb * nauka[i], bb) },
        SSE_pozioma_na_sredniej = sse(mean(wynik), 0)), 1)
round(sum(resid(m)), 10)                         # reszty sumują się do zera

# 4. Regresja x na y daje inną linię (w układzie y względem x nachylenie = 1 / b_xy)
b_xy <- coef(lm(nauka ~ wynik, data = dane))[2]
round(c(b_y_na_x = b, nachylenie_linii_x_na_y = unname(1 / b_xy), r2 = r^2), 3)

# 5. Wpływ jednej nietypowej obserwacji: 20 godzin nauki i 8 punktów
dane2 <- rbind(dane, data.frame(nauka = 20, wynik = 8))
round(coef(lm(wynik ~ nauka, data = dane2)), 3)
round(cor(dane2$nauka, dane2$wynik), 3)
Wynik w R
  sr_x   sr_y   SD_x   SD_y      r      b      a
10.013 32.467  4.655  7.281  0.578  0.905 23.406

	Pearson's product-moment correlation

data:  nauka and wynik
t = 3.7527, df = 28, p-value = 0.0008122
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.2756658 0.7768497
sample estimates:
      cor
0.5784836

(Intercept)       nauka
     23.406       0.905
   R2 sigma
0.335 6.044
             2.5 % 97.5 %
(Intercept) 17.968 28.844
nauka        0.411  1.399
                   SSE_MNK SSE_nachylenie_plus_20proc
                    1023.0                     1043.5
  SSE_przez_skrajne_punkty    SSE_pozioma_na_sredniej
                    2949.1                     1537.5
[1] 0
               b_y_na_x nachylenie_linii_x_na_y                      r2
                  0.905                   2.704                   0.335
(Intercept)       nauka
     26.942       0.458
[1] 0.268
Bibliografia oprogramowania
Wyniki pochodzą z R 4.5.3 (funkcje bazowe); rysunek przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Rysowanie linii bez sprawdzenia, czy związek jest liniowy. Linia trendu w arkuszu pojawi się zawsze, nawet dla związku w kształcie litery U.
- Przewidywanie poza zakresem danych. Równanie z przykładu nic nie mówi o osobach, które uczyły się 40 godzin; ekstrapolacja zakłada, że linia „ciągnie się” dalej, czego dane nie pokazują.
- Interpretowanie wyrazu wolnego, gdy X = 0 nie ma sensu (np. wiek 0 lat w badaniu dorosłych). Wtedy wyśrodkuj predyktor albo nie komentuj stałej.
- Odwracanie równania. Z równania wyniku na czas nauki nie wyliczysz „potrzebnego czasu nauki” dla danego wyniku – do tego służy osobna regresja x na y.
- Utożsamianie nachylenia z siłą związku. Nachylenie zależy od jednostek; o sile mówi r albo R². Duże b przy dużym rozrzucie punktów może oznaczać słaby związek.
- Wniosek przyczynowy z linii na danych korelacyjnych. Linia opisuje współzmienność; o przyczynach decyduje plan badania (zob. korelacja pozorna).
Najczęstsze pytania
Jak obliczyć linię najlepszego dopasowania?
Policz nachylenie b = r · SDy / SDx i wyraz wolny a = My − b · Mx. W przykładzie na tej stronie b = .578 × 7.281 / 4.655 = 0.90 i a = 23.41, więc linia ma postać ŷ = 23.41 + 0.90 · x. W R to samo daje lm(y ~ x).
Dlaczego linia regresji minimalizuje kwadraty reszt, a nie same reszty?
Zwykłe reszty sumują się do zera dla każdej linii przechodzącej przez punkt średnich, więc nie odróżniają linii dobrej od złej. Kwadraty są zawsze dodatnie i mocniej karzą duże błędy, a rozwiązanie ma prosty wzór. Ceną jest wrażliwość na obserwacje odstające.
Czy linia regresji y na x jest tą samą linią co x na y?
Nie. Regresja y na x minimalizuje odległości pionowe, a regresja x na y – poziome, więc przy |r| < 1 dają różne proste, które przecinają się w punkcie średnich. W przykładzie nachylenia (w tym samym układzie osi) wynoszą 0.90 i 2.70.
Co oznacza nachylenie linii trendu na wykresie rozrzutu?
Nachylenie to przeciętna zmiana przewidywanej wartości Y przy wzroście X o jedną jednostkę – np. 0.90 punktu więcej na kolokwium na każdą godzinę nauki. Zależy od jednostek pomiaru, więc o sile związku mówi raczej r lub R².
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikWartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bewick, V., Cheek, L., & Ball, J. (2003). Statistics review 7: Correlation and regression. Critical Care, 7(6), 451–459. https://doi.org/10.1186/cc2401 ● Otwarty dostęp
- Schober, P., & Vetter, T. R. (2021). Linear regression in medical research. Anesthesia & Analgesia, 132(1), 108–109. https://doi.org/10.1213/ANE.0000000000005206 ● Otwarty dostęp
- Stigler, S. M. (1981). Gauss and the invention of least squares. The Annals of Statistics, 9(3), 465–474. https://doi.org/10.1214/aos/1176345451 ● Otwarty dostęp
- Yu, C., & Yao, W. (2017). Robust linear regression: A review and comparison. Communications in Statistics – Simulation and Computation, 46(8), 6261–6282. https://doi.org/10.1080/03610918.2016.1202271 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bewick2003statistics, author={Bewick, Viv and Cheek, Liz and Ball, Jonathan}, title={{Statistics review 7: Correlation and regression}}, journal={Critical Care}, year={2003}, volume={7}, number={6}, pages={451--459}, doi={10.1186/cc2401}}@article{schober2021linear, author={Schober, Patrick and Vetter, Thomas R.}, title={{Linear regression in medical research}}, journal={Anesthesia \& Analgesia}, year={2021}, volume={132}, number={1}, pages={108--109}, doi={10.1213/ane.0000000000005206}}@article{stigler1981gauss, author={Stigler, Stephen M.}, title={{Gauss and the invention of least squares}}, journal={The Annals of Statistics}, year={1981}, volume={9}, number={3}, pages={465--474}, doi={10.1214/aos/1176345451}}@article{yu2017robust, author={Yu, Chun and Yao, Weixin}, title={{Robust linear regression: A review and comparison}}, journal={Communications in Statistics – Simulation and Computation}, year={2017}, volume={46}, number={8}, pages={6261--6282}, doi={10.1080/03610918.2016.1202271}}