Kim jest Frank E. Harrell Jr.?
Frank E. Harrell Jr. jest biostatystykiem związanym z medycyną kliniczną. Jest absolwentem University of Alabama at Birmingham – w 2005 r. tamtejszy wydział nauk przyrodniczych i matematyki przyznał mu nagrodę dla wybitnego absolwenta. W 1979 r. obronił doktorat z biostatystyki na University of North Carolina pod kierunkiem P. K. Sena (Harrell, b.d.).
Przez 17 lat pracował na Duke University – w pionach biometrii i kardiologii oraz w Duke Clinical Research Institute. Prowadził tam kurs „Regression Modeling Strategies” w magisterskim programie biometrii. W 1996 r. założył pion biostatystyki i epidemiologii na University of Virginia. W 2003 r. został pierwszym kierownikiem nowej Katedry Biostatystyki Vanderbilt University School of Medicine i kierował nią do 1 września 2017 r. Przez dziewięć lat kierował ośrodkiem statystycznym badania SUPPORT o opiece u schyłku życia. Od lat doradza amerykańskiej Agencji Żywności i Leków (FDA). Ma ponad 350 recenzowanych publikacji (Harrell, b.d.). Piszemy tylko o jego pracy zawodowej.
Najważniejsze pomysły
- Indeks C (1982). W „JAMA” Harrell, Califf, Pryor, Lee i Rosati (1982) przedstawili metodę oceny, ile informacji o rokowaniu pacjenta wnosi badanie diagnostyczne. Jej sercem jest odsetek par zgodnych: wśród par porównywalnych sprawdzamy, czy osoba z gorszym wynikiem modelu doznała zdarzenia wcześniej. Przy danych binarnych C równa się polu pod krzywą ROC, a przy czasie przeżycia uwzględnia cenzurowanie.
- Modele prognostyczne (1996). W „Statistics in Medicine” Harrell, Lee i Mark (1996) opisali, jak budować modele wielu zmiennych bez przeuczenia. Trafność modelu trzeba oceniać miarą dyskryminacji i kalibracją, a obie walidować bootstrapem albo walidacją krzyżową, zanim użyje się przewidywań w nowych danych. To jeden z dwóch jego artykułów zaliczanych do najczęściej cytowanych w historii tego czasopisma (Harrell, b.d.).
- Strategie modelowania regresyjnego. Podręcznik Regression Modeling Strategies (2001, wyd. 2 – 2015) obejmuje regresję liniową, logistyczną, porządkową i modele przeżycia (Harrell, 2015). W badaniach Harrell pokazywał zalety splajnów zamiast założenia liniowości i rozszerzył bootstrapową ocenę „optymizmu” Efrona na walidację modeli przeżycia (Harrell, b.d.).
- Oprogramowanie. Jest autorem pakietów R Hmisc (narzędzia do analizy danych, tabel i imputacji) oraz rms, który zbiera funkcje do budowy, walidacji i prezentacji modeli regresji (Harrell, b.d.).
- Wyróżnienia. Fellow American Statistical Association (2005) i Nagroda im. W. J. Dixona ASA za doradztwo statystyczne (2014) (Harrell, b.d.).
Ciekawostka
Indeks C narodził się w pracy, która podważała wartość jednego z badań kardiologicznych. Harrell i współautorzy (1982) sprawdzali na pacjentach z podejrzeniem choroby wieńcowej, ile dodaje do rokowania próba wysiłkowa na bieżni. Podkreślali, że nowy test trzeba oceniać na tle informacji, które lekarz już ma: z wywiadu, badania fizykalnego i rutynowych badań.
Wynik? Według streszczenia artykułu test wysiłkowy dawał zaskakująco mało informacji o rokowaniu ponad to, co wynikało z podstawowych pomiarów klinicznych (Harrell i in., 1982). Miarę z tej pracy znamy dziś jako indeks C Harrella.
Przykład na prawdziwych danych
Zbiór pbc z pakietu survival to – według pliku pomocy – dane z Mayo Clinic o 418 chorych na pierwotne zapalenie dróg żółciowych (lata 1974–1984). 312 z nich uczestniczyło w randomizowanej próbie D-penicylaminy. Zdarzeniem jest zgon (161 osób); przeszczep wątroby traktujemy jak cenzurowanie. Predyktorem jest stężenie bilirubiny w surowicy, którego mediana wynosi 1.4 mg/dl.
Indeks C ręcznie. Par porównywalnych jest 43 684. Gdy bilirubina jest zmienną ciągłą, 33 886 par jest zgodnych, a 638 ma remis w wyniku, więc C = 0.783. Ten sam wynik daje funkcja concordance().
Po podziale medianą. Gdy bilirubinę zamienimy na „wysoka/niska”, zgodnych par jest już tylko 20 780, a 19 636 (45%) to remisy – osoby z tej samej grupy są dla modelu nie do odróżnienia. C spada do 0.700. Nawet najlepszy z badanych progów (65. percentyl) daje C = 0.721, czyli mniej niż zmienna ciągła. W pięcioletnim ryzyku zgonu podział daje dwie liczby: 9.4% i 53.2%. W dziesięciu grupach bilirubiny ryzyko rośnie od 3.0% do 79.0%.
Na rysunku
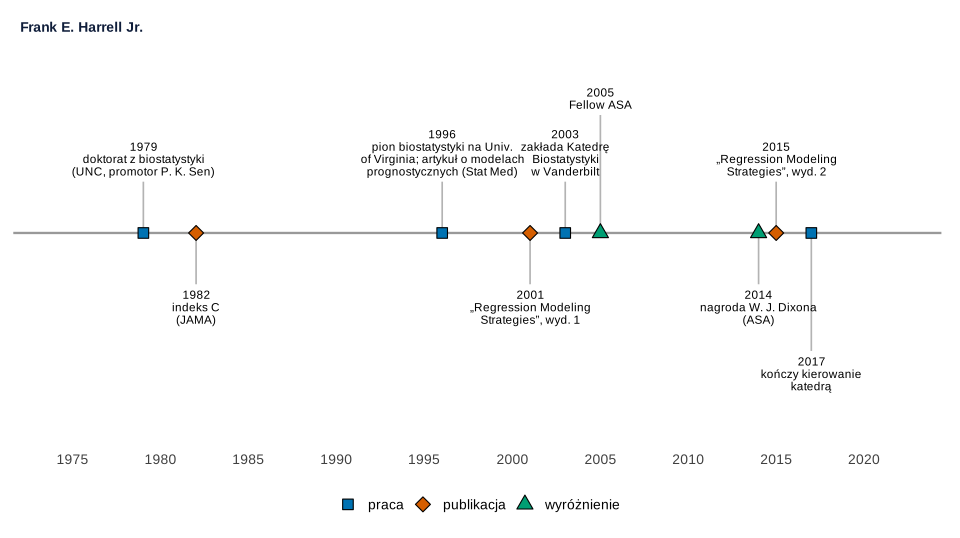
Co widać. Od indeksu C (1982) do drugiego wydania podręcznika (2015) minęły 33 lata.
Na co uważać. Na osi nie ma roku urodzenia ani początku pracy na Duke – cytowane źródła ich nie podają.
Podpis do pracy:
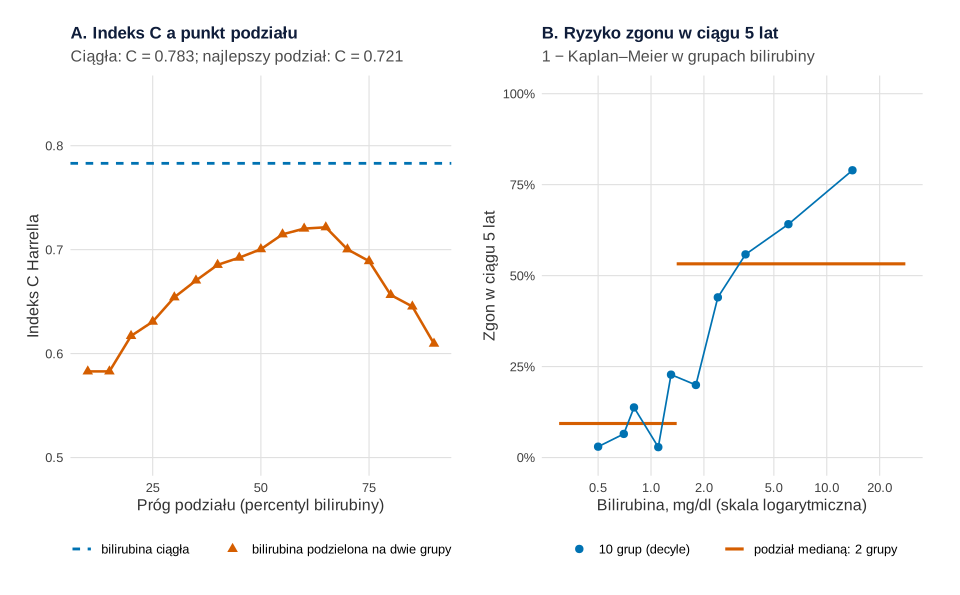
survival::pbc, N = 418): indeks C po podziale na dwie grupy w różnych progach na tle zmiennej ciągłej (A) oraz pięcioletnie ryzyko zgonu (1 − Kaplan–Meier) w dziesięciu grupach i w dwóch grupach po podziale medianą (B). Obliczenia i rysunek: R, pakiety survival, ggplot2 i patchwork.Co widać. W panelu A żaden próg nie dorównuje zmiennej ciągłej. W panelu B każdy z dwóch odcinków uśrednia osoby o bardzo różnym ryzyku: w grupie „wysokiej” są chorzy z ryzykiem około 20% i około 80%.
Na co uważać. Najlepszy próg wybrany na tych samych danych jest optymistyczny – w nowej próbie wypadłby gorzej. Indeks C mierzy tylko kolejność, nie to, czy przewidywane ryzyko ma właściwą wielkość.
Podpis do pracy:
Gdzie spotkasz Harrella w swojej pracy
- Gdy budujesz model predykcyjny, raportuj indeks C i kalibrację po walidacji bootstrapowej, a liczbę predyktorów dopasuj do liczby zdarzeń (EPV; krok po kroku: modele predykcyjne: walidacja i kalibracja).
- Nie dziel zmiennych ciągłych na grupy tylko dla wygody – zamiast tego użyj zmiennej ciągłej, a nieliniowość opisz splajnami (dychotomizacja zmiennych ciągłych).
- W R pakiety Hmisc i rms pozwalają opisać dane, dopasować model ze splajnami i zwalidować go bootstrapem.
Spory, mity i trudne strony
- „Dychotomania”. W wywiadzie z 2017 r. Harrell nazwał dzielenie zmiennych ciągłych na kategorie „one of the greatest crimes against data” – jednym z największych przestępstw wobec danych. Wyjaśniał, że podział traci informację, jest arbitralny i zakłada skoki, których w przyrodzie się nie spotyka (Gray, 2017).
- Inne nawyki pod ostrzałem. W tym samym wywiadzie krytykował regresję krokową, niewłaściwe miary trafności i klasyfikowanie zamiast przewidywania ryzyka przy słabym sygnale (Gray, 2017). To jego stanowisko z wywiadu, nie wynik badania.
- Mit: „wysokie C znaczy dobry model”. C ocenia tylko kolejność. Model może dobrze porządkować pacjentów, a mimo to zawyżać ich ryzyko, dlatego Harrell i współautorzy (1996) każą oceniać także kalibrację.
Indeks C i dychotomizacja w R
Kod wczytuje dane pbc, liczy indeks C Harrella ręcznie z par porównywalnych dla bilirubiny ciągłej i podzielonej medianą, sprawdza wynik funkcją concordance(), liczy C dla progów od 10. do 90. percentyla i pięcioletnie ryzyko zgonu w grupach bilirubiny, a potem rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje niczego.
1. Indeks C ręcznie i skutki podziału: rysunek 2
Kod R rysunku 2
# Frank Harrell: indeks C policzony ręcznie z par i strata informacji po dychotomizacji predyktora (survival::pbc)
suppressPackageStartupMessages({library(survival); library(ggplot2); library(patchwork)})
kol <- c(ciagla = "#0072B2", podzial = "#D55E00", grupy = "#009E73", punkty = "#000000")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(pbc, package = "survival")
# pbc: pierwotne zapalenie dróg żółciowych, Mayo Clinic 1974–1984; time – dni do zgonu, przeszczepu lub końca obserwacji;
# status: 0 = żyje, 1 = przeszczep wątroby, 2 = zgon. Zdarzeniem jest zgon; przeszczep traktujemy jak cenzurowanie.
d <- data.frame(dni = pbc$time, zgon = as.integer(pbc$status == 2), bili = pbc$bili)
c(N = nrow(d), zgony = sum(d$zgon), mediana_bilirubiny = median(d$bili))

# 1. Indeks C ręcznie: para jest porównywalna, gdy osoba i zmarła wcześniej, niż j przestała być obserwowana;
#    zgodna, gdy osoba i (krótszy czas przeżycia) ma wyższy wynik; remis w wyniku liczy się jako 1/2
indeks_c <- function(czas, zdarzenie, wynik) {
  porown <- outer(czas, czas, "<") | (outer(czas, czas, "==") & outer(rep(TRUE, length(czas)), zdarzenie == 0))
  porown <- porown & (zdarzenie == 1)                    # wiersz i: osoba ze zdarzeniem i krótszym czasem
  zgodne <- outer(wynik, wynik, ">"); remisy <- outer(wynik, wynik, "==")
  c(pary = sum(porown), zgodne = sum(porown & zgodne), remisy = sum(porown & remisy),
    C = (sum(porown & zgodne) + 0.5 * sum(porown & remisy)) / sum(porown))
}
d$bili_wysoka <- as.integer(d$bili > median(d$bili))   # podział medianą: wysoka vs niska bilirubina
wyn <- rbind(ciagla = indeks_c(d$dni, d$zgon, d$bili), mediana = indeks_c(d$dni, d$zgon, d$bili_wysoka))
round(wyn, 3)

# 2. Kontrola: funkcja concordance() z pakietu survival (reverse = TRUE: wyższy wynik = krótsze przeżycie)
round(c(ciagla = concordance(Surv(dni, zgon) ~ bili, data = d, reverse = TRUE)$concordance,
        mediana = concordance(Surv(dni, zgon) ~ bili_wysoka, data = d, reverse = TRUE)$concordance), 3)

# 3. Indeks C po podziale w różnych punktach (od 10. do 90. percentyla)
progi <- quantile(d$bili, seq(0.1, 0.9, by = 0.05), type = 1)
c_progi <- data.frame(percentyl = seq(10, 90, by = 5), prog = unname(progi),
                      C = sapply(progi, function(p) indeks_c(d$dni, d$zgon, as.integer(d$bili > p))[["C"]]))
round(c(najlepszy_C_po_podziale = max(c_progi$C), przy_percentylu = c_progi$percentyl[which.max(c_progi$C)]), 3)

# 4. Ryzyko zgonu w 5 lat (1 − Kaplan–Meier, 1826 dni) w dziesięciu grupach bilirubiny i w dwóch grupach po podziale
d$decyl <- cut(d$bili, quantile(d$bili, 0:10 / 10), include.lowest = TRUE, labels = FALSE)
ryzyko5 <- function(x) 1 - summary(survfit(Surv(dni, zgon) ~ 1, data = x), times = 1826)$surv
dec <- do.call(rbind, lapply(split(d, d$decyl), function(x)
  data.frame(n = nrow(x), bili_mediana = median(x$bili), ryzyko = ryzyko5(x))))
dwie <- sapply(split(d, d$bili_wysoka), ryzyko5)
round(dec, 3)
round(c(ryzyko_niska = dwie[[1]], ryzyko_wysoka = dwie[[2]]), 3)

# Rysunek: A – indeks C po podziale w różnych progach vs zmienna ciągła; B – ryzyko w decylach vs dwie grupy
pA <- ggplot(c_progi, aes(percentyl, C)) +
  geom_hline(aes(yintercept = wyn["ciagla", "C"], linetype = "bilirubina ciągła"), colour = kol[["ciagla"]], linewidth = 1) +
  geom_line(colour = kol[["podzial"]], linewidth = 0.9) +
  geom_point(aes(shape = "bilirubina podzielona na dwie grupy"), colour = kol[["podzial"]], size = 2.4) +
  scale_linetype_manual(values = "22", name = NULL) + scale_shape_manual(values = 17, name = NULL) +
  coord_cartesian(ylim = c(0.5, 0.85)) +
  labs(title = "A. Indeks C a punkt podziału",
       subtitle = sprintf("Ciągła: C = %.3f; najlepszy podział: C = %.3f", wyn["ciagla", "C"], max(c_progi$C)),
       x = "Próg podziału (percentyl bilirubiny)", y = "Indeks C Harrella") +
  motyw + guides(linetype = guide_legend(ncol = 1, order = 1), shape = guide_legend(ncol = 1, order = 2))
dwie_df <- data.frame(od = c(min(d$bili), median(d$bili)), do = c(median(d$bili), max(d$bili)), ryzyko = unname(dwie))
pB <- ggplot(dec, aes(bili_mediana, ryzyko)) +
  geom_segment(data = dwie_df, aes(x = od, xend = do, y = ryzyko, yend = ryzyko, linetype = "podział medianą: 2 grupy"),
               colour = kol[["podzial"]], linewidth = 1.1) +
  geom_line(colour = kol[["ciagla"]], linewidth = 0.6) +
  geom_point(aes(shape = "10 grup (decyle)"), colour = kol[["ciagla"]], size = 2.6) +
  scale_x_log10(breaks = c(0.5, 1, 2, 5, 10, 20)) +
  scale_y_continuous(labels = function(x) paste0(round(100 * x), "%"), limits = c(0, 1)) +
  scale_linetype_manual(values = "solid", name = NULL) + scale_shape_manual(values = 16, name = NULL) +
  labs(title = "B. Ryzyko zgonu w ciągu 5 lat",
       subtitle = "1 − Kaplan–Meier w grupach bilirubiny",
       x = "Bilirubina, mg/dl (skala logarytmiczna)", y = "Zgon w ciągu 5 lat") +
  motyw + guides(shape = guide_legend(ncol = 1, order = 1), linetype = guide_legend(ncol = 1, order = 2))
p2 <- pA + pB
p2
Wynik w R
                 N              zgony mediana_bilirubiny
             418.0              161.0                1.4
         pary zgodne remisy     C
ciagla  43684  33886    638 0.783
mediana 43684  20780  19636 0.700
 ciagla mediana
  0.783   0.700
najlepszy_C_po_podziale         przy_percentylu
                  0.721                  65.000
    n bili_mediana ryzyko
1  67         0.50  0.030
2  33         0.70  0.065
3  42         0.80  0.138
4  35         1.10  0.029
5  41         1.30  0.228
6  38         1.80  0.199
7  40         2.40  0.440
8  40         3.45  0.558
9  40         6.05  0.641
10 42        14.00  0.790
 ryzyko_niska ryzyko_wysoka
        0.094         0.532
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Frank E. Harrell Jr. – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1979, 1982, 1996, 2001, 2003, 2005, 2014, 2015, 2017),
  opis = c("doktorat z biostatystyki\n(UNC, promotor P. K. Sen)", "indeks C\n(JAMA)", "pion biostatystyki na Univ.\nof Virginia; artykuł o modelach\nprognostycznych (Stat Med)", "„Regression Modeling\nStrategies”, wyd. 1",
           "zakłada Katedrę\nBiostatystyki\nw Vanderbilt", "Fellow ASA", "nagroda W. J. Dixona\n(ASA)",
           "„Regression Modeling\nStrategies”, wyd. 2", "kończy kierowanie\nkatedrą"),
  rodzaj = c("praca", "publikacja", "praca", "publikacja", "praca", "wyróżnienie", "wyróżnienie",
             "publikacja", "praca"),
  poziom = c(0.5, -0.5, 0.5, -0.5, 0.5, 1.15, -0.5, 0.5, -1.15),   # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = rep(0.5, 9))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
zdarzenia$osoba <- "Frank E. Harrell Jr."
ksztalty <- c("praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  facet_wrap(~ osoba, ncol = 1) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1974, 2022), breaks = seq(1975, 2020, by = 5)) +
  scale_y_continuous(limits = c(-1.9, 1.7)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        strip.text = element_text(face = "bold", hjust = 0), legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (indeks C – obliczenia własne i funkcja concordance(), Kaplan–Meier – funkcja survfit(), dane – pakiet survival; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest Frank Harrell?
Amerykańskim biostatystykiem. Doktorat z biostatystyki obronił w 1979 r. na University of North Carolina u P. K. Sena, 17 lat pracował na Duke University, w 1996 r. założył pion biostatystyki na University of Virginia, a w 2003 r. – Katedrę Biostatystyki Vanderbilt University, którą kierował do 2017 r. (Harrell, b.d.).
Skąd się wziął indeks C Harrella?
Z artykułu Harrella i współautorów w JAMA z 1982 r. o tym, ile informacji o rokowaniu wnosi badanie medyczne. Indeks C to odsetek par porównywalnych, w których osoba z gorszym wynikiem modelu doznała zdarzenia wcześniej; 0.5 oznacza zgadywanie, 1 – idealną kolejność.
Dlaczego Harrell krytykuje dzielenie zmiennych na grupy?
Bo podział traci informację, jest arbitralny i zakłada skoki ryzyka na granicy grup, których w naturze nie ma (Gray, 2017). W danych pbc indeks C dla bilirubiny spada po podziale medianą z 0.783 do 0.700.
Co to są pakiety rms i Hmisc?
Pakiety R autorstwa Harrella. Hmisc zawiera narzędzia do opisu danych, tabel, imputacji i wykresów, a rms – funkcje do budowy, testowania, walidacji i prezentacji modeli regresji opisanych w jego podręczniku Regression Modeling Strategies (Harrell, b.d.).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Dychotomizacja zmiennych ciągłych
Ile mocy kosztuje podział zależnie od punktu cięcia, dlaczego dwa podziały dają pozorne efekty i interakcje, kiedy próg kliniczny ma sens i co analizować zamiast grup – z symulacjami w R.
Czytaj →PoradnikModele predykcyjne: walidacja i kalibracja
Liczebność, przeuczenie, walidacja krzyżowa i bootstrap, LASSO i ridge, kalibracja, wynik Briera i TRIPOD+AI – na danych do pobrania, z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Gray, K. (2017). Vital statistics you never learned… because they’re never taught. KDnuggets. https://www.kdnuggets.com/2017/08/vital-statistics-never-learned-never-taught.html ● Otwarty dostęp
- Harrell, F. E., Jr. (2015). Regression modeling strategies: With applications to linear models, logistic and ordinal regression, and survival analysis (2nd ed.). Springer. https://doi.org/10.1007/978-3-319-19425-7
- Harrell, F. E., Jr. (b.d.). FEH: Frank E Harrell Jr, PhD. hbiostat.org. Pobrano 22 listopada 2026 z https://hbiostat.org/fh/ ● Otwarty dostęp
- Harrell, F. E., Jr., Califf, R. M., Pryor, D. B., Lee, K. L., & Rosati, R. A. (1982). Evaluating the yield of medical tests. JAMA, 247(18), 2543–2546. https://doi.org/10.1001/jama.1982.03320430047030
- Harrell, F. E., Lee, K. L., & Mark, D. B. (1996). Multivariable prognostic models: Issues in developing models, evaluating assumptions and adequacy, and measuring and reducing errors. Statistics in Medicine, 15(4), 361–387. https://doi.org/10.1002/(sici)1097-0258(19960229)15:4<361::aid-sim168>3.0.co;2-4
Cytowania BibTeX
@misc{gray2017vital, author={Gray, Kevin}, title={{Vital statistics you never learned… because they’re never taught}}, howpublished={KDnuggets}, year={2017}, url={https://www.kdnuggets.com/2017/08/vital-statistics-never-learned-never-taught.html}}@book{harrell2015regression, author={Harrell, Jr., Frank E.}, title={{Regression modeling strategies: With applications to linear models, logistic and ordinal regression, and survival analysis}}, year={2015}, edition={2}, publisher={Springer}, doi={10.1007/978-3-319-19425-7}}@misc{harrellbdfeh, author={Harrell, Jr., Frank E.}, title={{FEH: Frank E Harrell Jr, PhD}}, howpublished={hbiostat.org}, url={https://hbiostat.org/fh/}}@article{harrell1982evaluating, author={Harrell, Jr., Frank E. and Califf, Robert M. and Pryor, David B. and Lee, Kerry L. and Rosati, Robert A.}, title={{Evaluating the yield of medical tests}}, journal={JAMA}, year={1982}, volume={247}, number={18}, pages={2543--2546}, doi={10.1001/jama.1982.03320430047030}}@article{harrell1996multivariable, author={Harrell, Frank E. and Lee, Kerry L. and Mark, Daniel B.}, title={{Multivariable prognostic models: Issues in developing models, evaluating assumptions and adequacy, and measuring and reducing errors}}, journal={Statistics in Medicine}, year={1996}, volume={15}, number={4}, pages={361--387}, doi={10.1002/(sici)1097-0258(19960229)15:4<361::aid-sim168>3.0.co;2-4}}