Kim jest Bengt Muthén?
Bengt O. Muthén to statystyk i psychometra, profesor emeritus UCLA Graduate School of Education & Information Studies. Studiował statystykę na Uniwersytecie w Uppsali: licencjat zdobył w 1970 r., w latach 1971–1973 uczył tam statystyki, a w maju 1977 r. obronił doktorat o modelach równań strukturalnych ze zmiennymi ukrytymi mierzonymi wskaźnikami dychotomicznymi (Muthén, b.d.). Promotorem był Karl Jöreskog (Wijsen, 2023).
W latach 1974–1975 był gościem wydziałów ekonomii i socjologii University of Wisconsin w Madison. Do 1981 r. prowadził badania w Uppsali i w szwedzkich projektach, w 1980 r. uzyskał szwedzki tytuł docenta. W 1982 r. przeszedł na UCLA, gdzie w 1988 r. został profesorem, a od 2008 r. jest profesorem emeritus. W latach 1988–1989 był prezesem Psychometric Society, która w 2011 r. przyznała mu nagrodę za całokształt pracy (Muthén, b.d.; Muthén & Muthén, b.d.).
Najważniejsze pomysły
- SEM ze zmiennymi kategorialnymi. Klasyczna analiza równań strukturalnych zakładała wskaźniki ciągłe, a ankiety i testy dają odpowiedzi 0/1 albo na skali porządkowej. Już w doktoracie i w artykule z 1978 r. Muthén zajmował się analizą czynnikową zmiennych dychotomicznych. W 1984 r. w „Psychometrice” zaproponował ogólny model ze wskaźnikami dychotomicznymi, porządkowymi i ciągłymi oraz trzystopniowy estymator, który daje test chi-kwadrat dopasowania i błędy standardowe (Muthén, 1984). Dziś modele z takimi wskaźnikami szacuje się zwykle metodą WLSMV na korelacjach polichorycznych.
- Modele mieszanin. W „Biometrics” Muthén i Shedden (1999) opisali model, w którym nieobserwowane klasy trajektorii wzrostu wpływają na późniejszy wynik, np. binarny. Parametry szacuje algorytm EM. Tak opisany model mieszanin wzrostu (GMM) łączy krzywą wzrostu z analizą klas latentnych.
- Mplus. Muthén jest współtwórcą programu Mplus, w którym zaimplementowano wiele jego metod. Prace nad nim zaczęły się w 1995 r., pierwszą wersję wydano w 1998 r.; zespół tworzą Linda Muthén, Bengt Muthén, Tihomir Asparouhov i Thuy Nguyen (Muthén & Muthén, b.d.). Według wywiadu z 2023 r. Muthén poświęca się dziś w pełni rozwojowi programu (Wijsen, 2023).
Ciekawostka
Jedno z najpopularniejszych narzędzi do modeli ze zmiennymi ukrytymi wyrosło po części z badań nad alkoholem. Rozwój Mplus finansowano częściowo z grantów i kontraktów National Institute on Alcohol Abuse and Alcoholism (NIAAA) w ramach programu dla małych firm badawczych (Muthén & Muthén, b.d.). Sam Muthén w latach 1993–1999 był pracownikiem naukowym Research Institute on Addictions w Buffalo, a w latach 1996–2007 miał stypendium NIAAA dla niezależnych badaczy (Muthén, b.d.).
Ślad tego widać w samej metodzie: model mieszanin z 1999 r. Muthén i Shedden zilustrowali przewidywaniem uzależnienia od alkoholu na podstawie trzech klas trajektorii intensywnego picia (Muthén i Shedden, 1999).
Przykład na prawdziwych danych
Model mieszaniny w najprostszej postaci: jedna zmienna i dwie nieobserwowane klasy o rozkładach normalnych. Zbiór banknote z pakietu mclust zawiera – według pliku pomocy – pomiary 100 prawdziwych i 100 fałszywych starych szwajcarskich banknotów 1000-frankowych z książki Flury’ego i Riedwyla (1988). Bierzemy długość przekątnej (mm) i ukrywamy przed algorytmem, który banknot jest fałszywy. Etykiety posłużą tylko do sprawdzenia wyniku.
Algorytm EM napisany ręcznie (krok E: prawdopodobieństwa przynależności, krok M: ważone udziały, średnie i odchylenia) zbiegł się w 20 iteracjach, a wiarygodność w żadnej z nich nie zmalała. Wyszły dwie klasy: udział 0.522, średnia 139.498 mm, SD = 0.600 oraz udział 0.478, średnia 141.561 mm, SD = 0.387. Model z dwiema klasami ma znacznie mniejsze BIC niż jeden rozkład normalny (563.51 wobec 633.86). Gdy każdy banknot przypisać do klasy bardziej prawdopodobnej, klasa 1 obejmuje wszystkie 100 fałszywych i 4 prawdziwe banknoty, a klasa 2 – 96 prawdziwych; trafność wynosi 0.98, a entropia względna 0.93. Pakiet mclust z modelem o różnych wariancjach daje te same oszacowania z dokładnością do 0.001.
Na rysunku
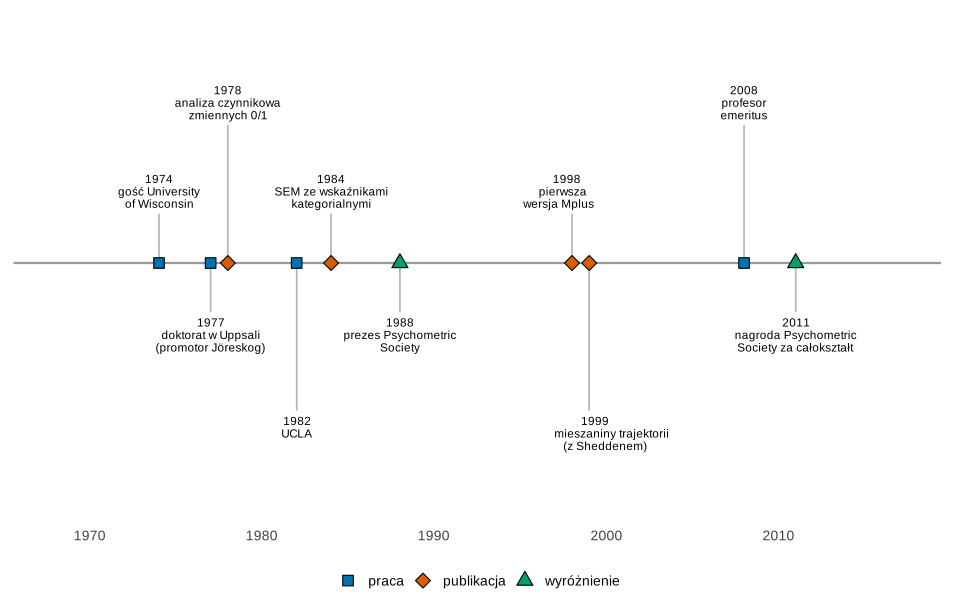
Co widać. Najpierw kilkanaście lat pracy nad zmiennymi kategorialnymi w SEM, potem – od drugiej połowy lat 90. – modele mieszanin i program Mplus.
Na co uważać. Oś pokazuje tylko wybrane zdarzenia zawodowe; Muthén żyje, więc nie podajemy roku urodzenia ani faktów spoza kariery naukowej.
Podpis do pracy:
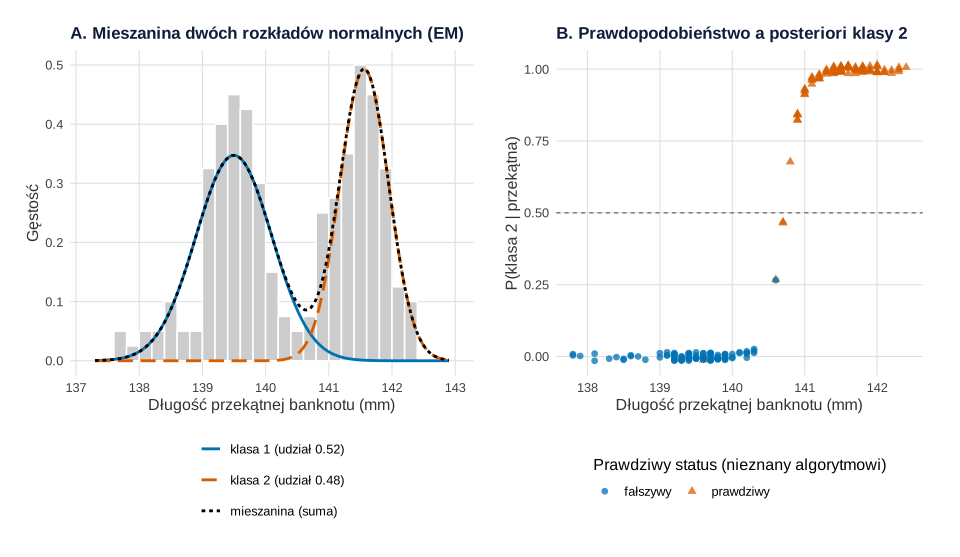
mclust::banknote): histogram z gęstością mieszaniny i jej składnikami (A) oraz prawdopodobieństwo przynależności do klasy 2 na tle prawdziwego statusu banknotu (B). Punkty w panelu B lekko rozsunięte w pionie (set.seed(1977)). Obliczenia i rysunek: R, własny algorytm EM, pakiety mclust, ggplot2 i patchwork.Co widać. W panelu A dwie krzywe składowe sumują się do gęstości, która odtwarza dwa garby histogramu; klasa 2 jest węższa (SD = 0.387 wobec 0.600). W panelu B przejście od klasy 1 do klasy 2 jest strome: tylko 5 banknotów ma prawdopodobieństwo klasy 2 między 0.2 a 0.8. Wszystkie cztery pomyłki to prawdziwe banknoty o krótszej przekątnej, które trafiły do klasy fałszywych; jeden z nich (139.6 mm) leży w samym środku rozkładu fałszywych i żaden model jednej zmiennej by go nie rozpoznał.
Na co uważać. Algorytm nie wie, czym są klasy – nazwy „fałszywe” i „prawdziwe” nadaliśmy dopiero po porównaniu z etykietami, których w zwykłym badaniu nie ma. Dwie klasy mogą też opisywać jeden skośny rozkład, a EM może utknąć w lokalnym maksimum, dlatego w praktyce uruchamia się go z wielu punktów startowych.
Podpis do pracy:
Gdzie spotkasz Muthéna w swojej pracy
- Klasy i profile latentne. Gdy szukasz w próbie podgrup osób – w analizie profili latentnych, w analizie klas latentnych (poradnik LCA krok po kroku) albo w modelu mieszanin wzrostu – używasz tej samej logiki co w przykładzie: mieszaniny rozkładów, prawdopodobieństw przynależności, BIC i entropii.
- Zmiany w czasie. Jeśli badasz trajektorie (poradnik krzywe wzrostu), model mieszanin wzrostu pozwala sprawdzić, czy wszyscy zmieniają się podobnie, czy istnieją klasy o różnych przebiegach.
- Skale Likerta w CFA i SEM. Odpowiedzi porządkowe możesz modelować jako kategorialne zamiast udawać, że są ciągłe – praktycznie pokazuje to poradnik kategorialna CFA w lavaan.
- Raportowanie. Podaj liczbę klas i kryterium wyboru (np. BIC dla 1, 2, 3… klas), udziały klas, średnie, entropię i informację, z ilu punktów startowych uruchamiano estymację.
Mieszanina rozkładów algorytmem EM w R
Kod wczytuje pomiary banknotów, dopasowuje mieszaninę dwóch rozkładów normalnych własnym algorytmem EM (bez gotowych funkcji), porównuje ją z jednym rozkładem normalnym przez BIC, sprawdza klasyfikację z ukrytymi etykietami, kontroluje wynik pakietem mclust i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. EM startuje deterministycznie (średnie z kwartyli, równe udziały); jedyne losowanie to rozsunięcie punktów na wykresie z set.seed(1977).
1. Mieszanina dwóch rozkładów normalnych: rysunek 2
Kod R rysunku 2
# Muthén: mieszanina dwóch rozkładów normalnych metodą EM liczoną ręcznie (mclust::banknote – Flury i Riedwyl, 1988)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(mclust)})
kol <- c(k1 = "#0072B2", k2 = "#D55E00", suma = "#000000", slupki = "grey80")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(banknote, package = "mclust")
# 200 starych szwajcarskich banknotów 1000-frankowych: 100 prawdziwych i 100 fałszywych;
# Diagonal – długość przekątnej (mm). Etykiety Status algorytm NIE widzi – służą tylko do sprawdzenia.
y <- banknote$Diagonal
n <- length(y)
round(c(N = n, srednia = mean(y), sd = sd(y)), 3)

# Model: f(y) = pi1 * N(mu1, s1^2) + pi2 * N(mu2, s2^2) – dwie klasy latentne o różnych średnich i wariancjach
loglik <- function(p) sum(log(p$pi[1] * dnorm(y, p$mu[1], p$s[1]) + p$pi[2] * dnorm(y, p$mu[2], p$s[2])))
p <- list(pi = c(0.5, 0.5), mu = unname(quantile(y, c(0.25, 0.75))), s = rep(sd(y), 2))   # start z kwartyli
historia <- loglik(p)
for (it in 1:500) {
  # krok E: prawdopodobieństwo a posteriori przynależności każdego banknotu do klasy 1 i 2
  g1 <- p$pi[1] * dnorm(y, p$mu[1], p$s[1]); g2 <- p$pi[2] * dnorm(y, p$mu[2], p$s[2])
  tau <- cbind(g1, g2) / (g1 + g2)
  # krok M: udziały, średnie i odchylenia standardowe ważone tymi prawdopodobieństwami
  nk <- colSums(tau)
  p$pi <- nk / n
  p$mu <- colSums(tau * y) / nk
  p$s  <- sqrt(colSums(tau * (y - rep(p$mu, each = n))^2) / nk)
  historia <- c(historia, loglik(p))
  if (abs(historia[it + 1] - historia[it]) < 1e-8) break
}
c(iteracje = it, spadki_wiarygodnosci = sum(diff(historia) < -1e-10))   # EM nigdy nie obniża wiarygodności
wyniki <- rbind(udzial = p$pi, srednia = p$mu, sd = p$s)
colnames(wyniki) <- c("klasa_1", "klasa_2")
round(wyniki, 3)

# Jedna klasa czy dwie? BIC = -2 logL + k log(n) (mniejszy lepszy)
ll1 <- sum(dnorm(y, mean(y), sqrt(mean((y - mean(y))^2)), log = TRUE))
ll2 <- loglik(p)
round(c(logL_1 = ll1, logL_2 = ll2, BIC_1 = -2 * ll1 + 2 * log(n), BIC_2 = -2 * ll2 + 5 * log(n)), 2)

# Klasyfikacja: klasa o większym prawdopodobieństwie a posteriori; entropia względna (0–1)
klasa <- ifelse(tau[, 2] > 0.5, "klasa_2", "klasa_1")
table(klasa = klasa, Status = banknote$Status)
entropia <- 1 + sum(tau * log(pmax(tau, 1e-300))) / (n * log(2))
round(c(trafnosc = mean((klasa == "klasa_2") == (banknote$Status == "genuine")), entropia = entropia,
        niepewne_0.2_0.8 = sum(tau[, 2] > 0.2 & tau[, 2] < 0.8)), 3)

# Kontrola: ten sam model w pakiecie mclust (dwie klasy, różne wariancje – model "V")
m <- Mclust(y, G = 2, modelNames = "V", verbose = FALSE)
round(rbind(udzial = m$parameters$pro, srednia = m$parameters$mean, sd = sqrt(m$parameters$variance$sigmasq)), 3)

# Rysunek: A – histogram z gęstością mieszaniny i jej składnikami; B – prawdopodobieństwo a posteriori klasy 2
siatka <- data.frame(y = seq(min(y) - 0.5, max(y) + 0.5, length.out = 400))
siatka$k1 <- p$pi[1] * dnorm(siatka$y, p$mu[1], p$s[1])
siatka$k2 <- p$pi[2] * dnorm(siatka$y, p$mu[2], p$s[2])
siatka$suma <- siatka$k1 + siatka$k2
dl <- rbind(data.frame(y = siatka$y, g = siatka$k1, krzywa = sprintf("klasa 1 (udział %.2f)", p$pi[1])),
            data.frame(y = siatka$y, g = siatka$k2, krzywa = sprintf("klasa 2 (udział %.2f)", p$pi[2])),
            data.frame(y = siatka$y, g = siatka$suma, krzywa = "mieszanina (suma)"))
dl$krzywa <- factor(dl$krzywa, levels = unique(dl$krzywa))
pA <- ggplot(data.frame(y), aes(y)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 0.2, boundary = 138, fill = kol[["slupki"]], colour = "white") +
  geom_line(data = dl, aes(y, g, colour = krzywa, linetype = krzywa), linewidth = 1) +
  scale_colour_manual(values = unname(kol[c("k1", "k2", "suma")]), name = NULL) +
  scale_linetype_manual(values = c("solid", "42", "11"), name = NULL) +
  labs(title = "A. Mieszanina dwóch rozkładów normalnych (EM)",
       x = "Długość przekątnej banknotu (mm)", y = "Gęstość") +
  motyw + guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1))
db <- data.frame(y, tau2 = tau[, 2],
                 Status = factor(banknote$Status, levels = c("counterfeit", "genuine"), labels = c("fałszywy", "prawdziwy")))
set.seed(1977)                                   # tylko do rozsunięcia punktów (jitter), nie wpływa na wyniki
pB <- ggplot(db, aes(y, tau2, shape = Status, colour = Status)) +
  geom_hline(yintercept = 0.5, colour = "grey50", linetype = "22") +
  geom_jitter(width = 0, height = 0.015, size = 2, alpha = 0.75) +
  scale_colour_manual(values = unname(kol[c("k1", "k2")]), name = "Prawdziwy status (nieznany algorytmowi)") +
  scale_shape_manual(values = c(16, 17), name = "Prawdziwy status (nieznany algorytmowi)") +
  scale_y_continuous(breaks = seq(0, 1, 0.25)) +
  labs(title = "B. Prawdopodobieństwo a posteriori klasy 2",
       x = "Długość przekątnej banknotu (mm)", y = "P(klasa 2 | przekątna)") +
  motyw + guides(colour = guide_legend(nrow = 1, title.position = "top"), shape = guide_legend(nrow = 1, title.position = "top"))
p2 <- pA + pB + plot_layout(widths = c(1.1, 1))
p2
Wynik w R
      N srednia      sd
200.000 140.483   1.152
            iteracje spadki_wiarygodnosci
                  20                    0
        klasa_1 klasa_2
udzial    0.522   0.478
srednia 139.498 141.561
sd        0.600   0.387
 logL_1  logL_2   BIC_1   BIC_2
-311.63 -268.51  633.86  563.51
         Status
klasa     counterfeit genuine
  klasa_1         100       4
  klasa_2           0      96
        trafnosc         entropia niepewne_0.2_0.8
            0.98             0.93             5.00
              1       2
udzial    0.522   0.478
srednia 139.497 141.560
sd        0.599   0.387
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Bengt Muthén – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1974, 1977, 1978, 1982, 1984, 1988, 1998, 1999, 2008, 2011),
  opis = c("gość University\nof Wisconsin", "doktorat w Uppsali\n(promotor Jöreskog)", "analiza czynnikowa\nzmiennych 0/1",
           "UCLA", "SEM ze wskaźnikami\nkategorialnymi", "prezes Psychometric\nSociety", "pierwsza\nwersja Mplus",
           "mieszaniny trajektorii\n(z Sheddenem)", "profesor\nemeritus", "nagroda Psychometric\nSociety za całokształt"),
  rodzaj = c("praca", "praca", "publikacja", "praca", "publikacja", "wyróżnienie", "publikacja", "publikacja",
             "praca", "wyróżnienie"),
  poziom = c(0.5, -0.5, 1.4, -1.5, 0.5, -0.5, 0.5, -1.5, 1.4, -0.5),   # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.7, 0.3, 0.5, 0.5))   # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1968, 2017), breaks = seq(1970, 2010, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.3)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (algorytm EM – własny kod w R; kontrola i dane – pakiet mclust; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mclust (wersja 6.1.2): Scrucca, L., Fraley, C., Murphy, T. B., & Raftery, A. E. (2023). Model-based clustering, classification, and density estimation using mclust in R. Chapman and Hall/CRC. https://doi.org/10.1201/9781003277965
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest Bengt Muthén?
To statystyk i psychometra, profesor emeritus UCLA Graduate School of Education & Information Studies. Studiował statystykę w Uppsali, gdzie w 1977 r. obronił doktorat pod kierunkiem Karla Jöreskoga. Od 1982 r. pracował na UCLA, w latach 1988–1989 był prezesem Psychometric Society, a w 2011 r. dostał jej nagrodę za całokształt pracy.
Co Bengt Muthén wniósł do modelowania równań strukturalnych?
Pokazał, jak w modelach SEM używać wskaźników dychotomicznych i porządkowych, np. pozycji testu i odpowiedzi na skalach Likerta, zamiast traktować je jak ciągłe. W pracy z 1984 r. w „Psychometrice” podał dla takich modeli trzystopniowy estymator z testem chi-kwadrat dopasowania i błędami standardowymi. Później rozwinął modele mieszanin, w tym modele mieszanin trajektorii wzrostu (GMM).
Kto stworzył program Mplus?
Mplus rozwija zespół, w którym są Linda Muthén, Bengt Muthén, Tihomir Asparouhov i Thuy Nguyen. Prace nad programem zaczęły się w październiku 1995 r., a pierwszą wersję wydano w listopadzie 1998 r. W programie zaimplementowano wiele metod opisanych w artykułach Bengta Muthéna.
Czym model mieszanin wzrostu Muthéna różni się od zwykłej krzywej wzrostu?
Zwykła krzywa wzrostu zakłada jedną średnią trajektorię dla całej populacji i różnice osób wokół niej. Model mieszanin wzrostu (Muthén i Shedden, 1999) zakłada kilka nieobserwowanych klas, z których każda ma własną średnią trajektorię, i szacuje udziały klas algorytmem EM – tak jak w przykładzie z banknotami, tylko dla danych podłużnych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza klas latentnych (LCA) krok po kroku
Wiele startów EM, BIC i BLRT, lokalna niezależność, profile i entropia, poprawka BCH dla zmiennych zewnętrznych i opis APA – z kodem R.
Czytaj →PoradnikKrzywe wzrostu (LGM) i modele zmiany
Krzywa wzrostu w lavaan na danych do pobrania: kształt zmiany, ujemna wariancja, kodowanie czasu, predyktor tempa, porównanie z lme4 i tabele APA.
Czytaj →PoradnikKategorialna CFA: WLSMV w lavaan
Kiedy pozycje Likerta są porządkowe, jak czytać progi, ML, MLR i WLSMV na tych samych danych, indeksy robust, rzadkie kategorie i opis APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Flury, B., & Riedwyl, H. (1988). Multivariate statistics: A practical approach. Chapman and Hall.
- Muthén & Muthén. (b.d.). Company information. statmodel.com. Pobrano 22 listopada 2026 z https://www.statmodel.com/company.html ● Otwarty dostęp
- Muthén, B. (1984). A general structural equation model with dichotomous, ordered categorical, and continuous latent variable indicators. Psychometrika, 49(1), 115–132. https://doi.org/10.1007/bf02294210
- Muthén, B. O. (b.d.). Vita. statmodel.com. Pobrano 22 listopada 2026 z https://www.statmodel.com/bmuthen/vita.html ● Otwarty dostęp
- Muthén, B., & Shedden, K. (1999). Finite mixture modeling with mixture outcomes using the EM algorithm. Biometrics, 55(2), 463–469. https://doi.org/10.1111/j.0006-341x.1999.00463.x
- Wijsen, L. D. (2023). Bengt Muthén. In Twenty interviews with Psychometric Society presidents (pp. 63–77). Springer. https://doi.org/10.1007/978-3-031-34858-7_6
Cytowania BibTeX
@book{flury1988multivariate, author={Flury, Bernhard and Riedwyl, Hans}, title={{Multivariate statistics: A practical approach}}, year={1988}, publisher={Chapman and Hall}}@misc{statmodelcompany, author={{Muthén \& Muthén}}, title={{Company information}}, howpublished={statmodel.com}, url={https://www.statmodel.com/company.html}}@article{muthen1984general, author={Muthén, Bengt}, title={{A general structural equation model with dichotomous, ordered categorical, and continuous latent variable indicators}}, journal={Psychometrika}, year={1984}, volume={49}, number={1}, pages={115--132}, doi={10.1007/bf02294210}}@misc{muthenvita, author={Muthén, Bengt O.}, title={{Vita}}, howpublished={statmodel.com}, url={https://www.statmodel.com/bmuthen/vita.html}}@article{muthen1999finite, author={Muthén, Bengt and Shedden, Kerby}, title={{Finite mixture modeling with mixture outcomes using the EM algorithm}}, journal={Biometrics}, year={1999}, volume={55}, number={2}, pages={463--469}, doi={10.1111/j.0006-341x.1999.00463.x}}@incollection{wijsen2023muthen, author={Wijsen, Lisa D.}, title={{Bengt Muthén}}, booktitle={Twenty interviews with Psychometric Society presidents}, year={2023}, pages={63--77}, publisher={Springer}, doi={10.1007/978-3-031-34858-7_6}}