Co to jest z-curve?
z-curve to metoda szacowania średniej mocy zbioru opublikowanych badań na podstawie samych istotnych wyników. Wartości p zamienia się na |z|, a rozkład wartości powyżej 1.96 modeluje się mieszaniną rozkładów normalnych o różnych średnich, z uwzględnieniem tego, że do druku trafiają głównie wyniki istotne. Brunner i Schimmack (2020) pokazali w symulacjach, że przy zróżnicowanych efektach i liczebnościach z-curve szacował średnią moc trafniej niż rozszerzenia p-curve i p-uniform, które ją zawyżały.
ERR i EDR
- ERR (expected replication rate) – przewidywany odsetek udanych dokładnych replikacji istotnych wyników, czyli średnia moc po selekcji.
- EDR (expected discovery rate) – szacowany udział wyników istotnych wśród wszystkich przeprowadzonych testów, także tych nieopublikowanych.
EDR wprowadzili Bartoš i Schimmack (2022) w wersji z-curve 2.0, razem z odpornymi przedziałami bootstrapowymi. Porównanie EDR z obserwowanym odsetkiem odkryć (ODR) pokazuje skalę selekcji. Z EDR wylicza się też górną granicę odsetka fałszywych odkryć (FDR Sorića).
z-curve a p-curve
P-curve odpowiada na pytanie, czy zbiór istotnych wyników ma wartość dowodową. z-curve szacuje, jaką moc miały badania i ile wyników mogło zostać w szufladzie. Obie metody różnią się od modeli selekcji w metaanalizie, które korygują średni efekt jednego zjawiska; z-curve łączy wyniki różnych testów, np. z całego czasopisma.
Przykład
Symulowano 2000 badań (40% bez efektu); publikowano wszystkie wyniki istotne i 10% nieistotnych. ODR wyniósł .83, a z-curve dał ERR = .55, 95% CI [.46, .63] (prawdziwie .59) i EDR = .23 [.08, .43] (prawdziwie .32). Przepaść między ODR a EDR to ślad błędu publikacji.
Na rysunku
Rysunek 1 pokazuje dane z przykładu tak, jak widzi je metoda. Ponieważ to symulacja, dorysowano też rozkład wszystkich 2000 przeprowadzonych testów, którego w prawdziwej literaturze nie znamy.
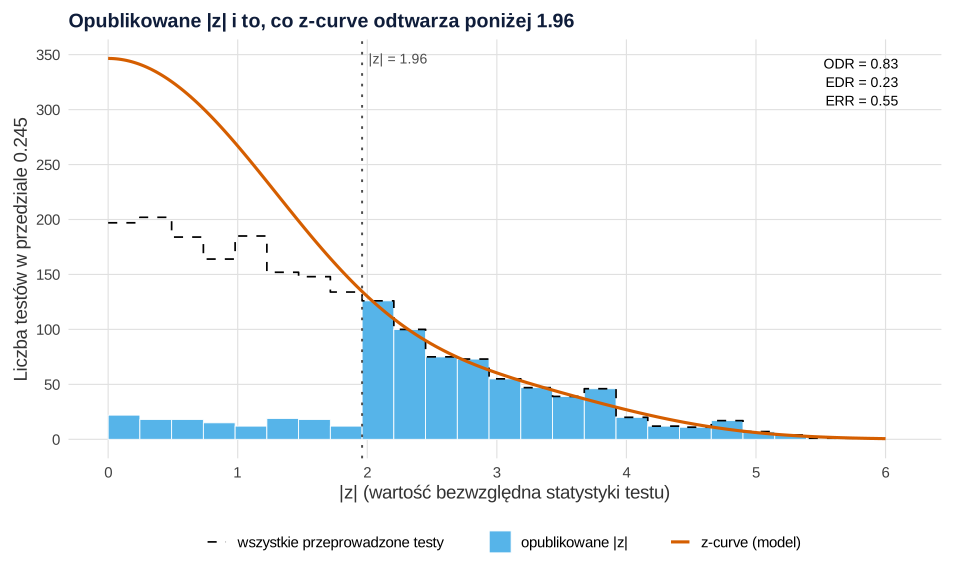
set.seed(7300)).Co widać. Słupki to 768 opublikowanych testów: 634 istotne i tylko 134 nieistotne, stąd uskok przy 1.96. Model dopasowuje się wyłącznie do słupków na prawo od tej linii i tam przylega do nich ściśle. Na lewo krzywa jest ekstrapolacją: mówi, ile wyników nieistotnych powinno było powstać, skoro powstało tyle istotnych. Pole pod krzywą odpowiada około 2700 testom, z czego 23% istotnych – to jest EDR. Różnica między krzywą a słupkami po lewej to szacowana szuflada.
Na co uważać. Przerywana linia pokazuje, że w rzeczywistości przeprowadzono 2000 testów, w tym 1366 nieistotnych. Krzywa leży nad nią, więc model przeszacował szufladę i zaniżył EDR (.23 zamiast .32). Mieści się to w szerokim przedziale [.08, .43] z przykładu: kształt lewej części krzywej wynika z założeń modelu, a nie z danych. Wysokość słupków poniżej 1.96 nie wpływa na oszacowania – liczy się tylko do ODR. Na prawdziwym wykresie z-curve nie ma też linii prawdy, więc nie wiadomo, czy krzywa przesadza. Czym jest moc pokazana jako pole pod rozkładem, wyjaśnia wpis moc testu w obrazkach.
Podpis do pracy:
Kod rysunku odtwarza dane z przykładu (to samo ziarno 7300) i dopasowuje z-curve bez bootstrapu – oszacowania punktowe są te same. Wagi modelu dotyczą wyników istotnych, więc kod przelicza je na wagi wszystkich testów. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Opublikowane wartości |z|, dopasowana z-curve i (znany tylko w symulacji) rozkład wszystkich testów
library(zcurve)
library(ggplot2)

# Paleta Okabe–Ito i prosty motyw
kol <- c(opubl = "#56B4E9", model = "#D55E00", wszystkie = "black")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Te same dane co w przykładzie: 2000 badań, w druk trafiają istotne i 10% nieistotnych
set.seed(7300)
N <- 2000
ncp <- sample(c(0, 1.5, 3), N, replace = TRUE, prob = c(.4, .4, .2))
z <- abs(rnorm(N, mean = ncp))
istotne <- z > qnorm(.975)
opubl <- istotne | runif(N) < .10
fit <- zcurve(z = z[opubl], bootstrap = FALSE)           # oszacowania punktowe jak w przykładzie (bez bootstrapu)

# Wagi EM dotyczą wyników istotnych (1.96 < |z| < 6); przeliczamy je na wagi wszystkich testów
mu <- fit$fit$mu; w <- fit$fit$weights; a <- qnorm(.975); b <- 6
p_okno <- function(m) pnorm(b - m) - pnorm(a - m) + pnorm(-a - m) - pnorm(-b - m)
w_all <- (w / p_okno(mu)) / sum(w / p_okno(mu))
moc <- pnorm(mu - a) + pnorm(-mu - a)
N_ocz <- sum(z[opubl] > a) / sum(w_all * moc)           # oczekiwana liczba wszystkich testów (= istotne / EDR)
round(c(EDR = sum(w_all * moc), N_oczekiwane = N_ocz, n_istotnych_opubl = sum(z[opubl] > a),
        n_nieistotnych_opubl = sum(z[opubl] <= a), n_nieistotnych_wszystkich = sum(!istotne)), 3)

# Krzywa: oczekiwana liczba |z| w przedziale o szerokości 1.96 / 8 = 0.245 (granica przedziałów w 1.96)
szer <- a / 8
siatka <- seq(0, 6, by = 0.02)
gest <- sapply(siatka, function(x) sum(w_all * (dnorm(x - mu) + dnorm(x + mu))))
krzywa <- data.frame(z = siatka, liczba = N_ocz * szer * gest)
granice <- seq(0, by = szer, length.out = 26)
wszystkie <- data.frame(z = granice, liczba = c(hist(pmin(z, 5.999), breaks = granice, plot = FALSE)$counts, NA))

p <- ggplot() +
  geom_histogram(data = data.frame(z = pmin(z[opubl], 5.999)), aes(z, fill = "opublikowane |z|"),
                 breaks = granice, colour = "white", linewidth = 0.3) +
  geom_step(data = wszystkie, aes(z, liczba, linetype = "wszystkie przeprowadzone testy"),
            colour = kol[["wszystkie"]], linewidth = 0.6, direction = "hv", na.rm = TRUE) +
  geom_line(data = krzywa, aes(z, liczba, colour = "z-curve (model)"), linewidth = 1.1) +
  geom_vline(xintercept = a, colour = "grey30", linetype = "dotted", linewidth = 0.7) +
  annotate("text", x = a + 0.05, y = max(krzywa$liczba), label = "|z| = 1.96", hjust = 0, size = 3.7, colour = "grey30") +
  annotate("text", x = 6.1, y = max(krzywa$liczba), hjust = 1, vjust = 1, size = 3.7, lineheight = 1.1,
           label = sprintf("ODR = %.2f\nEDR = %.2f\nERR = %.2f",
                           mean(z[opubl] > a), fit$coefficients[["EDR"]], fit$coefficients[["ERR"]])) +
  scale_fill_manual(values = kol[["opubl"]], name = NULL) +
  scale_colour_manual(values = kol[["model"]], name = NULL) +
  scale_linetype_manual(values = "dashed", name = NULL) +
  scale_x_continuous(breaks = 0:6) +
  scale_y_continuous(breaks = seq(0, 500, 50)) +

  labs(title = "Opublikowane |z| i to, co z-curve odtwarza poniżej 1.96",
       x = "|z| (wartość bezwzględna statystyki testu)", y = "Liczba testów w przedziale 0.245") +
  motyw
p
Wynik w R
                      EDR              N_oczekiwane         n_istotnych_opubl
                    0.234                  2711.772                   634.000
     n_nieistotnych_opubl n_nieistotnych_wszystkich
                  134.000                  1366.000
Jak opisać w pracy
Na co uważać
- Jeden test na badanie. Koduj statystykę dla głównej hipotezy, a nie wszystkie wartości z tabel – wyniki zależne zawyżają precyzję.
- Niepewność EDR. Nawet przy kilkuset wartościach z przedział dla EDR bywa szeroki; zawsze go podawaj.
- Selekcja inna niż próg istotności. P-hacking zagęszcza wyniki tuż nad 1.96, a model zakłada selekcję tylko według istotności, więc oceny mogą być obciążone.
Metodę stosuje się w dyskusji o kryzysie replikacyjnym; ERR to oszacowanie, nie wynik rzeczywistych replikacji.
z-curve w R
Kod symuluje literaturę z selekcją wyników istotnych, liczy prawdziwe EDR i ERR oraz ODR, a potem dopasowuje z-curve 2.0 funkcją zcurve::zcurve() z przedziałami bootstrapowymi. Liczby w tekście pochodzą z tego kodu.
ERR, EDR i ODR z opublikowanych wartości z
R
set.seed(7300)
library(zcurve)
N <- 2000                                                  # przeprowadzone badania
ncp <- sample(c(0, 1.5, 3), N, replace = TRUE, prob = c(.4, .4, .2))
z <- abs(rnorm(N, mean = ncp))                             # |z| z testów dwustronnych
istotne <- z > qnorm(.975)
opubl <- istotne | runif(N) < .10                          # w druk trafia 10% wyników nieistotnych
moc <- pnorm(ncp - qnorm(.975)) + pnorm(-ncp - qnorm(.975))
round(c(EDR_prawdziwe = mean(moc), ERR_prawdziwe = sum(moc^2) / sum(moc),
        ODR = mean(istotne[opubl]), n_opubl = sum(opubl), n_istotnych = sum(istotne)), 3)
fit <- zcurve(z = z[opubl], bootstrap = 500)
summary(fit, all = TRUE)                                  # ERR, EDR, FDR Sorića, liczba "w szufladzie"
Wynik w R
EDR_prawdziwe ERR_prawdziwe           ODR       n_opubl   n_istotnych
        0.321         0.589         0.826       768.000       634.000
Call:
zcurve(z = z[opubl], bootstrap = 500)

model: EM via EM

              Estimate  l.CI   u.CI
ERR              0.546 0.462  0.630
EDR              0.234 0.080  0.432
Soric FDR        0.173 0.069  0.606
File Drawer R    3.281 1.312 11.516
Expected N        2714  1466   7935
Missing N         1946   698   7167

Model converged in 47 + 1537 iterations
Fitted using 634 z-values. 768 supplied, 634 significant (ODR = 0.83, 95% CI [0.80, 0.85]).
Q = -596.33, 95% CI[-638.62, -557.53]
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet zcurve). Rysunek 1 wykonano w pakiecie ggplot2, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- zcurve (wersja 2.4.7): Bartoš, F., & Schimmack, U. (2020). zcurve: An R package for fitting z-curves (R package version 2.4.7) [Computer software]. https://doi.org/10.32614/CRAN.package.zcurve
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym różni się ERR od EDR w z-curve?
ERR to przewidywany odsetek udanych dokładnych replikacji istotnych wyników (średnia moc po selekcji). EDR to szacowany udział wyników istotnych wśród wszystkich przeprowadzonych testów, także nieopublikowanych; jest zwykle niższy.
Kiedy użyć z-curve, a kiedy p-curve?
P-curve sprawdza, czy zbiór istotnych wyników ma wartość dowodową. z-curve szacuje średnią moc, oczekiwany odsetek replikacji i skalę selekcji, także dla wyników różnych testów z wielu badań.
Ile wartości z potrzeba do z-curve?
Nie ma sztywnej granicy, ale przy małej liczbie istotnych wyników przedziały są bardzo szerokie. W przykładzie z 634 wartościami 95% CI dla EDR wyniósł [.08, .43].
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bartoš, F., & Schimmack, U. (2022). Z-curve 2.0: Estimating replication rates and discovery rates. Meta-Psychology, 6. https://doi.org/10.15626/mp.2021.2720 ● Otwarty dostęp
- Brunner, J., & Schimmack, U. (2020). Estimating population mean power under conditions of heterogeneity and selection for significance. Meta-Psychology, 4. https://doi.org/10.15626/mp.2018.874 ● Otwarty dostęp
Cytowania BibTeX
@article{bartos2022zcurve, author={Bartoš, František and Schimmack, Ulrich}, title={{Z-curve 2.0: Estimating replication rates and discovery rates}}, journal={Meta-Psychology}, year={2022}, volume={6}, doi={10.15626/mp.2021.2720}}@article{brunner2020estimating, author={Brunner, Jerry and Schimmack, Ulrich}, title={{Estimating population mean power under conditions of heterogeneity and selection for significance}}, journal={Meta-Psychology}, year={2020}, volume={4}, doi={10.15626/mp.2018.874}}