Co to jest model wspólny?
Wspólny model danych podłużnych i czasu do zdarzenia (joint model) łączy dwa podmodele: liniowy model mieszany dla powtarzanych pomiarów markera, np. biomarkera albo wyniku skali, oraz model czasu do zdarzenia, zwykle model proporcjonalnych hazardów. Spinają je wspólne efekty losowe. Hazard w chwili t zależy od prawdziwej, wolnej od błędu wartości markera mi(t) = (β0 + b0i) + (β1 + b1i)t, a nie od ostatniego zmierzonego wyniku. Parametr powiązania α mówi, o ile rośnie log-hazard, gdy marker wzrośnie o jednostkę. Podmodel podłużny to ten sam model wielopoziomowy, który opisuje modele wzrostu w lme4.
Po co, skoro jest Cox ze zmienną zależną od czasu?
Zmienna zależna od czasu w modelu Coxa zakłada, że marker znamy dokładnie w każdej chwili. Biomarker mierzony rzadko i z błędem łamie to założenie, a błąd pomiaru zaniża α. Wulfsohn i Tsiatis (1997) szacowali oba podmodele z jednej, wspólnej wiarygodności (algorytmem EM) i argumentowali, że to podejście jest lepsze od naiwnego Coxa z obserwowanymi wartościami oraz od metody dwuetapowej.
Drugi powód to utrata uczestników. Gdy zgon lub rezygnacja przerywa serię pomiarów i zależy od trajektorii, braki w danych podłużnych nie są losowe (MNAR), a sam model mieszany bywa obciążony. Rizopoulos (2010) wymienia odpadnięcie z badania jako typowe zdarzenie w takich modelach i opisuje pakiet JM.
Przykład
W symulowanej kohorcie 300 pacjentów (1402 pomiary markera, 189 zdarzeń) prawdziwe α wynosi 0.6. Naiwny Cox z ostatnim pomiarem dał α = 0.45. Model wspólny dał α = 0.57 (SE = 0.07), czyli HR = 1.77, 95% CI [1.53, 2.05] na jednostkę markera. Dla leczenia HR = 0.68 [0.50, 0.91].
Na rysunku
Rysunek pokazuje, czym różni się „bieżąca wartość markera” w modelu wspólnym od ostatniego pomiaru w naiwnym modelu Coxa. Dane i oba modele pochodzą z przykładu wyżej. Czterech pacjentów wybrano regułą, nie na oko: pierwszych dwóch ze zdarzeniem i pierwszych dwóch cenzurowanych spośród osób z co najmniej pięcioma pomiarami.
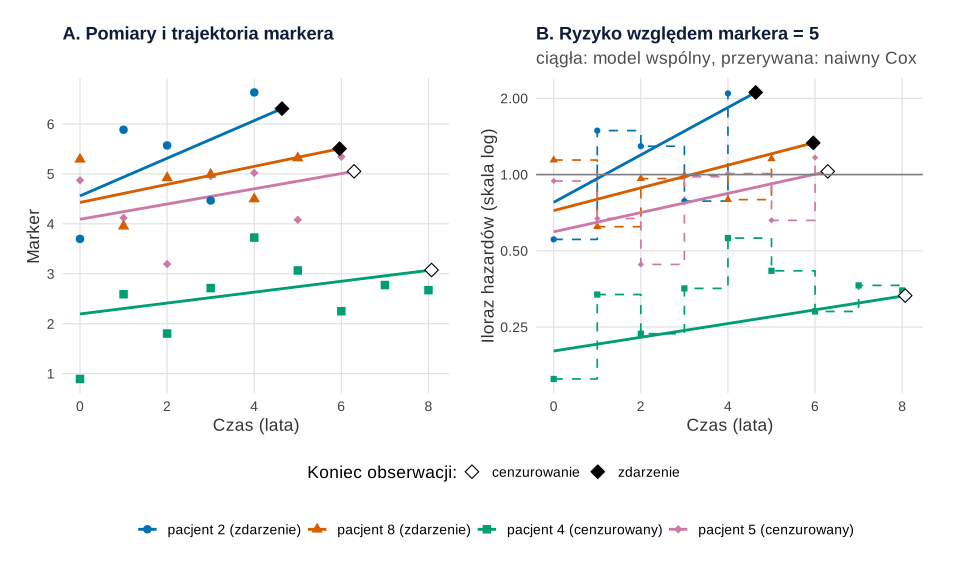
Co widać. W panelu A pomiary rozrzucają się wokół prostych trajektorii, bo marker mierzono z błędem (SD = 0.7). W panelu B ryzyko z modelu wspólnego zmienia się płynnie razem z trajektorią: u pacjenta 2 iloraz hazardów względem osoby z markerem 5 rośnie do 2.11 w chwili zdarzenia, a u pacjenta 4, cenzurowanego po 8 latach, wynosi 0.33. Schodki naiwnego Coxa skaczą przy każdej wizycie, bo każdy pomiar niesie swój błąd. Ten szum osłabia oszacowany związek, stąd α = 0.45 zamiast 0.57 w modelu wspólnym (prawdziwe 0.6).
Na co uważać. Trajektorie z modelu są ściągnięte w stronę średniej (kurczenie efektów losowych, zob. Model mieszany w obrazkach), więc nie są „prawdziwymi” trajektoriami pacjentów. Iloraz hazardów pomija leczenie i hazard bazowy, więc nie jest to bezwzględne ryzyko. Do tego służą przewidywania dynamiczne, których rysunek nie pokazuje. Cztery osoby nie mówią nic o całej kohorcie. Trajektorie wszystkich pacjentów pokazuje wykres spaghetti, a inne sposoby rysowania danych podłużnych – wpis Dane podłużne na wykresie. Punkt odniesienia 5 to średni marker na starcie w symulacji, przyjęty ręcznie.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tej sekcji (ziarno jak w przykładzie: set.seed(7211)). Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Trajektorie markera u czterech pacjentów (A) i wynikające z nich ryzyko zdarzenia (B).
# Dane i model wspólny jak w przykładzie hasła (set.seed(7211)); naiwny Cox używa ostatniego pomiaru.
set.seed(7211)
suppressPackageStartupMessages({library(nlme); library(survival); library(JM)
  library(ggplot2); library(patchwork)})
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))
kol <- c("#0072B2", "#D55E00", "#009E73", "#CC79A7")      # Okabe–Ito; pacjentów odróżniają też kształty i etykiety

# --- dane i oba modele: kod identyczny z przykładem w haśle ---
n <- 300
leczenie <- rbinom(n, 1, 0.5)
b0 <- rnorm(n, 5, 1); b1 <- rnorm(n, 0.3, 0.2)
alfa <- 0.6; gamma <- -0.5; h0 <- 0.005
skala <- h0 * exp(gamma * leczenie + alfa * b0)
arg <- 1 + alfa * b1 * (-log(runif(n))) / skala
T_zd <- rep(Inf, n)
T_zd[arg > 0] <- log(arg[arg > 0]) / (alfa * b1[arg > 0])
C <- runif(n, 4, 10)
czas <- pmin(T_zd, C); zdarzenie <- as.numeric(T_zd <= C)
dlug <- do.call(rbind, lapply(1:n, function(i) {
  t <- seq(0, 9)[seq(0, 9) < czas[i]]
  data.frame(id = i, t = t, y = b0[i] + b1[i] * t + rnorm(length(t), 0, 0.7))
}))
surv <- data.frame(id = 1:n, czas, zdarzenie, leczenie)
dlug$leczenie <- leczenie[dlug$id]
dlug$stop <- ave(dlug$t, dlug$id, FUN = function(x) c(x[-1], NA))
dlug$stop <- ifelse(is.na(dlug$stop), czas[dlug$id], pmin(dlug$stop, czas[dlug$id]))
dlug$zd <- ifelse(dlug$stop == czas[dlug$id], zdarzenie[dlug$id], 0)
naiwny <- coxph(Surv(t, stop, zd) ~ leczenie + y, data = dlug)
fit_lme <- lme(y ~ t, random = ~ t | id, data = dlug)
fit_cox <- coxph(Surv(czas, zdarzenie) ~ leczenie, data = surv, x = TRUE)
wspolny <- jointModel(fit_lme, fit_cox, timeVar = "t", method = "piecewise-PH-aGH")

# --- wybór pacjentów regułą (nie „na oko”): pierwszych dwóch ze zdarzeniem i dwóch cenzurowanych
#     wśród osób z co najmniej 5 pomiarami, w kolejności numerów
n_pom <- table(dlug$id)
kand <- as.numeric(names(n_pom)[n_pom >= 5])
wyb <- c(head(kand[zdarzenie[kand] == 1], 2), head(kand[zdarzenie[kand] == 0], 2))
alfa_jm <- unname(wspolny$coefficients$alpha); alfa_naiwny <- unname(coef(naiwny)["y"])
beta <- wspolny$coefficients$betas                         # efekty stałe podmodelu markera
re <- ranef(wspolny)                                       # efekty losowe pacjentów (b0i, b1i)
ref <- 5                                                   # punkt odniesienia dla HR: średni marker na starcie (b0 ~ N(5, 1))
etyk <- setNames(sprintf("pacjent %d (%s)", wyb, ifelse(zdarzenie[wyb] == 1, "zdarzenie", "cenzurowany")), wyb)
etyk <- factor(etyk, levels = etyk)
traj <- do.call(rbind, lapply(wyb, function(i) {
  t <- seq(0, czas[i], length.out = 60)
  m <- (beta[1] + re[i, 1]) + (beta[2] + re[i, 2]) * t     # trajektoria z modelu wspólnego (bez błędu pomiaru)
  data.frame(id = i, pacjent = unname(etyk[as.character(i)]), t, m, hr = exp(alfa_jm * (m - ref)))
}))
schod <- subset(dlug, id %in% wyb)                          # naiwny Cox: ostatni pomiar do następnej wizyty
schod$pacjent <- etyk[as.character(schod$id)]
schod$hr <- exp(alfa_naiwny * (schod$y - ref))
koniec <- do.call(rbind, lapply(split(traj, traj$id), tail, 1))   # ostatni punkt trajektorii = koniec obserwacji
koniec$typ <- ifelse(zdarzenie[koniec$id] == 1, "zdarzenie", "cenzurowanie")
koniec <- koniec[match(wyb, koniec$id), ]
round(c(alfa_wspolny = alfa_jm, alfa_naiwny = alfa_naiwny), 3)
data.frame(pacjent = as.character(etyk), pomiary = as.vector(n_pom[as.character(wyb)]),
           czas = round(koniec$t, 2), m_koniec = round(koniec$m, 2), HR_koniec = round(koniec$hr, 2))

pA <- ggplot() +
  geom_line(data = traj, aes(t, m, colour = pacjent), linewidth = 1) +
  geom_point(data = schod, aes(t, y, colour = pacjent, shape = pacjent), size = 2.6) +
  geom_point(data = koniec, aes(t, m, fill = typ), shape = 23, size = 3.4, colour = "black") +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(16, 17, 15, 18), name = NULL) +
  scale_fill_manual(values = c(zdarzenie = "black", cenzurowanie = "white"), name = "Koniec obserwacji:") +
  labs(title = "A. Pomiary i trajektoria markera", x = "Czas (lata)", y = "Marker") + motyw
pB <- ggplot() +
  geom_step(data = schod, aes(t, hr, colour = pacjent), linetype = "dashed", linewidth = 0.6) +
  geom_point(data = schod, aes(t, hr, colour = pacjent, shape = pacjent), size = 1.8) +
  geom_line(data = traj, aes(t, hr, colour = pacjent), linewidth = 1) +
  geom_point(data = koniec, aes(t, hr, fill = typ), shape = 23, size = 3.4, colour = "black") +
  geom_hline(yintercept = 1, colour = "grey50") +
  scale_y_log10(breaks = c(0.25, 0.5, 1, 2, 4, 8)) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(16, 17, 15, 18), name = NULL) +
  scale_fill_manual(values = c(zdarzenie = "black", cenzurowanie = "white"), name = "Koniec obserwacji:") +
  labs(title = "B. Ryzyko względem markera = 5",
       subtitle = "ciągła: model wspólny, przerywana: naiwny Cox",
       x = "Czas (lata)", y = "Iloraz hazardów (skala log)") +
  guides(colour = "none", shape = "none", fill = "none") + motyw         # legenda wspólna z panelem A
p1 <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom", legend.box = "vertical")
p1   # zapis: ggsave("model-wspolny-trajektoria-i-ryzyko.svg", p1, width = 10, height = 6)
Wynik w R
alfa_wspolny  alfa_naiwny
       0.572        0.452
                  pacjent pomiary czas m_koniec HR_koniec
1   pacjent 2 (zdarzenie)       5 4.64     6.31      2.11
2   pacjent 8 (zdarzenie)       6 5.96     5.50      1.33
3 pacjent 4 (cenzurowany)       9 8.07     3.07      0.33
4 pacjent 5 (cenzurowany)       7 6.29     5.05      1.03
Jak opisać w pracy
Na co uważać
- Kształt trajektorii. Źle opisana trajektoria przenosi błąd na α.
- Postać powiązania. Bieżąca wartość, nachylenie czy pole pod krzywą to różne hipotezy; wybierz je przed analizą.
- Kilka markerów. JM łączy jeden marker; dla kilku naraz Hickey i in. (2018) opisują pakiet joineRML.
Podstawy modelu przeżycia streszcza hasło analiza przeżycia.
Model wspólny w R
Kod symuluje marker z losowym wyrazem wolnym i nachyleniem, czasy zdarzeń zależne od prawdziwej trajektorii oraz pomiary z błędem co rok, a potem porównuje naiwny model Coxa z modelem wspólnym z pakietu JM. Liczby w tekście pochodzą z tego kodu.
Naiwny Cox a model wspólny
R
set.seed(7211)
suppressPackageStartupMessages({library(nlme); library(survival); library(JM)})
n <- 300                                              # pacjenci (dane symulowane)
leczenie <- rbinom(n, 1, 0.5)
b0 <- rnorm(n, 5, 1); b1 <- rnorm(n, 0.3, 0.2)        # losowy wyraz wolny i nachylenie markera
alfa <- 0.6; gamma <- -0.5; h0 <- 0.005               # prawdziwe parametry ryzyka
skala <- h0 * exp(gamma * leczenie + alfa * b0)
arg <- 1 + alfa * b1 * (-log(runif(n))) / skala       # odwrócenie skumulowanego hazardu
T_zd <- rep(Inf, n)                                   # arg <= 0: zdarzenie nigdy nie nastąpi
T_zd[arg > 0] <- log(arg[arg > 0]) / (alfa * b1[arg > 0])
C <- runif(n, 4, 10)
czas <- pmin(T_zd, C); zdarzenie <- as.numeric(T_zd <= C)
dlug <- do.call(rbind, lapply(1:n, function(i) {      # pomiary co rok, aż do zdarzenia lub cenzurowania
  t <- seq(0, 9)[seq(0, 9) < czas[i]]
  data.frame(id = i, t = t, y = b0[i] + b1[i] * t + rnorm(length(t), 0, 0.7))
}))
surv <- data.frame(id = 1:n, czas, zdarzenie, leczenie)
dlug$leczenie <- leczenie[dlug$id]
c(pacjenci = n, pomiary = nrow(dlug), zdarzenia = sum(zdarzenie))
# model naiwny: Cox z ostatnim obserwowanym pomiarem markera (zmienna zależna od czasu)
dlug$stop <- ave(dlug$t, dlug$id, FUN = function(x) c(x[-1], NA))
dlug$stop <- ifelse(is.na(dlug$stop), czas[dlug$id], pmin(dlug$stop, czas[dlug$id]))
dlug$zd <- ifelse(dlug$stop == czas[dlug$id], zdarzenie[dlug$id], 0)
naiwny <- coxph(Surv(t, stop, zd) ~ leczenie + y, data = dlug)
round(coef(naiwny), 3)
# model wspólny: podmodel mieszany + podmodel czasu do zdarzenia, wspólna wiarygodność
fit_lme <- lme(y ~ t, random = ~ t | id, data = dlug)
fit_cox <- coxph(Surv(czas, zdarzenie) ~ leczenie, data = surv, x = TRUE)
wspolny <- jointModel(fit_lme, fit_cox, timeVar = "t", method = "piecewise-PH-aGH")
round(summary(wspolny)$`CoefTable-Event`[c("leczenie", "Assoct"), ], 3)  # Assoct = alfa
round(exp(confint(wspolny, parm = "Event")), 3)       # HR: na 1 jednostkę markera i dla leczenia
Wynik w R
 pacjenci   pomiary zdarzenia
      300      1402       189
leczenie        y
  -0.354    0.452
          Value Std.Err z-value p-value
leczenie -0.393   0.151  -2.606   0.009
Assoct    0.572   0.073   7.781   0.000
         2.5 %  est. 97.5 %
leczenie 0.502 0.675  0.907
Assoct   1.534 1.771  2.046
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety nlme, survival i JM). Rysunek 1 wykonano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- nlme (wersja 3.1.168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models [R package]. https://doi.org/10.32614/CRAN.package.nlme
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- JM (wersja 1.5.2): Rizopoulos, D. (2010). JM: An R package for the joint modelling of longitudinal and time-to-event data. Journal of Statistical Software, 35(9), 1–33. https://doi.org/10.18637/jss.v035.i09
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym model wspólny różni się od Coxa ze zmienną zależną od czasu?
Cox ze zmienną zależną od czasu używa zmierzonych wartości markera, przenosząc ostatni pomiar do następnej wizyty. Model wspólny używa trajektorii oszacowanej modelem mieszanym, więc uwzględnia błąd pomiaru i rzadkie wizyty. W przykładzie naiwny Cox dał α = 0.45, a model wspólny 0.57 przy prawdziwej wartości 0.6.
Kiedy warto użyć modelu wspólnego?
Gdy marker mierzony z błędem i w odstępach ma przewidywać zdarzenie albo gdy zdarzenie (np. zgon lub rezygnacja) przerywa serię pomiarów i może zależeć od trajektorii, przez co sam model mieszany byłby obciążony.
Jak to policzyć w R?
Dopasuj lme() z nlme dla markera i coxph(..., x = TRUE) z survival dla czasu do zdarzenia (jeden wiersz na osobę), a potem połącz je funkcją JM::jointModel() z argumentem timeVar. Kilka markerów naraz obsługuje pakiet joineRML.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hickey, G. L., Philipson, P., Jorgensen, A., & Kolamunnage-Dona, R. (2018). joineRML: A joint model and software package for time-to-event and multivariate longitudinal outcomes. BMC Medical Research Methodology, 18(1), Article 50. https://doi.org/10.1186/s12874-018-0502-1 ● Otwarty dostęp
- Rizopoulos, D. (2010). JM: An R package for the joint modelling of longitudinal and time-to-event data. Journal of Statistical Software, 35(9), 1–33. https://doi.org/10.18637/jss.v035.i09 ● Otwarty dostęp
- Wulfsohn, M. S., & Tsiatis, A. A. (1997). A joint model for survival and longitudinal data measured with error. Biometrics, 53(1), 330–339. https://doi.org/10.2307/2533118
Cytowania BibTeX
@article{hickey2018joinerml, author={Hickey, Graeme L. and Philipson, Pete and Jorgensen, Andrea and Kolamunnage-Dona, Ruwanthi}, title={{joineRML: A joint model and software package for time-to-event and multivariate longitudinal outcomes}}, journal={BMC Medical Research Methodology}, year={2018}, volume={18}, number={1}, eid={50}, doi={10.1186/s12874-018-0502-1}}@article{rizopoulos2010jm, author={Rizopoulos, Dimitris}, title={{JM: An R package for the joint modelling of longitudinal and time-to-event data}}, journal={Journal of Statistical Software}, year={2010}, volume={35}, number={9}, pages={1--33}, doi={10.18637/jss.v035.i09}}@article{wulfsohn1997joint, author={Wulfsohn, Michael S. and Tsiatis, Anastasios A.}, title={{A joint model for survival and longitudinal data measured with error}}, journal={Biometrics}, year={1997}, volume={53}, number={1}, pages={330--339}, doi={10.2307/2533118}}