Co to są wątpliwe praktyki badawcze?
Wątpliwe praktyki badawcze (ang. questionable research practices, QRP) to decyzje przy zbieraniu, analizie i raportowaniu danych, które nie są jawnym oszustwem, ale zwiększają szansę na „ładny” wynik kosztem jego wiarygodności. Leżą w szarej strefie między rzetelną praktyką a nierzetelnością naukową, czyli fabrykowaniem, fałszowaniem danych i plagiatem. Zwykle nie wynikają ze złej woli, tylko z presji publikacyjnej i braku planu analizy.
Typowe przykłady
- dobieranie kolejnych osób do próby, aż wynik stanie się istotny, i przerwanie badania w tym momencie;
- raportowanie tylko tych zmiennych zależnych, warunków lub badań, które „wyszły”;
- usuwanie obserwacji odstających albo dodawanie zmiennych kontrolnych po obejrzeniu wyników;
- przedstawianie hipotez sformułowanych po analizie jako założonych z góry, czyli HARKing;
- zaokrąglanie p = .054 do „p < .05”.
Wiele z tych decyzji składa się na p-hacking i korzysta z ogrodu rozwidlających się ścieżek.
Jak często się zdarzają i dlaczego szkodzą
John i in. (2012) zapytali ponad 2000 psychologów o udział w takich praktykach, stosując anonimową ankietę z zachętami do szczerości. Odsetek przyznających się był zaskakująco wysoki, co sugeruje, że część QRP stała się normą. W metaanalizie, którą przeprowadził Fanelli (2009), do sfabrykowania lub sfałszowania danych przynajmniej raz przyznało się średnio 1.97% badaczy, a do innych wątpliwych praktyk – do 33.7%. Simmons i in. (2011) pokazali w symulacjach i eksperymentach, że nieujawniona elastyczność w zbieraniu i analizie danych radykalnie zwiększa odsetek wyników fałszywie pozytywnych. To jedna z przyczyn kryzysu replikacyjnego.
Na rysunku
Symulacja w duchu Simmonsa i in. (2011): 5000 badań porównujących dwie grupy, w których w populacji nie ma żadnej różnicy. Badacz łączy dwie praktyki z listy powyżej: sprawdza od 1 do 4 zmiennych zależnych (skorelowanych na poziomie r = .5) i po każdym nieistotnym wyniku dobiera 10 osób do grupy, zaczynając od 20, a potem liczy test od nowa. Sukces to p < .05 w którejkolwiek zmiennej przy którymkolwiek podglądzie.
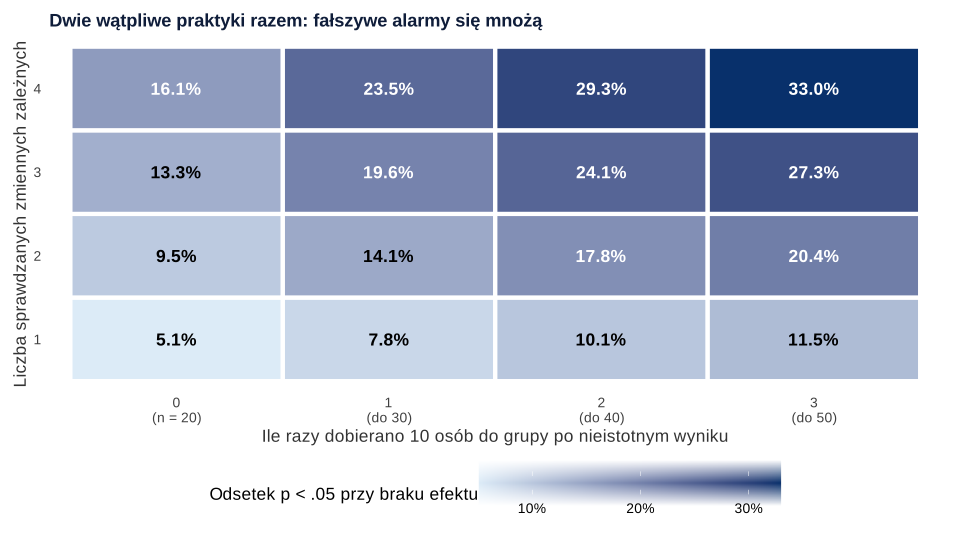
set.seed(704)).Co widać. Lewy dolny róg to badanie zrobione zgodnie z planem: 5.1% fałszywych alarmów, czyli tyle, ile wynosi α. Dwie zmienne zależne dają 9.5%, jedno dobieranie osób – 7.8%, a obie praktyki razem – 14.1%. Przy czterech zmiennych i trzech dobieraniach co trzecie badanie bez efektu kończy się „istotnym” wynikiem (33.0%). Błąd Monte Carlo nie przekracza 0.7 punktu procentowego.
Na co uważać. Odsetki rosną szybciej niż przy jednej praktyce, ale nie sumują się – zmienne są skorelowane, a kolejne podglądy dotyczą tych samych osób. Rysunek pokazuje tylko dwie praktyki i badacza, który zawsze wykorzystuje każdą okazję; dodanie kowariantu czy usuwanie odstających podnosi odsetek dalej. Wpływ pojedynczych praktyk pokazuje rysunek w haśle p-hacking, a samo dobieranie osób – hasło opcjonalne zatrzymywanie. Kolor jest tu tylko dodatkiem: wartości są wpisane w komórki.
Podpis do pracy:
Kod odtwarza rysunek i liczby z akapitu (kilka sekund). Parametry (start od 20 osób, krok 10 osób, najwyżej 3 dobierania, r = .5) ustawiono ręcznie na wzór Simmonsa i in. (2011); ziarno 704 ustalono raz i nie zmieniano. Kod definiuje sam paletę i motyw; rysunek na stronie różni się tylko krojem czcionki.
Kod R rysunku 1
# Rysunek 1. Odsetek wyników fałszywie pozytywnych przy łączeniu dwóch praktyk:
# kilka zmiennych zależnych × dobieranie osób po nieistotnym wyniku (brak efektu w populacji)
library(ggplot2)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))

set.seed(704)
R <- 5000                 # liczba symulowanych badań
n0 <- 20; dodatek <- 10   # start: 20 osób w grupie; po każdym nieistotnym wyniku +10 osób w grupie
k_max <- 3                # najwyżej 3 dobierania (do 50 osób w grupie)
J <- 4; r <- 0.5          # do 4 zmiennych zależnych skorelowanych r = .5
n_max <- n0 + k_max * dodatek
L <- chol(matrix(r, J, J) + diag(1 - r, J))                  # korelacja między zmiennymi zależnymi
p_t <- function(x, y) {                                      # p testu t (równe wariancje) dla każdej kolumny
  n <- nrow(x); sp <- sqrt((apply(x, 2, var) + apply(y, 2, var)) / 2)
  t <- (colMeans(x) - colMeans(y)) / (sp * sqrt(2 / n))
  2 * pt(-abs(t), 2 * n - 2)
}
sukces <- array(FALSE, c(R, J, k_max + 1))                   # [badanie, liczba zmiennych, liczba dobierań]
for (b in 1:R) {
  x <- matrix(rnorm(n_max * J), n_max) %*% L                 # grupa eksperymentalna
  y <- matrix(rnorm(n_max * J), n_max) %*% L                 # grupa kontrolna (ten sam rozkład)
  istotne <- sapply(0:k_max, function(k) { n <- n0 + k * dodatek; p_t(x[1:n, ], y[1:n, ]) < 0.05 })  # J × (k_max + 1)
  for (j in 1:J) for (k in 0:k_max)                          # sukces: p < .05 w którejś z j zmiennych przy którymś z k + 1 podglądów
    sukces[b, j, k + 1] <- any(istotne[1:j, 1:(k + 1)])
}
fpr <- apply(sukces, c(2, 3), mean)
dimnames(fpr) <- list(zmienne = 1:J, dobierania = 0:k_max)
round(100 * fpr, 1)                                          # odsetek fałszywie pozytywnych (%)
round(100 * sqrt(max(fpr) * (1 - max(fpr)) / R), 1)          # największy błąd Monte Carlo (pp)
d <- as.data.frame(as.table(fpr), responseName = "fpr")
d$etykieta <- sprintf("%.1f%%", 100 * d$fpr)
p1 <- ggplot(d, aes(dobierania, zmienne, fill = fpr)) +
  geom_tile(colour = "white", linewidth = 1.5) +
  geom_text(aes(label = etykieta, colour = fpr > 0.15), size = 4.6, fontface = "bold", show.legend = FALSE) +
  scale_fill_gradient(low = "#DCEBF7", high = "#08306B", labels = function(x) paste0(100 * x, "%"),
                      name = "Odsetek p < .05 przy braku efektu") +
  scale_colour_manual(values = c("FALSE" = "black", "TRUE" = "white")) +
  scale_x_discrete(labels = c("0\n(n = 20)", "1\n(do 30)", "2\n(do 40)", "3\n(do 50)")) +
  labs(title = "Dwie wątpliwe praktyki razem: fałszywe alarmy się mnożą",
       x = "Ile razy dobierano 10 osób do grupy po nieistotnym wyniku",
       y = "Liczba sprawdzanych zmiennych zależnych") +
  motyw + theme(legend.key.width = unit(1.6, "cm"))
p1   # zapis: ggsave("qrp-falszywe-alarmy-laczenie-praktyk.svg", p1, width = 10, height = 5.6)
Wynik w R
       dobierania
zmienne    0    1    2    3
      1  5.1  7.8 10.1 11.5
      2  9.5 14.1 17.8 20.4
      3 13.3 19.6 24.1 27.3
      4 16.1 23.5 29.3 33.0
[1] 0.7
Bibliografia oprogramowania
Wyniki i rysunek pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety base i stats; rysunek – ggplot2, zapis pakietem svglite). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Jak się zabezpieczyć w pracy
Na co uważać
- Zapisz plan przed danymi. Prerejestracja oddziela analizy potwierdzające od eksploracyjnych.
- Ustal regułę zakończenia zbierania danych z góry, np. na podstawie analizy mocy.
- Analiza eksploracyjna nie jest wadą, o ile jest tak nazwana.
- Ujawniaj wszystkie wykluczenia i ich powód, także w aneksie.
Najczęstsze pytania
Czym wątpliwe praktyki badawcze różnią się od fałszowania danych?
Fabrykowanie i fałszowanie to tworzenie lub zmienianie danych i wyników – jawna nierzetelność naukowa. QRP działają na prawdziwych danych, ale przez selektywne decyzje i raportowanie dają obraz bardziej przekonujący, niż pozwalają dane.
Czy usunięcie obserwacji odstających to zawsze wątpliwa praktyka?
Nie. Problemem jest decyzja podjęta po obejrzeniu wyników i nieujawniona w raporcie. Kryterium wykluczeń zapisane z góry i opisane w pracy, najlepiej z analizą z obserwacjami i bez nich, jest uczciwą praktyką.
Czy w pracy dyplomowej mogę dopisać hipotezę po analizie?
Możesz opisać nieoczekiwany wynik, ale jako odkrycie eksploracyjne, a nie hipotezę postawioną przed badaniem. Takie wyniki warto przedstawić w osobnym podrozdziale i potraktować jako propozycję do sprawdzenia w kolejnym badaniu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Plan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikCzy można usunąć obserwacje odstające?
Kiedy usunięcie wyniku jest uzasadnione, a kiedy staje się manipulacją: tabela decyzji, analiza wrażliwości w R i gotowy opis do pracy.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fanelli, D. (2009). How many scientists fabricate and falsify research? A systematic review and meta-analysis of survey data. PLoS ONE, 4(5), Article e5738. https://doi.org/10.1371/journal.pone.0005738 ● Otwarty dostęp
- John, L. K., Loewenstein, G., & Prelec, D. (2012). Measuring the prevalence of questionable research practices with incentives for truth telling. Psychological Science, 23(5), 524–532. https://doi.org/10.1177/0956797611430953
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
Cytowania BibTeX
@article{fanelli2009how, author={Fanelli, Daniele}, title={{How many scientists fabricate and falsify research? A systematic review and meta-analysis of survey data}}, journal={PLoS ONE}, year={2009}, volume={4}, number={5}, eid={e5738}, doi={10.1371/journal.pone.0005738}}@article{john2012measuring, author={John, Leslie K. and Loewenstein, George and Prelec, Drazen}, title={{Measuring the prevalence of questionable research practices with incentives for truth telling}}, journal={Psychological Science}, year={2012}, volume={23}, number={5}, pages={524--532}, doi={10.1177/0956797611430953}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}