Co to jest sekwencyjna analiza metaanalizy?
Sekwencyjna analiza metaanalizy (trial sequential analysis, TSA) traktuje każdą aktualizację metaanalizy jak analizę pośrednią w pojedynczym badaniu klinicznym. Gdy po każdym nowym badaniu testuje się efekt na poziomie .05, rośnie ryzyko błędu I rodzaju – to odmiana problemu wielokrotnych porównań. Wetterslev i in. (2008) pokazali na sześciu metaanalizach neonatologicznych, że skumulowana statystyka z często wcześnie przekraczała próg p = .05, choć w części z nich nigdy nie przekroczyła granic monitorowania.
Wymagana wielkość informacji
Punktem odniesienia jest wymagana wielkość informacji (required information size, RIS): co najmniej tylu uczestników, ilu potrzebowałoby jedno badanie o odpowiedniej mocy dla założonego, klinicznie istotnego efektu, ryzyka w grupie kontrolnej, α i β. Przy heterogeniczności RIS się powiększa, np. według miary zróżnicowania D² (Wetterslev i in., 2017). Stosunek uzyskanej wielkości informacji (AIS) do RIS wyznacza oś czasu informacji t.
Granice monitorowania
Granice wyznacza funkcja wydatkowania alfa Lana i DeMetsa (1983), zwykle w wersji O'Briena–Fleminga: na początku są bardzo wysokie, a przy t = 1 spadają do około 1.96. Dopiero przekroczenie granicy przed osiągnięciem RIS jest mocnym dowodem efektu; samo przekroczenie 1.96 nim nie jest. TSA podaje też przedziały ufności skorygowane o sekwencyjność.
Przykład
Osiem symulowanych badań (1820 osób, prawdziwe RR = 0.80) ocenia się względem RIS = 2897 osób, wyliczonej dla RR = 0.80, ryzyka 20% w grupie kontrolnej, α = .05 i mocy 80%. Po ósmym badaniu naiwna metaanaliza daje RR = 0.81, 95% CI [0.66, 0.99], z = −2.09, p = .037. Zebrano jednak tylko 63% RIS, granica wynosi tu 2.65, a przedział skorygowany to [0.62, 1.06]. Dowód nie jest więc jeszcze rozstrzygający – co nie znaczy, że efektu nie ma.
Na rysunku
Rysunek 1 pokazuje to samo osiem badań co przykład, ale jako przebieg w czasie: po każdym nowym badaniu metaanaliza dostaje nowy punkt.
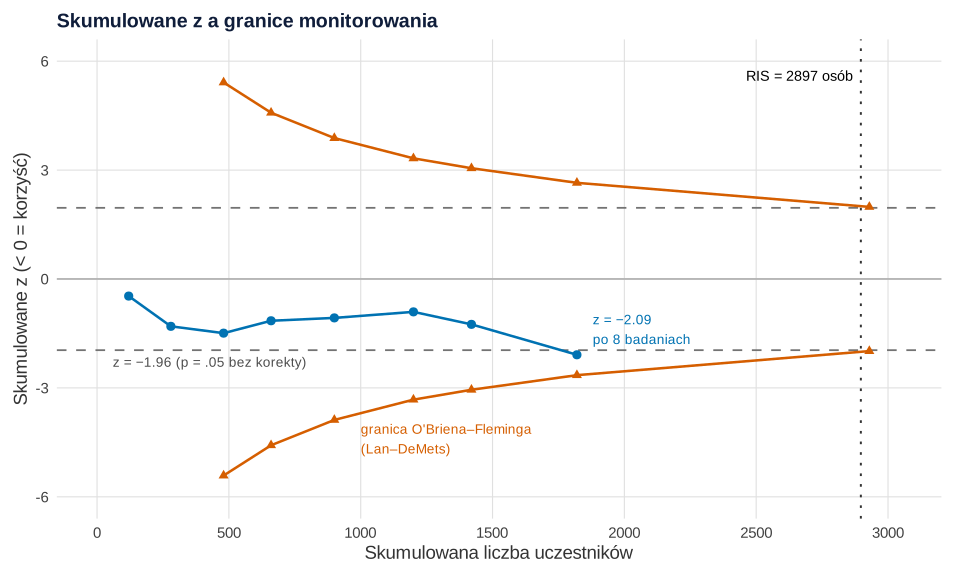
set.seed(7292)).Co widać. Niebieska ścieżka to skumulowane z po każdym badaniu. Długo krąży między −0.9 a −1.5, a po ósmym badaniu (1820 osób, 62.8% RIS) spada do −2.09 i przekracza zwykły próg −1.96. Pomarańczowe granice są na początku bardzo wysokie (±5.41 po trzecim badaniu) i zbiegają się w miarę napływu informacji: przy 1820 osobach wynoszą ±2.65, a przy pełnej informacji ±1.99. Ścieżka leży więc między progiem bez korekty a granicą TSA – to obraz wniosku „za wcześnie, by rozstrzygać”. Przy dwóch pierwszych badaniach granica ma wartość umowną 20 i leży poza wykresem.
Na co uważać. Położenie granic i pionowej linii wynika z założeń: RR = 0.80, ryzyka 20% w grupie kontrolnej, α = .05 i mocy 80%. Przy skromniejszym założonym efekcie RIS byłaby większa, a granice łagodniej by opadały. Odcinki między trójkątami tylko łączą punkty: granicę wyznacza się w chwilach kolejnych analiz. Ostatni trójkąt leży przy 2929 osobach, bo plan sekwencyjny nieco powiększa RIS. Wykres nie pokazuje wielkości efektu ani heterogeniczności (to model efektu stałego), nie ma też granic daremności. Ta sama ścieżka bez granic to skumulowana metaanaliza; jak wygląda metaanaliza na innych wykresach, pokazuje wpis metaanaliza w obrazkach.
Podpis do pracy:
Kod rysunku odtwarza dane z przykładu (to samo ziarno 7292) i wypisuje tabelę punktów ścieżki i granic. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Wykres TSA: skumulowane z, granice O'Briena–Fleminga i wymagana wielkość informacji (RIS)
library(RTSA)
library(ggplot2)

# Paleta Okabe–Ito i prosty motyw
kol <- c(z = "#0072B2", granica = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Te same dane co w przykładzie: 8 badań, ryzyko 20% w grupie kontrolnej, prawdziwe RR = 0.80
set.seed(7292)
k <- 8; n <- c(60, 80, 100, 90, 120, 150, 110, 200)      # osoby na ramię w 8 badaniach
d <- data.frame(study = paste0("B", 1:k), order = 1:k, nI = n, nC = n)
d$eC <- rbinom(k, n, 0.20); d$eI <- rbinom(k, n, 0.20 * 0.80)
fit <- RTSA(type = "analysis", data = d, outcome = "RR", mc = 0.8, pC = 0.2,
            side = 2, alpha = 0.05, beta = 0.2, es_alpha = "esOF", fixed = TRUE)
RIS <- fit$results$RIS
r <- fit$results$results_df

# Oś pozioma: skumulowana liczba uczestników; ostatni wiersz tabeli RTSA to granica przy pełnej RIS
tab <- data.frame(badanie = c(paste0("B", 1:k), "RIS"),
                  uczestnicy = c(cumsum(2 * n), r$sma_timing[k + 1] * RIS),
                  z = r$z_fixed, granica = r$upper)
print(transform(tab, uczestnicy = round(uczestnicy), z = round(z, 2), granica = round(granica, 2)), row.names = FALSE)
cat("Odsetek RIS po 8 badaniach:", round(100 * sum(2 * n) / RIS, 1), "%\n")

# Granice równe 20 to wartość umowna przy bardzo małej informacji – rysujemy je od trzeciego badania
gr <- tab[tab$granica < 20, ]
p <- ggplot() +
  geom_hline(yintercept = c(-1.96, 1.96), linetype = "dashed", colour = "grey45") +
  geom_hline(yintercept = 0, colour = "grey70") +
  geom_vline(xintercept = RIS, linetype = "dotted", colour = "grey20", linewidth = 0.7) +
  geom_line(data = gr, aes(uczestnicy, granica), colour = kol[["granica"]], linewidth = 0.9) +
  geom_line(data = gr, aes(uczestnicy, -granica), colour = kol[["granica"]], linewidth = 0.9) +
  geom_point(data = gr, aes(uczestnicy, -granica), colour = kol[["granica"]], shape = 17, size = 2.2) +
  geom_point(data = gr, aes(uczestnicy, granica), colour = kol[["granica"]], shape = 17, size = 2.2) +
  geom_line(data = tab[1:k, ], aes(uczestnicy, z), colour = kol[["z"]], linewidth = 0.9) +
  geom_point(data = tab[1:k, ], aes(uczestnicy, z), colour = kol[["z"]], shape = 16, size = 2.8) +
  annotate("text", x = RIS - 30, y = 5.6, label = paste0("RIS = ", round(RIS), " osób"), hjust = 1, size = 3.8) +
  annotate("text", x = 60, y = -2.15, label = "z = −1.96 (p = .05 bez korekty)", hjust = 0, vjust = 1,
           size = 3.6, colour = "grey30") +
  annotate("text", x = 1000, y = -4.4, label = "granica O'Briena–Fleminga\n(Lan–DeMets)", hjust = 0,
           size = 3.6, colour = kol[["granica"]]) +
  annotate("text", x = sum(2 * n) + 60, y = tab$z[k] + 0.3, label = sub("-", "\u2212", sprintf("z = %.2f\npo 8 badaniach", tab$z[k])),
           hjust = 0, vjust = 0, size = 3.6, colour = kol[["z"]]) +
  scale_x_continuous(breaks = seq(0, 3000, 500), limits = c(0, 3050)) +
  coord_cartesian(ylim = c(-6, 6)) +
  labs(title = "Skumulowane z a granice monitorowania", x = "Skumulowana liczba uczestników",
       y = "Skumulowane z (< 0 = korzyść)") +
  motyw
p
Wynik w R
 badanie uczestnicy     z granica
      B1        120 -0.47   20.00
      B2        280 -1.30   20.00
      B3        480 -1.49    5.41
      B4        660 -1.15    4.58
      B5        900 -1.07    3.88
      B6       1200 -0.91    3.32
      B7       1420 -1.25    3.05
      B8       1820 -2.09    2.65
     RIS       2929    NA    1.99
Odsetek RIS po 8 badaniach: 62.8 %
Jak opisać w pracy
Na co uważać
- Założenia z góry. RIS zależy od przyjętego efektu i ryzyka bazowego – ustal je w protokole przeglądu, nie po obejrzeniu wyników.
- Heterogeniczność. Model efektu stałego zaniża RIS, gdy badania wyraźnie się różnią; wtedy użyj korekty D² lub τ².
- Jakość dowodów. TSA nie koryguje błędu publikacji ani ryzyka błędu w samych badaniach.
Cały przebieg metaanalizy opisuje wpis Metaanaliza krok po kroku.
Sekwencyjna analiza metaanalizy w R
Kod symuluje osiem badań z wynikiem binarnym, uruchamia TSA funkcją RTSA::RTSA() z granicami O'Briena–Fleminga w wersji Lana–DeMetsa, a skumulowane z sprawdza naiwną metaanalizą skumulowaną z metafor. Liczby w tekście pochodzą z tego kodu.
RIS, granice monitorowania i skumulowane z
R
set.seed(7292)
library(RTSA)
k <- 8; n <- c(60, 80, 100, 90, 120, 150, 110, 200)      # osoby na ramię w 8 badaniach
d <- data.frame(study = paste0("B", 1:k), order = 1:k, nI = n, nC = n)
d$eC <- rbinom(k, n, 0.20); d$eI <- rbinom(k, n, 0.20 * 0.80)   # prawdziwe RR = 0.80
fit <- RTSA(type = "analysis", data = d, outcome = "RR", mc = 0.8, pC = 0.2,
            side = 2, alpha = 0.05, beta = 0.2, es_alpha = "esOF", fixed = TRUE)
c(RIS = fit$results$RIS, RIS_sekw = fit$results$SMA_RIS, AIS = fit$results$AIS)
r <- fit$results$results_df
round(data.frame(t = r$sma_timing, granica = r$upper, z = r$z_fixed,
                 p_naiwne = r$pvalues_fixed, RR = r$outcome_fixed,
                 TSA_dolna = r$TSAadjCIfixed_lower, TSA_gorna = r$TSAadjCIfixed_upper), 3)
library(metafor)                                          # kontrola: naiwna metaanaliza skumulowana (M-H)
cm <- cumul(rma.mh(measure = "RR", ai = eI, n1i = nI, ci = eC, n2i = nC, data = d))
round(data.frame(z = cm$zval, p = cm$pval, RR = exp(cm$estimate),
                 dolna = exp(cm$ci.lb), gorna = exp(cm$ci.ub)), 3)
Wynik w R
     RIS RIS_sekw      AIS
2897.000 2929.139 1820.000
      t granica      z p_naiwne    RR TSA_dolna TSA_gorna
1 0.041  20.000 -0.471    0.638 0.833     0.000  1926.856
2 0.097  20.000 -1.304    0.192 0.692     0.002   194.605
3 0.166   5.414 -1.492    0.136 0.727     0.229     2.310
4 0.228   4.580 -1.150    0.250 0.817     0.365     1.829
5 0.311   3.882 -1.072    0.284 0.852     0.477     1.523
6 0.414   3.324 -0.905    0.365 0.894     0.592     1.350
7 0.490   3.051 -1.250    0.211 0.867     0.611     1.229
8 0.628   2.649 -2.088    0.037 0.808     0.616     1.059
9 1.011   1.986     NA       NA    NA        NA        NA
       z     p    RR dolna gorna
1 -0.471 0.638 0.833 0.390 1.780
2 -1.304 0.192 0.692 0.398 1.203
3 -1.492 0.136 0.727 0.479 1.105
4 -1.150 0.250 0.817 0.578 1.153
5 -1.072 0.284 0.852 0.635 1.142
6 -0.905 0.365 0.894 0.701 1.140
7 -1.250 0.211 0.867 0.692 1.085
8 -2.088 0.037 0.808 0.661 0.987
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety RTSA i metafor). Rysunek 1 wykonano w pakiecie ggplot2, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- RTSA (wersja 0.2.2): Lyngholm Soerensen, A., & Harboe Olsen, M. (2023). RTSA: 'Trial Sequential Analysis' for error control and inference in sequential meta-analyses (R package version 0.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.RTSA
- metafor (wersja 5.2.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym jest wymagana wielkość informacji w TSA?
To liczba uczestników, której potrzebowałoby jedno badanie o założonej mocy do wykrycia klinicznie istotnego efektu; przy heterogeniczności zwiększa się ją, np. według D². W przykładzie: 2897 osób dla RR = 0.80, ryzyka 20% i mocy 80%.
Co oznacza, że krzywa z przekroczyła 1.96, ale nie granicę TSA?
Naiwna metaanaliza jest istotna, ale przy tej ilości informacji wynik może być przypadkowy. Dowód nie jest rozstrzygający i potrzeba dalszych badań; nie oznacza to braku efektu.
Czy TSA zastępuje ocenę jakości dowodów?
Nie. TSA kontroluje błąd wynikający z wielokrotnego testowania i niedostatecznej liczebności, ale nie koryguje błędu publikacji ani ryzyka błędu w pojedynczych badaniach.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Lan, K. K. G., & DeMets, D. L. (1983). Discrete sequential boundaries for clinical trials. Biometrika, 70(3), 659–663. https://doi.org/10.1093/biomet/70.3.659
- Wetterslev, J., Jakobsen, J. C., & Gluud, C. (2017). Trial Sequential Analysis in systematic reviews with meta-analysis. BMC Medical Research Methodology, 17(1), Article 39. https://doi.org/10.1186/s12874-017-0315-7 ● Otwarty dostęp
- Wetterslev, J., Thorlund, K., Brok, J., & Gluud, C. (2008). Trial sequential analysis may establish when firm evidence is reached in cumulative meta-analysis. Journal of Clinical Epidemiology, 61(1), 64–75. https://doi.org/10.1016/j.jclinepi.2007.03.013
Cytowania BibTeX
@article{lan1983discrete, author={Lan, K. K. Gordon and DeMets, David L.}, title={{Discrete sequential boundaries for clinical trials}}, journal={Biometrika}, year={1983}, volume={70}, number={3}, pages={659--663}, doi={10.1093/biomet/70.3.659}}@article{wetterslev2017trial, author={Wetterslev, Jørn and Jakobsen, Janus Christian and Gluud, Christian}, title={{Trial Sequential Analysis in systematic reviews with meta-analysis}}, journal={BMC Medical Research Methodology}, year={2017}, volume={17}, number={1}, eid={39}, doi={10.1186/s12874-017-0315-7}}@article{wetterslev2008trial, author={Wetterslev, Jørn and Thorlund, Kristian and Brok, Jesper and Gluud, Christian}, title={{Trial sequential analysis may establish when firm evidence is reached in cumulative meta-analysis}}, journal={Journal of Clinical Epidemiology}, year={2008}, volume={61}, number={1}, pages={64--75}, doi={10.1016/j.jclinepi.2007.03.013}}