Co to jest układ regresji pozornie niezależnych?
Układ regresji pozornie niezależnych (ang. seemingly unrelated regressions, SUR) to kilka równań regresji liniowej z różnymi zmiennymi zależnymi, które wyglądają na niezależne, ale ich składniki losowe są skorelowane – np. wydatki gospodarstw na żywność i na mieszkanie, wyniki z dwóch przedmiotów albo inwestycje kilku firm w tych samych latach. Zellner (1962) zaproponował estymację całego układu uogólnioną metodą najmniejszych kwadratów (GLS): najpierw MNK dla każdego równania, potem z reszt macierz kowariancji błędów między równaniami i ponowna estymacja wszystkich równań naraz.
Według Zellnera taki estymator jest co najmniej asymptotycznie efektywniejszy niż MNK równanie po równaniu, a zysk jest największy, gdy predyktory w różnych równaniach są słabo skorelowane, a błędy – silnie. SUR nie usuwa obciążenia: przy zmiennych endogenicznych potrzebne są metody instrumentalne, np. 2SLS lub 3SLS. W R układ estymuje pakiet systemfit (Henningsen i Hamann, 2007).
Przykład
W 120 symulowanych obserwacjach wydatki na żywność zależały od x1, a na mieszkanie od x2; korelacja reszt między równaniami wyniosła 0.66. SUR zmniejszył błędy standardowe nachyleń z 0.093 do 0.070 i z 0.097 do 0.073, przy oszacowaniach 0.472 i 0.376 (MNK: 0.560 i 0.452). Gdy oba równania miały te same predyktory, SUR i MNK dały identyczne współczynniki. Test Walda równości nachyleń w obu równaniach: F(1, 236) = 0.90, p = .345.
Na rysunku
Panel A używa danych z przykładu (set.seed(691)). Panel B to symulacja z tym samym modelem i n = 120. Dla sześciu wartości korelacji błędów ρ powtórzono badanie 500 razy (ponownie set.seed(691)) i policzono odchylenie standardowe oszacowań nachylenia x1 w MNK i w SUR. Wartości ρ wybrano ręcznie tak, żeby objąć zakres od braku korelacji do bardzo silnej.
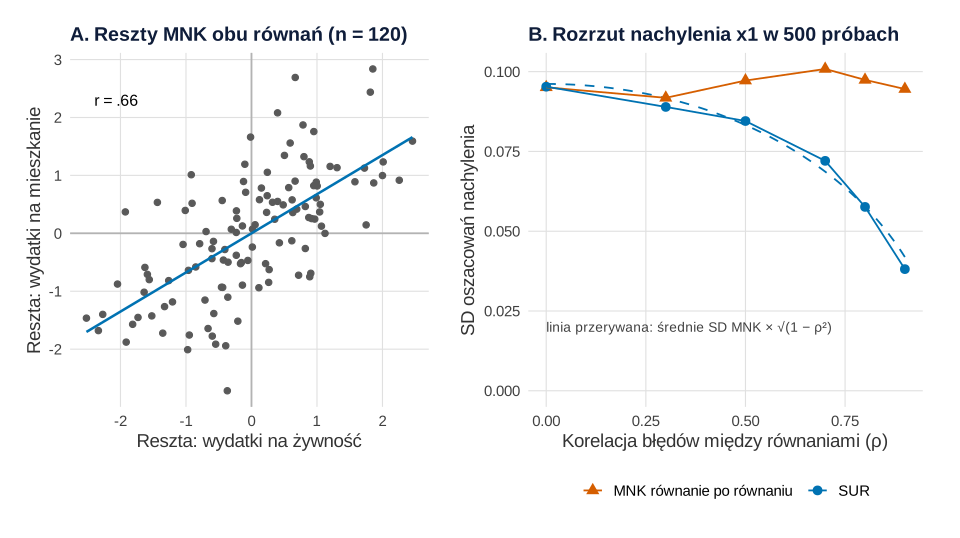
Co widać. W panelu A reszty obu równań układają się wzdłuż rosnącej prostej (r = .66). Gospodarstwo, które wydaje „więcej niż przewiduje model” na żywność, zwykle wydaje też więcej na mieszkanie. Tę informację MNK równanie po równaniu pomija, a SUR wykorzystuje. Panel B pokazuje, ile to daje. Przy ρ = 0 obie metody mają ten sam rozrzut (SD 0.095). Przy ρ = 0.7 SD oszacowań SUR wynosi 0.072 wobec 0.101 w MNK (iloraz 0.714). Przy ρ = 0.9 iloraz spada do 0.403. Punkty leżą blisko krzywej √(1 − ρ²), która przybliża ten iloraz, gdy predyktory obu równań są nieskorelowane. Względny błąd Monte Carlo każdego SD wynosi około 3.2%.
Na co uważać. Zysk dotyczy precyzji, a nie trafności: oba estymatory są tu nieobciążone. Gdyby w obu równaniach były te same predyktory, krzywe SUR i MNK pokryłyby się przy każdym ρ (zob. „Na co uważać” niżej). Przy słabej korelacji (ρ = 0.3) zysk jest niewielki (iloraz 0.969), a w małej próbie może zniknąć, bo kowariancję błędów trzeba oszacować. Panel A pokazuje reszty, a nie błędy. Korelację reszt warto więc podać w pracy jako uzasadnienie, ale nie traktować jej jako dokładnej wartości ρ.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z opisu (symulacja trwa kilkanaście sekund). Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p z motywem serwisu. Dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. SUR: korelacja reszt dwóch równań (A) i zysk precyzji nachylenia w zależności od tej korelacji (B)
library(ggplot2)
library(patchwork)
suppressPackageStartupMessages(library(systemfit))

# Paleta Okabe–Ito i prosty motyw; metodę rozróżnia też kształt punktu i typ linii
kol <- c("MNK równanie po równaniu" = "#D55E00", "SUR" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# A. Dane z przykładu: reszty MNK z równania żywności i mieszkania
set.seed(691)
n <- 120
d <- data.frame(x1 = rnorm(n), x2 = rnorm(n))
e <- MASS::mvrnorm(n, mu = c(0, 0), Sigma = matrix(c(1, 0.7, 0.7, 1), 2))
d$y1 <- 1 + 0.5 * d$x1 + e[, 1]
d$y2 <- 2 + 0.4 * d$x2 + e[, 2]
rown <- list(zywnosc = y1 ~ x1, mieszkanie = y2 ~ x2)
m_ols <- systemfit(rown, method = "OLS", data = d)
res <- as.data.frame(residuals(m_ols))
r_res <- cor(res$zywnosc, res$mieszkanie)
round(c(r_reszt = r_res), 3)
pA <- ggplot(res, aes(zywnosc, mieszkanie)) +
  geom_hline(yintercept = 0, colour = "grey70") + geom_vline(xintercept = 0, colour = "grey70") +
  geom_point(colour = "grey35", size = 1.8) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "#0072B2", linewidth = 0.9) +
  annotate("text", x = -2.4, y = 2.3, hjust = 0, size = 4.2, label = sprintf("r = %s", sub("^0", "", sprintf("%.2f", r_res)))) +
  labs(title = "A. Reszty MNK obu równań (n = 120)", x = "Reszta: wydatki na żywność", y = "Reszta: wydatki na mieszkanie") +
  motyw

# B. Symulacja: rozrzut oszacowań nachylenia x1 przy różnej korelacji błędów (500 powtórzeń na wartość)
set.seed(691)
R <- 500
rho_siatka <- c(0, 0.3, 0.5, 0.7, 0.8, 0.9)
sym <- do.call(rbind, lapply(rho_siatka, function(rho) {
  b <- t(replicate(R, {
    ds <- data.frame(x1 = rnorm(n), x2 = rnorm(n))
    es <- MASS::mvrnorm(n, mu = c(0, 0), Sigma = matrix(c(1, rho, rho, 1), 2))
    ds$y1 <- 1 + 0.5 * ds$x1 + es[, 1]; ds$y2 <- 2 + 0.4 * ds$x2 + es[, 2]
    c(MNK = coef(lm(y1 ~ x1, data = ds))[["x1"]],
      SUR = coef(systemfit(rown, method = "SUR", data = ds))[["zywnosc_x1"]])
  }))
  data.frame(rho = rho, SD_MNK = sd(b[, "MNK"]), SD_SUR = sd(b[, "SUR"]))
}))
sym$iloraz <- sym$SD_SUR / sym$SD_MNK
sym$teoria <- sqrt(1 - sym$rho^2)                    # przybliżenie dla nieskorelowanych x1 i x2
print(round(sym, 3), row.names = FALSE)
c(blad_MC_SD_wzgledny = round(1 / sqrt(2 * (R - 1)), 3))   # względny błąd MC odchylenia standardowego

dl <- rbind(data.frame(rho = sym$rho, metoda = names(kol)[1], sd = sym$SD_MNK),
            data.frame(rho = sym$rho, metoda = names(kol)[2], sd = sym$SD_SUR))
teo <- data.frame(rho = seq(0, 0.9, 0.01))
teo$sd <- mean(sym$SD_MNK) * sqrt(1 - teo$rho^2)
pB <- ggplot(dl, aes(rho, sd, colour = metoda, shape = metoda)) +
  geom_line(data = teo, aes(rho, sd), inherit.aes = FALSE, colour = "#0072B2", linetype = "dashed") +
  geom_point(size = 3) +
  geom_line(aes(linetype = metoda)) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid"), guide = "none") +
  annotate("text", x = 0, y = 0.02, hjust = 0, size = 3.6, colour = "grey25",
           label = "linia przerywana: średnie SD MNK × √(1 − ρ²)") +
  scale_y_continuous(limits = c(0, NA)) +
  labs(title = "B. Rozrzut nachylenia x1 w 500 próbach",
       x = "Korelacja błędów między równaniami (ρ)", y = "SD oszacowań nachylenia") +
  motyw

p <- pA + pB + plot_layout(widths = c(1, 1.1))
p
Wynik w R
r_reszt
   0.66
 rho SD_MNK SD_SUR iloraz teoria
 0.0  0.095  0.095  1.002  1.000
 0.3  0.092  0.089  0.969  0.954
 0.5  0.097  0.085  0.870  0.866
 0.7  0.101  0.072  0.714  0.714
 0.8  0.097  0.058  0.591  0.600
 0.9  0.095  0.038  0.403  0.436
blad_MC_SD_wzgledny
              0.032
Jak opisać w pracy
Na co uważać
- Te same predyktory w każdym równaniu – SUR daje wtedy dokładnie wyniki MNK; zysk wymaga różnych predyktorów.
- Słaba korelacja błędów to niewielki zysk, a przy małej próbie szacowanie kowariancji może go zjeść.
- Błąd w jednym równaniu (np. pominięta zmienna) może przenieść się na pozostałe, bo są szacowane razem.
- To nie MANOVA: MANOVA testuje wspólny efekt tych samych czynników na kilka wyników, SUR szacuje odrębne równania.
Układ SUR w R
Kod porównuje estymację MNK równanie po równaniu i SUR funkcją systemfit(), pokazuje korelację reszt, przypadek identycznych predyktorów i test równości współczynników między równaniami. Liczby w tekście pochodzą z tego kodu.
MNK i SUR dla dwóch równań ze skorelowanymi błędami
R
set.seed(691)                                        # dane symulowane: dwa równania ze skorelowanymi błędami
n <- 120
d <- data.frame(x1 = rnorm(n), x2 = rnorm(n))
e <- MASS::mvrnorm(n, mu = c(0, 0), Sigma = matrix(c(1, 0.7, 0.7, 1), 2))
d$y1 <- 1 + 0.5 * d$x1 + e[, 1]                      # np. wydatki na żywność
d$y2 <- 2 + 0.4 * d$x2 + e[, 2]                      # np. wydatki na mieszkanie
suppressPackageStartupMessages(library(systemfit))
rown <- list(zywnosc = y1 ~ x1, mieszkanie = y2 ~ x2)
m_ols <- systemfit(rown, method = "OLS", data = d)   # każde równanie osobno
m_sur <- systemfit(rown, method = "SUR", data = d)   # estymator Zellnera (FGLS)
round(cbind(b_OLS = coef(m_ols), SE_OLS = sqrt(diag(vcov(m_ols))),
            b_SUR = coef(m_sur), SE_SUR = sqrt(diag(vcov(m_sur)))), 3)
round(cor(residuals(m_ols)), 3)                      # korelacja reszt między równaniami
m_ten_sam <- systemfit(list(y1 ~ x1 + x2, y2 ~ x1 + x2), method = "SUR", data = d)
m_ols2 <- systemfit(list(y1 ~ x1 + x2, y2 ~ x1 + x2), method = "OLS", data = d)
all.equal(coef(m_ten_sam), coef(m_ols2))             # te same predyktory: SUR = OLS
linearHypothesis(m_sur, "zywnosc_x1 - mieszkanie_x2 = 0")   # test równości współczynników między równaniami
Wynik w R
                       b_OLS SE_OLS b_SUR SE_SUR
zywnosc_(Intercept)    1.031  0.097 1.026  0.097
zywnosc_x1             0.560  0.093 0.472  0.070
mieszkanie_(Intercept) 2.066  0.099 2.065  0.099
mieszkanie_x2          0.452  0.097 0.376  0.073
           zywnosc mieszkanie
zywnosc       1.00       0.66
mieszkanie    0.66       1.00
[1] TRUE
Linear hypothesis test (Theil's F test)

Hypothesis:
zywnosc_x1 - mieszkanie_x2 = 0

Model 1: restricted model
Model 2: m_sur

  Res.Df Df      F Pr(>F)
1    237
2    236  1 0.8957 0.3449
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety systemfit 1.1.30 i MASS 7.3-65). Rysunek 1 wykonano pakietami ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- systemfit (wersja 1.1.30): Henningsen, A., & Hamann, J. D. (2007). systemfit: A package for estimating systems of simultaneous equations in R. Journal of Statistical Software, 23(4), 1–40. https://doi.org/10.18637/jss.v023.i04
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Kiedy SUR daje lepsze wyniki niż osobne regresje?
Gdy błędy równań są wyraźnie skorelowane, a równania mają różne predyktory. Im słabiej skorelowane są predyktory między równaniami i im silniej skorelowane błędy, tym większy zysk w precyzji. Przy identycznych predyktorach SUR daje dokładnie wyniki MNK.
Czy SUR rozwiązuje problem endogeniczności?
Nie. SUR poprawia efektywność, ale zakłada, że predyktory nie są skorelowane z błędami. Przy zmiennych endogenicznych potrzebne są zmienne instrumentalne, np. 2SLS dla pojedynczego równania lub 3SLS dla układu.
Jak oszacować SUR w R?
Pakietem systemfit: zdefiniuj listę równań, np. list(r1 = y1 ~ x1, r2 = y2 ~ x2), i wywołaj systemfit(lista, method = "SUR", data = d). Funkcja linearHypothesis() pozwala testować ograniczenia łączące współczynniki różnych równań.
Powiązane hasła
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Henningsen, A., & Hamann, J. D. (2007). systemfit: A package for estimating systems of simultaneous equations in R. Journal of Statistical Software, 23(4), 1–40. https://doi.org/10.18637/jss.v023.i04 ● Otwarty dostęp
- Zellner, A. (1962). An efficient method of estimating seemingly unrelated regressions and tests for aggregation bias. Journal of the American Statistical Association, 57(298), 348–368. https://doi.org/10.1080/01621459.1962.10480664
Cytowania BibTeX
@article{henningsen2007systemfit, author={Henningsen, Arne and Hamann, Jeff D.}, title={{systemfit: A package for estimating systems of simultaneous equations in R}}, journal={Journal of Statistical Software}, year={2007}, volume={23}, number={4}, pages={1--40}, doi={10.18637/jss.v023.i04}}@article{zellner1962efficient, author={Zellner, Arnold}, title={{An efficient method of estimating seemingly unrelated regressions and tests for aggregation bias}}, journal={Journal of the American Statistical Association}, year={1962}, volume={57}, number={298}, pages={348--368}, doi={10.1080/01621459.1962.10480664}}