Co to jest Q Yule'a?
Q Yule'a (ang. Yule's Q) to miara związku dwóch zmiennych dychotomicznych zapisanych w czteropolowej tabeli krzyżowej 2×2. Nazwa pochodzi od George'a Udny Yule'a, który w obszernej pracy z 1912 roku porównywał sposoby mierzenia związku dwóch cech, ilustrując je m.in. danymi o szczepieniu i zgonach w epidemii ospy (Yule, 1912).
Wzór i związek z ilorazem szans
Dla komórek a, b (pierwszy wiersz) oraz c, d (drugi wiersz):
Q = (ad − bc)/(ad + bc) = (OR − 1)/(OR + 1).
Q to więc rosnące przekształcenie ilorazu szans (OR) na skalę od −1 do 1: OR = 1 daje 0, OR → ∞ daje 1, a OR → 0 daje −1. Q dziedziczy po OR niezależność od rozkładów brzegowych. Inaczej jest ze współczynnikiem phi: Warrens (2008) pokazuje, że phi i kappa Cohena należą do rodziny współczynników zależnych od rozkładów brzegowych. Dla tabeli 2×2 Q równa się gammie Goodmana–Kruskala.
Przykład
160 studentów (dane symulowane): mentor (tak/nie) i obrona w terminie. Z mentorem w terminie obroniło się 56 z 70 osób, bez mentora – 46 z 90. OR = (56 · 44)/(14 · 46) = 3.83, 95% CI [1.87, 7.84], więc Q = 2.83/4.83 = .59, 95% CI [.30, .77]. Phi dla tych samych danych wyniosło .30.
Na rysunku
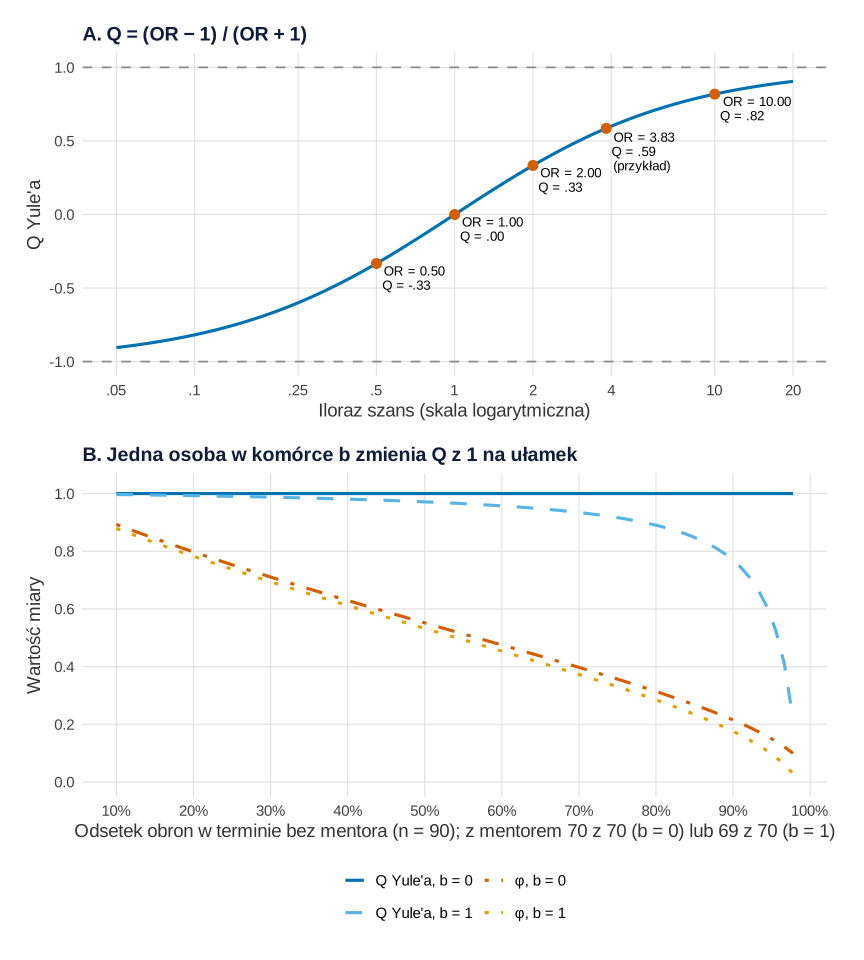
Co widać. Panel A pokazuje, że Q to ten sam iloraz szans zapisany na innej skali. OR = 1 daje Q = 0, OR = 2 – .33, a OR = 3.83 z przykładu – .59. Krzywa jest symetryczna: OR = 0.5 daje −.33, czyli ten sam związek w drugą stronę. Przy dużych OR krzywa się spłaszcza – różnica między OR = 10 (Q = .82) a OR = 20 (Q = .90) jest na tej skali niewielka. Panel B używa liczebności z przykładu: 70 osób z mentorem i 90 bez. Jeśli wszystkie 70 osób z mentorem obroniło się w terminie (komórka b pusta), Q wynosi 1 bez względu na to, czy bez mentora w terminie obroniło się 10%, czy 96% osób. φ w tym samym zakresie spada od .89 do .14. Wystarczy jedna osoba w komórce b, by przy 96% obron bez mentora Q spadło z 1 do .52.
Na co uważać. Q = 1 przy pustej komórce oznacza tylko, że jeden z czterech typów osób nie wystąpił w próbie – nie, że związek jest „doskonały” w potocznym sensie. Przy małych liczebnościach to często przypadek, dlatego obok Q podawaj tabelę i odsetki w grupach. Wykres nie pokazuje niepewności: przy pustej komórce zwykły (Walda) przedział ufności dla OR nie istnieje. Q, tak jak OR, nie zależy od rozkładów brzegowych, a φ – tak; dlatego krzywe φ w panelu B zależą od tego, ile osób obroniło się w terminie bez mentora (por. maksimum φ w haśle współczynnik phi). Inne wykresy tabel 2 × 2 i większych są we wpisie tabela krzyżowa na wykresie.
Podpis do pracy:
Kod rysunku nie losuje danych – liczy Q i φ z tabel ułożonych na liczebnościach z przykładu. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Q Yule'a jako przekształcenie OR (A) i Q przy pustej komórce (B)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))
bz <- function(x) sub("^(-?)0", "\\1", sprintf("%.2f", x))   # zapis bez zera wiodącego

Q   <- function(a, b, c, d) (a * d - b * c) / (a * d + b * c)
phi <- function(a, b, c, d) (a * d - b * c) / sqrt((a + b) * (c + d) * (a + c) * (b + d))

# Panel A: Q = (OR − 1) / (OR + 1) na logarytmicznej osi OR
krzywa <- data.frame(OR = exp(seq(log(0.05), log(20), length.out = 400)))
krzywa$Q <- (krzywa$OR - 1) / (krzywa$OR + 1)
pkt <- data.frame(OR = c(0.5, 1, 2, 56 * 44 / (14 * 46), 10))
pkt$Q <- (pkt$OR - 1) / (pkt$OR + 1)
pkt$et <- sprintf("OR = %s\nQ = %s", formatC(pkt$OR, format = "f", digits = 2), bz(pkt$Q))
pkt$et[4] <- paste0(pkt$et[4], "\n(przykład)")
round(pkt[, 1:2], 3)
round(c(Q_przy_OR_20 = (20 - 1) / (20 + 1)), 3)
pA <- ggplot(krzywa, aes(OR, Q)) +
  geom_hline(yintercept = c(-1, 1), linetype = "dashed", colour = "grey55") +
  geom_line(linewidth = 1.1, colour = "#0072B2") +
  geom_point(data = pkt, size = 3, colour = "#D55E00") +
  geom_text(data = pkt, aes(label = et), hjust = -0.12, vjust = 1.1, size = 3.5, lineheight = 0.9) +
  scale_x_log10(breaks = c(0.05, 0.1, 0.25, 0.5, 1, 2, 4, 10, 20), labels = c(".05", ".1", ".25", ".5", "1", "2", "4", "10", "20")) +
  scale_y_continuous(limits = c(-1, 1), breaks = seq(-1, 1, .5)) +
  labs(title = "A. Q = (OR − 1) / (OR + 1)", x = "Iloraz szans (skala logarytmiczna)", y = "Q Yule'a") +
  motyw

# Panel B: grupa z mentorem 70 osób, z czego w terminie 70 (b = 0) albo 69 (b = 1);
# grupa bez mentora 90 osób, odsetek obron w terminie od 10% do 98%
sc <- expand.grid(c = seq(9, 88, by = 1), b = 0:1)
sc$a <- 70 - sc$b; sc$d <- 90 - sc$c
sc$Q <- with(sc, Q(a, b, c, d)); sc$phi <- with(sc, phi(a, b, c, d))
wybrane <- subset(sc, c %in% c(9, 46, 86))
wybrane$odsetek_bez_mentora <- round(100 * wybrane$c / 90, 1)
round(wybrane[, c("b", "c", "odsetek_bez_mentora", "Q", "phi")], 4)
dB <- rbind(data.frame(p0 = sc$c / 90, b = sc$b, miara = "Q Yule'a", wartosc = sc$Q),
            data.frame(p0 = sc$c / 90, b = sc$b, miara = "φ", wartosc = sc$phi))
dB$linia <- factor(sprintf("%s, b = %d", dB$miara, dB$b),
                   levels = c("Q Yule'a, b = 0", "Q Yule'a, b = 1", "φ, b = 0", "φ, b = 1"))
pB <- ggplot(dB, aes(p0, wartosc, colour = linia, linetype = linia)) +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = c("#0072B2", "#56B4E9", "#D55E00", "#E69F00"), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotdash", "dotted"), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%"), breaks = seq(.1, 1, .1)) +
  scale_y_continuous(limits = c(0, 1.02), breaks = seq(0, 1, .2)) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(title = "B. Jedna osoba w komórce b zmienia Q z 1 na ułamek",
       x = "Odsetek obron w terminie bez mentora (n = 90); z mentorem 70 z 70 (b = 0) lub 69 z 70 (b = 1)",
       y = "Wartość miary") +
  motyw

p <- pA / pB
p
Wynik w R
      OR      Q
1  0.500 -0.333
2  1.000  0.000
3  2.000  0.333
4  3.826  0.586
5 10.000  0.818
Q_przy_OR_20
       0.905
    b  c odsetek_bez_mentora      Q    phi
1   0  9                10.0 1.0000 0.8930
38  0 46                51.1 1.0000 0.5432
78  0 86                95.6 1.0000 0.1412
81  1  9                10.0 0.9968 0.8790
118 1 46                51.1 0.9701 0.5237
158 1 86                95.6 0.5249 0.0860
Jak opisać w pracy
Na co uważać
- Pusta komórka. Gdy jedna komórka ma zero, Q = ±1, nawet jeśli pozostałe proporcje są podobne. Podaj liczebności.
- Q to nie phi. Nie porównuj Q z progami dla phi ani V Craméra.
- Kodowanie. Zamiana kolejności wierszy lub kolumn zmienia znak.
- Tylko 2×2. Dla większych tabel porządkowych użyj gammy.
OR, phi i test dla tabeli 2×2 policzysz w kalkulatorze tabeli 2×2.
Q Yule'a w R
Kod symuluje tabelę 2×2 (mentor a obrona w terminie), liczy OR i Q ręcznie, sprawdza zgodność z funkcjami YuleQ() i GoodmanKruskalGamma(), porównuje Q z phi i przelicza przedział ufności OR na skalę Q.
Q Yule'a z przedziałem ufności z OR
R
suppressPackageStartupMessages(library(DescTools))
set.seed(3651)
n <- 160
mentor <- rbinom(n, 1, 0.45)                          # 1 = student miał mentora
obrona <- rbinom(n, 1, ifelse(mentor == 1, 0.80, 0.55))  # 1 = obrona w terminie
tab <- table(mentor = factor(mentor, 1:0, c("tak", "nie")),
             obrona = factor(obrona, 1:0, c("w terminie", "później")))
tab
a <- tab[1, 1]; b <- tab[1, 2]; c <- tab[2, 1]; d <- tab[2, 2]
OR <- (a * d) / (b * c)
round(c(OR = OR, Q = (a * d - b * c) / (a * d + b * c), Q_z_OR = (OR - 1) / (OR + 1)), 3)
round(c(YuleQ = YuleQ(tab), gamma = GoodmanKruskalGamma(tab), phi = Phi(tab)), 3)
OR_ci <- OddsRatio(tab, conf.level = 0.95)           # OR z 95% CI (Wald)
round(OR_ci, 3)
setNames(round((OR_ci - 1) / (OR_ci + 1), 3), c("Q", "lwr.ci", "upr.ci"))  # granice OR przeliczone na Q
Wynik w R
      obrona
mentor w terminie później
   tak         56      14
   nie         46      44
    OR      Q Q_z_OR
 3.826  0.586  0.586
YuleQ gamma   phi
0.586 0.586 0.298
odds ratio     lwr.ci     upr.ci
     3.826      1.868      7.835
     Q lwr.ci upr.ci
 0.586  0.303  0.774
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet DescTools). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak przeliczyć iloraz szans na Q Yule'a?
Q = (OR − 1)/(OR + 1). OR = 2 daje Q = .33, OR = 4 – Q = .60, a OR = 0.5 – Q = −.33. Tak samo przeliczysz granice przedziału ufności OR, bo przekształcenie jest rosnące.
Dlaczego Q Yule'a wychodzi wyższe niż phi?
Phi zależy od rozkładów brzegowych i osiąga 1 tylko przy pasujących do siebie odsetkach w wierszach i kolumnach. Q zależy wyłącznie od ilorazu szans i osiąga ±1, gdy jedna komórka jest pusta. W przykładzie z tego hasła Q = .59, a φ = .30.
Jak policzyć Q Yule'a w R?
W pakiecie DescTools: YuleQ(tab) dla tabeli 2×2. Przedział ufności otrzymasz, przeliczając granice z OddsRatio(tab, conf.level = 0.95) wzorem (OR − 1)/(OR + 1).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kalkulator tabeli 2×2 i r×c
Chi-kwadrat, test dokładny Fishera, V Craméra i reszty dla tabel do 5 × 5, a dla 2 × 2 także OR, RR i różnica odsetków z przedziałami ufności.
Czytaj →PoradnikTest chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Warrens, M. J. (2008). On association coefficients for 2×2 tables and properties that do not depend on the marginal distributions. Psychometrika, 73(4), 777–789. https://doi.org/10.1007/s11336-008-9070-3 ● Otwarty dostęp
- Yule, G. U. (1912). On the methods of measuring association between two attributes. Journal of the Royal Statistical Society, 75(6), 579–652. https://doi.org/10.2307/2340126
Cytowania BibTeX
@article{warrens2008association, author={Warrens, Matthijs J.}, title={{On association coefficients for 2×2 tables and properties that do not depend on the marginal distributions}}, journal={Psychometrika}, year={2008}, volume={73}, number={4}, pages={777--789}, doi={10.1007/s11336-008-9070-3}}@article{yule1912methods, author={Yule, G. Udny}, title={{On the methods of measuring association between two attributes}}, journal={Journal of the Royal Statistical Society}, year={1912}, volume={75}, number={6}, pages={579--652}, doi={10.2307/2340126}}