Co to jest piramida wieku?
Piramida wieku (ang. population pyramid, age–sex pyramid) to para poziomych wykresów słupkowych ustawionych plecami do siebie: na lewo od osi środkowej są mężczyźni, na prawo kobiety, a kolejne słupki od dołu to coraz starsze grupy wieku. Długość słupka to liczebność albo odsetek osób danej płci w danej grupie wieku. W badaniach empirycznych piramida służy przede wszystkim do porównania struktury próby ze strukturą populacji, czyli do szybkiej oceny reprezentatywności próby pod względem płci i wieku.
Jak czytać piramidę
- Oś pozioma rośnie w obie strony od zera. Etykiety po lewej są dodatnie, choć słupki mężczyzn rysuje się jako wartości ujemne.
- Porównuj długości po tej samej stronie – to odczyt pozycji na wspólnej skali. Porównanie płci wymaga zestawienia słupków skierowanych w przeciwne strony.
- Kontur populacji na słupkach próby pokazuje od razu, które komórki płeć × wiek są nadreprezentowane (słupek wystaje poza kontur), a które niedoreprezentowane (pusty fragment konturu).
- Sprawdź mianownik. Odsetek całej próby i odsetek w obrębie płci dają różne piramidy.
Przykład
Symulowany sondaż internetowy objął 600 dorosłych. Strukturę populacji w 14 komórkach płeć × wiek przyjęto ręcznie, a skłonność do udziału ustawiono tak, by malała z wiekiem i była wyższa u kobiet – parametry dobrano, żeby odchylenia były wyraźne; ziarno 771 ustalono z góry. Kobiety stanowiły 59.5% próby wobec 53.0% w populacji, osoby w wieku 18–34 lata – 35.3% wobec 24.7%, a osoby w wieku 65 lat i więcej – 11.8% wobec 25.8%.
Na rysunku
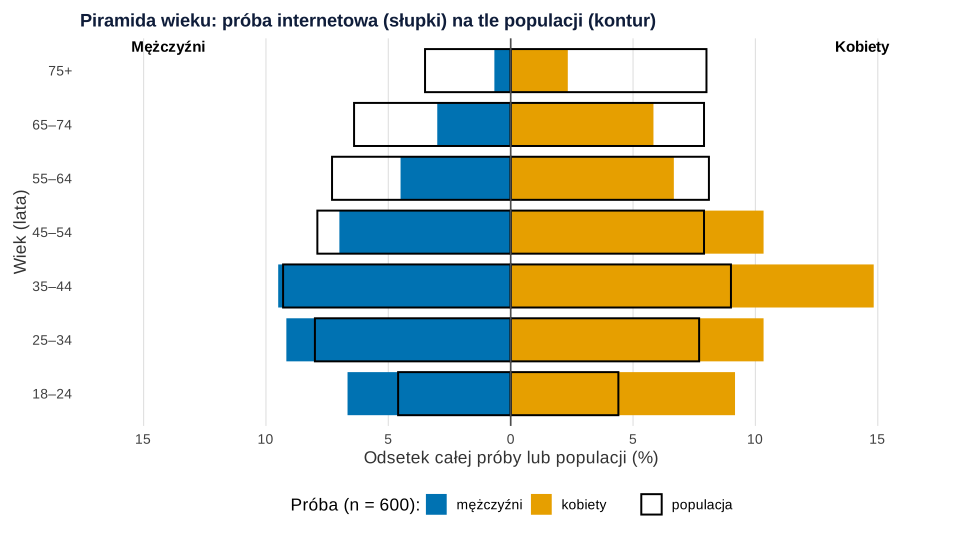
set.seed(771)).Co widać. Próba jest za młoda i za bardzo „kobieca”. Najmłodsze grupy wystają poza kontur, a od 55. roku życia słupki są krótsze niż populacja. W grupie 75+ znalazło się 14 kobiet (2.3% próby wobec 8.0% w populacji) i 4 mężczyzn (0.7% wobec 3.5%).
Na co uważać. Piramida pokazuje tylko dwie zmienne. Próba zgodna z populacją pod względem płci i wieku może się różnić wykształceniem czy zdrowiem – uczestnicy UK Biobank różnili się od populacji wiekiem, płcią, zamożnością i stanem zdrowia (Fry i in., 2017). Duże luki zapowiadają duże wagi poststratyfikacyjne: tu od 0.48 do 5.25, co obniża efektywną liczebność próby z 600 do 431 (Valliant i in., 2018).
Podpis do pracy:
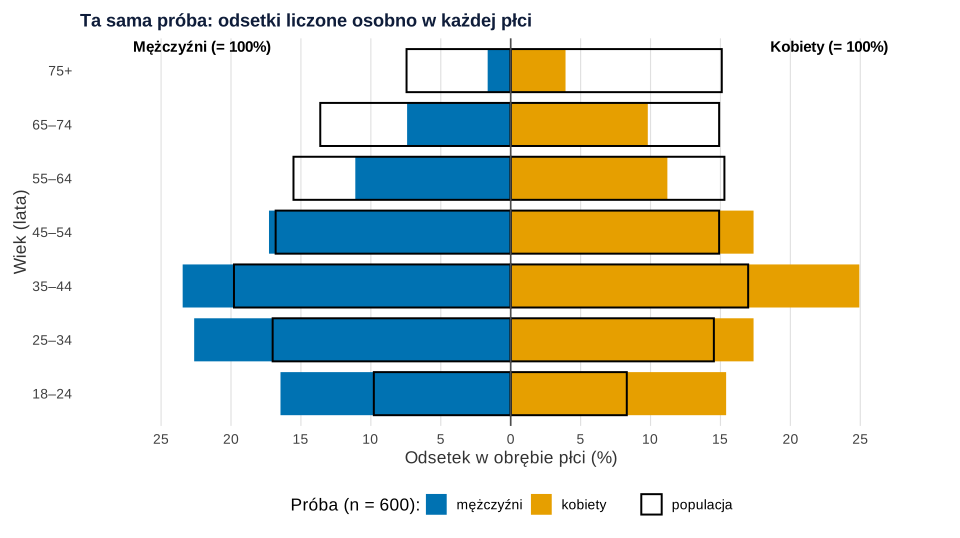
set.seed(771)).Co widać. Każda strona sumuje się teraz do 100%, więc nadwyżka kobiet znika z rysunku. Zmienia się też ocena komórek: mężczyźni w wieku 35–44 lata to 9.5% całej próby wobec 9.3% w populacji (zgodność), ale 23.5% wszystkich mężczyzn w próbie wobec 19.8% w populacji (nadwyżka).
Na co uważać. Ta wersja odpowiada na inne pytanie – o strukturę wieku w każdej płci – i jest poprawna tylko wtedy, gdy podpis to mówi. Liczebności zamiast odsetków nie nadają się do zestawienia z populacją ani z drugą próbą o innym n; do porównania struktur liczy się odsetki całości. Gdy porównujesz grupy o różnej strukturze wieku, potrzebna bywa standaryzacja względem wieku.
Podpis do pracy:
Jak opisać w pracy
Na co uważać
- Nie zmieniaj szerokości grup wieku w połowie osi. Grupa 75+ jest otwarta, więc jej słupek nie jest porównywalny z dziesięcioletnimi.
- Nie skracaj osi asymetrycznie. Obie strony muszą mieć tę samą skalę.
- Kolor to nie jedyny nośnik płci – podpisz strony piramidy.
- Zgodność piramidy z populacją nie dowodzi braku błędu selekcji. Więcej przykładów w poradniku Próba reprezentatywna w obrazkach; zmiany struktury w czasie pokazuje diagram Lexisa.
Piramida wieku w R
Kod symuluje próbę internetową, rysuje piramidę z konturem populacji (p1) i wersję z odsetkami w obrębie płci (p2) oraz liczy liczby z tekstu, w tym wagi poststratyfikacyjne i efektywną liczebność. Piramidę buduje się zwykłym geom_col(): wartości mężczyzn są ujemne, a etykiety osi pokazują wartości bezwzględne. Kod sam definiuje paletę Okabe–Ito i motyw. Rysunki na stronie powstały z tych samych obiektów z motywem serwisu – dane, geometrie i skale są identyczne, różni się krój czcionki i siatka.
Piramida próby na tle populacji
R
# Piramida wieku: struktura płci i wieku próby internetowej na tle populacji
library(ggplot2)
kol <- c("mężczyźni" = "#0072B2", "kobiety" = "#E69F00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), panel.grid.major.y = element_blank(),
        legend.position = "bottom", plot.title = element_text(face = "bold"))

wiek <- c("18–24", "25–34", "35–44", "45–54", "55–64", "65–74", "75+")
# Przyjęta struktura populacji dorosłych (% wszystkich dorosłych, suma = 100)
pop <- data.frame(plec = rep(c("mężczyźni", "kobiety"), each = 7), wiek = rep(wiek, 2),
                  proc = c(4.6, 8.0, 9.3, 7.9, 7.3, 6.4, 3.5,     # mężczyźni
                           4.4, 7.7, 9.0, 7.9, 8.1, 7.9, 8.0))    # kobiety

set.seed(771)                                   # próba internetowa n = 600
sklonnosc <- rep(c(1.6, 1.5, 1.3, 1.0, 0.7, 0.45, 0.2), 2) *   # młodsi częściej odpowiadają
             rep(c(1.0, 1.3), each = 7)                          # kobiety częściej odpowiadają
komorka <- sample(1:14, 600, replace = TRUE, prob = pop$proc * sklonnosc)
proba <- pop[, c("plec", "wiek")]
proba$n <- tabulate(komorka, 14)
proba$proc <- 100 * proba$n / sum(proba$n)

# Dane do rysunku: mężczyźni na lewo (wartości ujemne), kobiety na prawo
dane <- rbind(cbind(proba[, c("plec", "wiek", "proc")], zrodlo = "próba"),
              cbind(pop, zrodlo = "populacja"))
dane$wiek <- factor(dane$wiek, wiek)
dane$plec <- factor(dane$plec, names(kol))
dane$x <- ifelse(dane$plec == "mężczyźni", -dane$proc, dane$proc)
os_x <- scale_x_continuous(limits = c(-16, 16), breaks = seq(-15, 15, 5), labels = function(x) abs(x))

# Rysunek 1: odsetki całej próby, kontur = populacja
p1 <- ggplot(dane, aes(x, wiek)) +
  geom_col(data = dane[dane$zrodlo == "próba", ], aes(fill = plec), width = 0.8, orientation = "y") +
  geom_col(data = dane[dane$zrodlo == "populacja", ], aes(linetype = "populacja"), fill = NA,
           colour = "black", linewidth = 0.7, width = 0.8, orientation = "y") +
  geom_vline(xintercept = 0, colour = "grey30") +
  annotate("text", x = c(-15.5, 15.5), y = 7.45, label = c("Mężczyźni", "Kobiety"),
           hjust = c(0, 1), fontface = "bold", size = 4) +
  scale_fill_manual(values = kol, name = "Próba (n = 600):") +
  scale_linetype_manual(values = "solid", name = NULL) +
  os_x +
  labs(title = "Piramida wieku: próba internetowa (słupki) na tle populacji (kontur)",
       x = "Odsetek całej próby lub populacji (%)", y = "Wiek (lata)") +
  motyw

# Rysunek 2: ta sama próba, ale odsetki liczone osobno w każdej płci
dane$proc_plec <- with(dane, 100 * proc / ave(proc, zrodlo, plec, FUN = sum))
dane$x2 <- ifelse(dane$plec == "mężczyźni", -dane$proc_plec, dane$proc_plec)
p2 <- ggplot(dane, aes(x2, wiek)) +
  geom_col(data = dane[dane$zrodlo == "próba", ], aes(fill = plec), width = 0.8, orientation = "y") +
  geom_col(data = dane[dane$zrodlo == "populacja", ], aes(linetype = "populacja"), fill = NA,
           colour = "black", linewidth = 0.7, width = 0.8, orientation = "y") +
  geom_vline(xintercept = 0, colour = "grey30") +
  annotate("text", x = c(-27, 27), y = 7.45, label = c("Mężczyźni (= 100%)", "Kobiety (= 100%)"),
           hjust = c(0, 1), fontface = "bold", size = 4) +
  scale_fill_manual(values = kol, name = "Próba (n = 600):") +
  scale_linetype_manual(values = "solid", name = NULL) +
  scale_x_continuous(limits = c(-28, 28), breaks = seq(-25, 25, 5), labels = function(x) abs(x)) +
  labs(title = "Ta sama próba: odsetki liczone osobno w każdej płci",
       x = "Odsetek w obrębie płci (%)", y = "Wiek (lata)") +
  motyw

# Liczby do tekstu
por <- merge(proba, pop, by = c("plec", "wiek"), suffixes = c("_proba", "_pop"))
por$waga <- por$proc_pop / por$proc_proba                  # waga poststratyfikacyjna komórki
tapply(proba$n, proba$plec, sum)                           # liczebność według płci
c(kobiety_proba = round(sum(proba$proc[proba$plec == "kobiety"]), 1),
  kobiety_pop = sum(pop$proc[pop$plec == "kobiety"]))
c(wiek_18_34_proba = round(sum(proba$proc[proba$wiek %in% wiek[1:2]]), 1),
  wiek_18_34_pop = sum(pop$proc[pop$wiek %in% wiek[1:2]]),
  wiek_65plus_proba = round(sum(proba$proc[proba$wiek %in% wiek[6:7]]), 1),
  wiek_65plus_pop = sum(pop$proc[pop$wiek %in% wiek[6:7]]))
transform(por[por$wiek == "75+", c("plec", "n", "proc_proba", "proc_pop")], proc_proba = round(proc_proba, 1))
# mężczyźni 35–44: odsetek całej próby vs odsetek w obrębie płci (próba, populacja)
m35 <- dane[dane$plec == "mężczyźni" & dane$wiek == "35–44", c("zrodlo", "proc", "proc_plec")]
transform(m35, proc = round(proc, 1), proc_plec = round(proc_plec, 1))
w <- rep(por$waga, por$n)                                   # waga każdej osoby
c(waga_min = round(min(por$waga), 2), waga_max = round(max(por$waga), 2),
  n_efektywne = round(sum(w)^2 / sum(w^2)))
p1
p2
Wynik w R
  kobiety mężczyźni
      357       243
kobiety_proba   kobiety_pop
         59.5          53.0
 wiek_18_34_proba    wiek_18_34_pop wiek_65plus_proba   wiek_65plus_pop
             35.3              24.7              11.8              25.8
        plec  n proc_proba proc_pop
7    kobiety 14        2.3      8.0
14 mężczyźni  4        0.7      3.5
      zrodlo proc proc_plec
3      próba  9.5      23.5
17 populacja  9.3      19.8
   waga_min    waga_max n_efektywne
       0.48        5.25      431.00
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe i pakiet ggplot2). Rysunki zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak pokazać na piramidzie wieku, czy próba odpowiada populacji?
Narysuj słupki próby jako odsetki całej próby, a strukturę populacji jako kontur na tej samej skali. Słupek wystający poza kontur oznacza komórkę nadreprezentowaną, pusty fragment konturu – niedoreprezentowaną.
Czy piramidę wieku rysować z liczebności, czy z odsetków?
Liczebności wystarczą, gdy opisujesz jedną zbiorowość. Do porównania próby z populacją albo dwóch prób o różnej liczebności użyj odsetków całości, bo inaczej różnica w n zasłania różnicę w strukturze.
Co oznacza zwężający się wierzchołek piramidy wieku w próbie?
W próbie jest mało osób starszych. Jeśli populacja ma ich więcej, starsze osoby są niedoreprezentowane i przy ważeniu dostaną duże wagi, co zmniejsza efektywną liczebność próby.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Próba reprezentatywna w obrazkach
Mapa odmów na fikcyjnej uczelni, struktura próby a wynik, 1000 badań przed ważeniem i po nim, raking i koszt wag – pięć rysunków z kodem R.
Czytaj →PoradnikWażenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fry, A., Littlejohns, T. J., Sudlow, C., Doherty, N., Adamska, L., Sprosen, T., Collins, R., & Allen, N. E. (2017). Comparison of sociodemographic and health-related characteristics of UK Biobank participants with those of the general population. American Journal of Epidemiology, 186(9), 1026–1034. https://doi.org/10.1093/aje/kwx246 ● Otwarty dostęp
- Valliant, R., Dever, J. A., & Kreuter, F. (2018). Practical tools for designing and weighting survey samples (2nd ed.). Springer. https://doi.org/10.1007/978-3-319-93632-1
Cytowania BibTeX
@article{fry2017comparison, author={Fry, Anna and Littlejohns, Thomas J. and Sudlow, Cathie and Doherty, Nicola and Adamska, Ligia and Sprosen, Tim and Collins, Rory and Allen, Naomi E.}, title={{Comparison of sociodemographic and health-related characteristics of UK Biobank participants with those of the general population}}, journal={American Journal of Epidemiology}, year={2017}, volume={186}, number={9}, pages={1026--1034}, doi={10.1093/aje/kwx246}}@book{valliant2018practical, author={Valliant, Richard and Dever, Jill A. and Kreuter, Frauke}, title={{Practical tools for designing and weighting survey samples (2nd ed.)}}, year={2018}, publisher={Springer}, doi={10.1007/978-3-319-93632-1}}