Co to jest odwrotna transformacja normalna rang?
Odwrotna transformacja normalna rang (INT, ang. rank-based inverse normal transformation) zamienia każdą obserwację na jej rangę, a rangę – na kwantyl standardowego rozkładu normalnego. Ogólny wzór to z = Φ−1[(r − c)/(n − 2c + 1)], gdzie r to ranga (średnia przy wiązaniach), a stała c wyznacza wariant: Bloma (c = 3/8), Tukeya (1/3), rankit (1/2) lub van der Waerdena (0). Bez wiązań wynik ma rozkład niemal idealnie normalny, niezależnie od kształtu danych wyjściowych.
W odróżnieniu od wyniku znormalizowanego, który służy do podawania norm testowych, INT stosuje się jako krok analizy, zwłaszcza w genetyce ilościowej. McCaw i in. (2020) odróżniają wersję bezpośrednią (INT zmiennej zależnej przed regresją) od pośredniej (INT reszt po usunięciu wpływu kowariantów) i pokazują, że żadna nie ma przewagi mocy w każdej sytuacji.
Przykład
Symulowane stężenie markera u 40 osób miało skośność 1.25 (test Shapiro–Wilka: p < .001). Po INT Bloma skośność wyniosła 0.00, a p > .99. Trzy najniższe stężenia (0.38, 0.48 i 0.67) dostały wartości −2.16, −1.75 i −1.51. Rankit różnił się od wersji Bloma najwyżej o 0.085, więc wybór wariantu ma małe znaczenie. Inaczej jest przy wynikach z efektem podłogi: skala objawów z 22 zerami na 40 osób dała po INT tylko 5 różnych wartości i skośność 0.80.
Na rysunku
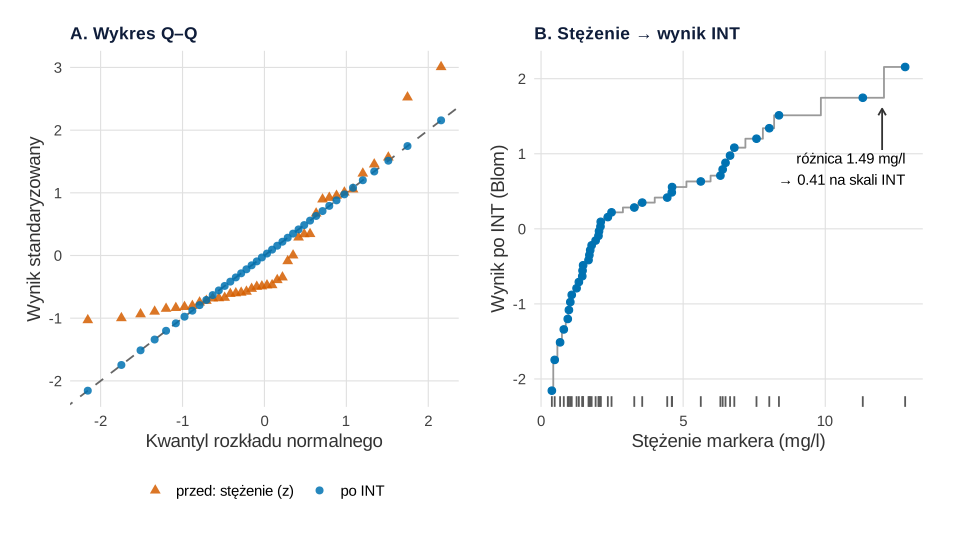
set.seed(645)).Co widać. To te same 40 stężeń, co w przykładzie. W panelu A trójkąty (dane przed INT) układają się w łuk typowy dla prawostronnej skośności: płasko po lewej, stromo po prawej. Kółka po INT leżą na przekątnej co do punktu. Panel B pokazuje, skąd ta „doskonałość”: INT wyrzuca odległości i zostawia tylko kolejność. Dwa najwyższe stężenia różnią się o 1.49 mg/l, a po INT o 0.41; dwa środkowe różnią się o 0.05 mg/l, a po INT o 0.06. Gęsto upakowane niskie wyniki zostają rozciągnięte, a rzadkie wysokie – ściśnięte.
Na co uważać. Prosta linia na wykresie Q–Q po INT niczego nie dowodzi – powstaje z konstrukcji, więc nie pokazuj jej jako „sprawdzenia normalności” (jak czytać wykres Q–Q, opisuje hasło wykres kwantylowy Q-Q). Liczy się rozkład reszt modelu, a nie samej zmiennej. Rysunek nie pokazuje też wiązań: przy wielu równych wynikach punkty po INT nakładają się na siebie, jak w przykładzie z efektem podłogi.
Podpis do pracy:
Kod losuje te same dane co przykład wyżej, z tym samym ziarnem set.seed(645), ustalonym raz. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Wykres Q–Q stężeń przed INT i po niej (A) oraz przekształcenie stężenie → wynik INT (B)
library(ggplot2)
library(patchwork)

kol <- c(przed = "#D55E00", po = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

int <- function(x, c = 3/8) {                        # INT: Φ⁻¹[(r − c)/(n − 2c + 1)], rangi średnie
  r <- rank(x, na.last = "keep"); n <- sum(!is.na(x))
  qnorm((r - c) / (n - 2 * c + 1))
}
set.seed(645)                                        # te same dane co w przykładzie wyżej
stez <- round(rlnorm(40, meanlog = 1, sdlog = 0.9), 2)
z_blom <- int(stez)
n <- length(stez); teor <- qnorm((rank(stez) - 3/8) / (n + 1/4))   # kwantyle teoretyczne (Blom)

qq <- data.frame(teor = rep(teor, 2), wynik = c(as.numeric(scale(stez)), z_blom),
                 stan = factor(rep(c("przed: stężenie (z)", "po INT"), each = n), levels = c("przed: stężenie (z)", "po INT")))
o <- order(stez)
odl <- data.frame(para = c("dwa najwyższe", "dwa środkowe (20. i 21.)"),
                  roznica_stez = c(diff(stez[o][39:40]), diff(stez[o][20:21])),
                  roznica_INT = c(diff(z_blom[o][39:40]), diff(z_blom[o][20:21])))
odl[, 2:3] <- round(odl[, 2:3], 2); odl
round(c(max_stez = max(stez), drugie = sort(stez)[39], max_INT = max(z_blom)), 2)

pA <- ggplot(qq, aes(teor, wynik, colour = stan, shape = stan)) +
  geom_abline(intercept = 0, slope = 1, colour = "grey40", linetype = "dashed") +
  geom_point(size = 2.4, alpha = 0.85) +
  scale_colour_manual(values = unname(kol), name = NULL) + scale_shape_manual(values = c(17, 16), name = NULL) +
  labs(title = "A. Wykres Q–Q", x = "Kwantyl rozkładu normalnego", y = "Wynik standaryzowany") + motyw
pB <- ggplot(data.frame(stez, z_blom), aes(stez, z_blom)) +
  geom_step(direction = "mid", colour = "grey60") +
  geom_point(colour = kol[["po"]], size = 2.2) +
  geom_rug(sides = "b", colour = "grey35") +
  annotate("segment", x = 12, xend = 12, y = 1.05, yend = 1.6, arrow = arrow(length = unit(2, "mm")), colour = "grey20") +
  annotate("text", x = max(stez), y = 0.8, hjust = 1, size = 3.9,
           label = sprintf("różnica %.2f mg/l\n→ %.2f na skali INT", odl$roznica_stez[1], odl$roznica_INT[1])) +
  labs(title = "B. Stężenie → wynik INT", x = "Stężenie markera (mg/l)", y = "Wynik po INT (Blom)") + motyw
p1 <- pA | pB
p1
Wynik w R
                      para roznica_stez roznica_INT
1            dwa najwyższe         1.49        0.41
2 dwa środkowe (20. i 21.)         0.05        0.06
max_stez   drugie  max_INT
   12.81    11.32     2.16
Jak opisać w pracy
Na co uważać
- INT nie gwarantuje poprawnych testów. Beasley i in. (2009) pokazali, że testy na danych po INT nie zawsze utrzymują nominalny poziom błędu I rodzaju i bywa, że mają mniejszą moc; alternatywy to testy nieparametryczne i testy permutacyjne.
- Tracisz jednostki i odległości. Efekt opisuje już położenie w rozkładzie, a nie oryginalne stężenie. Przy umiarkowanej skośności łagodniejsza bywa transformacja Yeo–Johnsona.
- Wiązania zostają. Przy wielu jednakowych wynikach rozkład po INT nie będzie normalny.
- Rangi nadawaj wspólnie. INT wykonana osobno w każdej grupie nadaje grupom ten sam rozkład i usuwa różnice, które chcesz badać.
Odwrotna transformacja normalna rang w R
Funkcja int() realizuje ogólny wzór z parametrem c w bazowym R (rank() i qnorm()); skośność liczy pakiet moments. Liczby w tekście pochodzą z tego kodu.
INT w wariancie Bloma i rankit, skutek wiązań
R
library(moments)
int <- function(x, c = 3/8) {                       # INT: Φ⁻¹[(r − c)/(n − 2c + 1)], rangi średnie
  r <- rank(x, na.last = "keep"); n <- sum(!is.na(x))
  qnorm((r - c) / (n - 2 * c + 1))
}
set.seed(645)                                       # dane symulowane: stężenie markera, n = 40
stez <- round(rlnorm(40, meanlog = 1, sdlog = 0.9), 2)
z_blom <- int(stez)                                 # Blom: c = 3/8
z_rankit <- int(stez, c = 1/2)                      # rankit: (r − 0.5)/n
round(c(skosnosc_przed = skewness(stez), skosnosc_po = skewness(z_blom),
        max_roznica_Blom_rankit = max(abs(z_blom - z_rankit))), 3)
signif(c(SW_p_przed = shapiro.test(stez)$p.value, SW_p_po = shapiro.test(z_blom)$p.value), 3)
round(head(cbind(stez, ranga = rank(stez), z_blom)[order(stez), ], 3), 2)   # trzy najmniejsze
objawy <- rep(0:4, times = c(22, 8, 5, 3, 2))       # wynik z efektem podłogi (55% zer)
round(c(n_unikalnych_po_INT = length(unique(int(objawy))),
        skosnosc_objawy_po_INT = skewness(int(objawy))), 3)
Wynik w R
         skosnosc_przed             skosnosc_po max_roznica_Blom_rankit
                  1.253                   0.000                   0.085
SW_p_przed    SW_p_po
  4.64e-05   1.00e+00
     stez ranga z_blom
[1,] 0.38     1  -2.16
[2,] 0.48     2  -1.75
[3,] 0.67     3  -1.51
   n_unikalnych_po_INT skosnosc_objawy_po_INT
                   5.0                    0.8
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem moments 0.14.1. Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. Podobną transformację (z ekstrapolacją dla nowych danych) wykonuje bestNormalize::orderNorm(). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- moments (wersja 0.14.1): Komsta, L., & Novomestky, F. (2022). moments: Moments, cumulants, skewness, kurtosis and related tests (R package version 0.14.1) [Computer software]. https://doi.org/10.32614/CRAN.package.moments
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Który wariant INT wybrać: Bloma czy rankit?
Przy umiarkowanej i dużej próbie różnice są małe – w przykładzie najwyżej 0.085. Ważniejsze, by wybrać wariant przed analizą i podać go w opisie metody.
Czy po INT można stosować test t i regresję liniową?
Technicznie tak, ale Beasley i in. (2009) ostrzegają, że testy na danych po INT nie zawsze utrzymują poziom błędu I rodzaju. Warto porównać wynik z testem nieparametrycznym lub permutacyjnym.
Jak wykonać INT w R?
Wystarczy bazowy R: qnorm((rank(x) - 3/8) / (length(x) + 1/4)) daje wariant Bloma. Przy brakach danych licz n bez braków i użyj rank(x, na.last = "keep").
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Beasley, T. M., Erickson, S., & Allison, D. B. (2009). Rank-based inverse normal transformations are increasingly used, but are they merited? Behavior Genetics, 39(5), 580–595. https://doi.org/10.1007/s10519-009-9281-0 ● Otwarty dostęp
- McCaw, Z. R., Lane, J. M., Saxena, R., Redline, S., & Lin, X. (2020). Operating characteristics of the rank-based inverse normal transformation for quantitative trait analysis in genome-wide association studies. Biometrics, 76(4), 1262–1272. https://doi.org/10.1111/biom.13214 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{beasley2009rank, author={Beasley, T. Mark and Erickson, Stephen and Allison, David B.}, title={{Rank-based inverse normal transformations are increasingly used, but are they merited?}}, journal={Behavior Genetics}, year={2009}, volume={39}, number={5}, pages={580--595}, doi={10.1007/s10519-009-9281-0}}@article{mccaw2020operating, author={McCaw, Zachary R. and Lane, Jacqueline M. and Saxena, Richa and Redline, Susan and Lin, Xihong}, title={{Operating characteristics of the rank-based inverse normal transformation for quantitative trait analysis in genome-wide association studies}}, journal={Biometrics}, year={2020}, volume={76}, number={4}, pages={1262--1272}, doi={10.1111/biom.13214}}