Co to jest krzywa ROC zależna od czasu?
Zwykła krzywa ROC ocenia marker względem stanu binarnego: chory albo zdrowy. W analizie przeżycia stan zmienia się w czasie – do chwili t zdarzenie u danej osoby wystąpiło albo nie. Heagerty, Lumley i Pepe (2000) zaproponowali, by zdolność dyskryminacyjną markera zmierzonego na początku obserwacji opisywać krzywymi ROC(t) dla skumulowanej częstości zdarzeń do czasu t. Podali dwa estymatory uwzględniające cenzurowanie: prostszy, oparty na estymatorze Kaplana–Meiera, który nie gwarantuje monotoniczności czułości i swoistości, oraz estymator najbliższych sąsiadów, który ją zapewnia.
Przypadki i kontrole w chwili t
W ujęciu skumulowanym (ang. cumulative/dynamic) przypadki to osoby ze zdarzeniem do t (T ≤ t), a kontrole – osoby wolne od zdarzenia po t (T > t). Dla każdego progu liczy się czułość i swoistość, a AUC(t) to prawdopodobieństwo, że losowy przypadek ma wyższy marker niż losowa kontrola. Heagerty i Zheng (2005) zaproponowali miary z czułością i swoistością liczonymi w zbiorach ryzyka w danej chwili i powiązali je z globalną miarą zgodności, wariantem tau Kendalla, bliskim indeksowi C. Ujęcie skumulowane odpowiada na pytanie, kogo marker wskaże jako zagrożonego w ciągu najbliższych t lat.
Przykład
W symulacji 500 osób z markerem zwiększającym hazard każdy był obserwowany 6 lat, więc stan w chwili t < 6 był znany u wszystkich – tylko przy tym założeniu AUC(t) można policzyć testem Manna–Whitneya. Wyszło AUC(1) = 0.728 (90 przypadków), AUC(3) = 0.778 i AUC(5) = 0.784, a indeks C dla całego okresu – 0.718.
Na rysunku
Rysunek pokazuje AUC(t) dla danych z przykładu jako krzywą w funkcji horyzontu, co ćwierć roku od 0.5 do 5.5 roku, z 95% przedziałem ufności z funkcji timeROC(). Dla porównania dodano drugi marker: ten sam marker A zmierzony z błędem o takiej samej SD jak sam marker. Wielkość błędu ustawiono ręcznie tak, by różnica była widoczna; ziarna nie zmieniano.
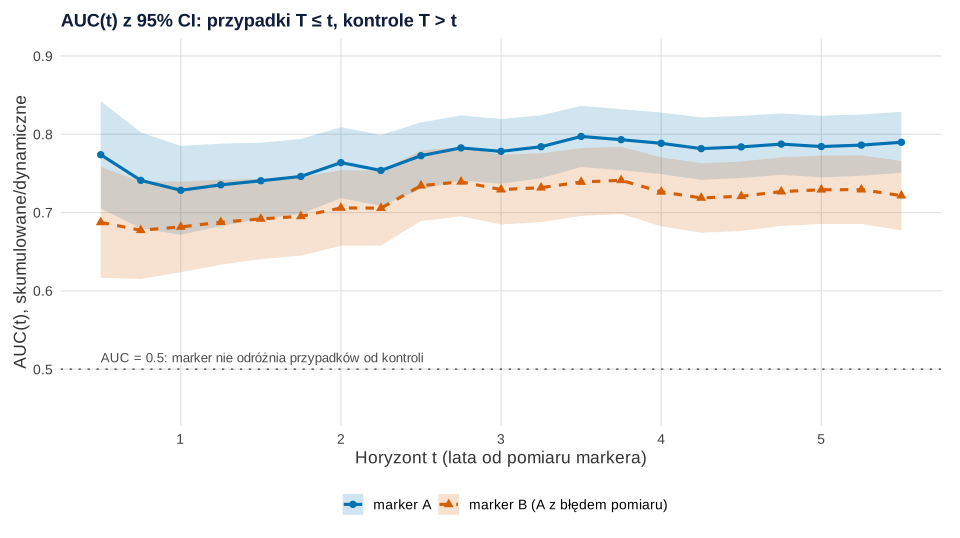
set.seed(650)).Co widać. Marker A ma AUC(1) = 0.728 [0.672, 0.785], AUC(3) = 0.778 [0.737, 0.819] i AUC(5) = 0.784 [0.745, 0.824]; marker B odpowiednio 0.682 [0.624, 0.739], 0.729 [0.685, 0.774] i 0.729 [0.685, 0.773]. Błąd pomiaru obniża dyskryminację w każdym horyzoncie. Test różnicy AUC(t) na tych samych osobach (compare()) daje p = .052 dla t = 1, p = .011 dla t = 3 i p = .003 dla t = 5. Przy krótkim horyzoncie przypadków jest mało (90 do t = 1), więc przedziały są szerokie. Indeks C dla całego okresu wynosi 0.718 dla A i 0.666 dla B – jedna liczba zamiast całej krzywej.
Na co uważać. Punkty krzywej nie są niezależne: w kolejnych horyzontach liczą się w dużej mierze te same osoby, a test w kilkunastu punktach to wielokrotne testy – horyzonty do porównania ustal przed analizą. Wahania krzywej przy małym t, np. spadek z 0.774 przy 0.5 roku do 0.728 przy roku, to w dużej części losowość małej liczby przypadków, a nie zmiana markera. W tym przykładzie nikt nie jest cenzurowany przed 6. rokiem; przy wcześniejszym cenzurowaniu przedziały z wagami IPCW będą szersze. Jak powstaje krzywa ROC dla jednego progu czasu, pokazuje wpis Krzywa ROC w obrazkach.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. AUC(t) z 95% CI w funkcji horyzontu t dla dwóch markerów (timeROC, wagi IPCW)
library(survival)
library(timeROC)
library(ggplot2)

kol <- c("marker A" = "#0072B2", "marker B (A z błędem pomiaru)" = "#D55E00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(650)                                        # te same dane co w przykładzie w haśle
n <- 500
marker <- rnorm(n)
t_zd <- rexp(n, 0.15 * exp(0.8 * marker))
czas <- pmin(t_zd, 6); zd <- as.integer(t_zd <= 6)
marker_b <- marker + rnorm(n, sd = 1)               # ten sam marker mierzony z błędem (SD błędu = SD markera)

horyzonty <- seq(0.5, 5.5, by = 0.25)
roc_a <- timeROC(T = czas, delta = zd, marker = marker, cause = 1, times = horyzonty,
                 weighting = "marginal", iid = TRUE)
roc_b <- timeROC(T = czas, delta = zd, marker = marker_b, cause = 1, times = horyzonty,
                 weighting = "marginal", iid = TRUE)
d <- rbind(data.frame(t = horyzonty, AUC = roc_a$AUC, SE = roc_a$inference$vect_sd_1, marker = names(kol)[1]),
           data.frame(t = horyzonty, AUC = roc_b$AUC, SE = roc_b$inference$vect_sd_1, marker = names(kol)[2]))
d$dol <- d$AUC - 1.96 * d$SE; d$gora <- d$AUC + 1.96 * d$SE
roznica_p <- compare(roc_a, roc_b)$p_values_AUC      # test różnicy AUC(t) na tych samych osobach
odczyt <- d[d$t %in% c(1, 3, 5), ]
print(transform(odczyt, AUC = round(AUC, 3), dol = round(dol, 3), gora = round(gora, 3), SE = NULL), row.names = FALSE)
round(roznica_p[names(roznica_p) %in% c("t=1", "t=3", "t=5")], 3)
c_index <- c(A = concordance(Surv(czas, zd) ~ marker, reverse = TRUE)$concordance,
             B = concordance(Surv(czas, zd) ~ marker_b, reverse = TRUE)$concordance)
round(c_index, 3)

p1 <- ggplot(d, aes(t, AUC, colour = marker, fill = marker, linetype = marker)) +
  geom_hline(yintercept = 0.5, colour = "grey40", linetype = "dotted") +
  geom_ribbon(aes(ymin = dol, ymax = gora), alpha = 0.18, colour = NA) +
  geom_line(linewidth = 1.1) +
  geom_point(aes(shape = marker), size = 2.2) +
  annotate("text", x = 0.5, y = 0.515, label = "AUC = 0.5: marker nie odróżnia przypadków od kontroli",
           hjust = 0, size = 3.5, colour = "grey30") +
  scale_colour_manual(NULL, values = kol) + scale_fill_manual(NULL, values = kol) +
  scale_linetype_manual(NULL, values = c("solid", "22")) +
  scale_shape_manual(NULL, values = c(16, 17)) +
  scale_x_continuous("Horyzont t (lata od pomiaru markera)", breaks = 0:6) +
  scale_y_continuous("AUC(t), skumulowane/dynamiczne", limits = c(0.45, 0.9)) +
  labs(title = "AUC(t) z 95% CI: przypadki T ≤ t, kontrole T > t") + motyw
p1
Wynik w R
 t   AUC                        marker   dol  gora
 1 0.728                      marker A 0.672 0.785
 3 0.778                      marker A 0.737 0.819
 5 0.784                      marker A 0.745 0.824
 1 0.682 marker B (A z błędem pomiaru) 0.624 0.739
 3 0.729 marker B (A z błędem pomiaru) 0.685 0.774
 5 0.729 marker B (A z błędem pomiaru) 0.685 0.773
  t=1   t=3   t=5
0.052 0.011 0.003
    A     B
0.718 0.666
Na co uważać
- Cenzurowanie przed t. Osób cenzurowanych nie wolno usuwać ani liczyć jako kontroli; potrzebne są estymatory oparte na Kaplanie–Meierze albo z wagami IPCW.
- Wybór horyzontu. Podawaj AUC(t) dla kilku z góry ustalonych horyzontów, a nie tylko dla najkorzystniejszego.
- Dyskryminacja to nie wszystko. Trafność przewidywanych ryzyk oceniaj osobno, np. wynikiem Briera.
AUC(t) w R
Kod symuluje czasy zależne od markera z pełną obserwacją przez 6 lat, liczy skumulowane AUC(t) dla kilku horyzontów z statystyki Manna–Whitneya i porównuje je z indeksem C Harrella. Funkcja timeROC::timeROC() z wagami IPCW, potrzebna przy cenzurowaniu przed t, daje tu te same AUC(t) co obliczenie ręczne (0.728 dla t = 1). Liczby w tekście pochodzą z tego kodu.
Skumulowane AUC(t) bez cenzurowania przed t
R
library(survival)
set.seed(650)
n <- 500
marker <- rnorm(n)                                   # biomarker zmierzony na początku obserwacji
t_zd <- rexp(n, 0.15 * exp(0.8 * marker))            # wyższy marker = wyższy hazard
# założenie przykładu: wszyscy obserwowani 6 lat (cenzurowanie tylko administracyjne w t = 6)
czas <- pmin(t_zd, 6); zd <- as.integer(t_zd <= 6)
c(n = n, zdarzenia_do_6_lat = sum(zd))
# AUC skumulowane/dynamiczne: przypadki T <= t, kontrole T > t (tu stan znany u każdego dla t < 6)
auc_t <- function(t) {
  przyp <- marker[czas <= t & zd == 1]; kontr <- marker[czas > t]
  w <- wilcox.test(przyp, kontr, exact = FALSE)$statistic
  c(t = t, przypadki = length(przyp), kontrole = length(kontr), AUC = round(unname(w) / (length(przyp) * length(kontr)), 3))
}
t(sapply(c(0.5, 1, 2, 3, 5), auc_t))
round(concordance(Surv(czas, zd) ~ marker, reverse = TRUE)$concordance, 3)   # indeks C Harrella (cały okres)
# estymator z wagami IPCW (działa też przy cenzurowaniu przed t); tu daje te same AUC(t) co obliczenie ręczne
library(timeROC)
roc_t <- timeROC(T = czas, delta = zd, marker = marker, cause = 1, times = c(0.5, 1, 2, 3, 5), weighting = "marginal")
round(roc_t$AUC, 3)
Wynik w R
                 n zdarzenia_do_6_lat
               500                288
       t przypadki kontrole   AUC
[1,] 0.5        52      448 0.774
[2,] 1.0        90      410 0.728
[3,] 2.0       151      349 0.764
[4,] 3.0       198      302 0.778
[5,] 5.0       261      239 0.784
[1] 0.718
t=0.5   t=1   t=2   t=3   t=5
0.774 0.728 0.764 0.778 0.784
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet survival: concordance(); AUC ze statystyki wilcox.test() z pakietu stats i z funkcji timeROC() z pakietu timeROC; rysunek 1 – także compare() z pakietu timeROC i pakiet ggplot2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- timeROC (wersja 0.4.1): Blanche, P. (2026). timeROC: Time-dependent ROC curve and AUC for censored survival data (R package version 0.4.1) [Computer software]. https://doi.org/10.32614/CRAN.package.timeROC
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czym AUC(t) różni się od indeksu C Harrella?
AUC(t) dotyczy jednego horyzontu: czy marker odróżnia osoby ze zdarzeniem do t od wolnych od zdarzenia w t. Indeks C podsumowuje zgodność kolejności markera i czasów zdarzeń w całym okresie obserwacji. W przykładzie C = 0.718, a AUC(t) wahało się od 0.728 do 0.784.
Jak wybrać horyzont t dla krzywej ROC zależnej od czasu?
Według pytania klinicznego lub praktycznego, np. 1, 3 i 5 lat, i jeszcze przed analizą. Horyzont powinien leżeć w okresie, w którym obserwowano wystarczająco wielu ludzi; przy bardzo małej liczbie przypadków lub osób pod obserwacją AUC(t) jest niestabilne.
Dlaczego nie wolno po prostu usunąć osób cenzurowanych przed t?
Bo nie wiadomo, czy zdarzenie wystąpiłoby u nich przed t. Usunięcie ich zmienia skład próby: zostają wszystkie wczesne zdarzenia, a ubywa osób bez zdarzenia, więc AUC(t) i odsetek przypadków są obciążone. Estymatory dla danych cenzurowanych korzystają z Kaplana–Meiera albo z wag odwrotności prawdopodobieństwa cenzurowania.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Heagerty, P. J., & Zheng, Y. (2005). Survival model predictive accuracy and ROC curves. Biometrics, 61(1), 92–105. https://doi.org/10.1111/j.0006-341x.2005.030814.x
- Heagerty, P. J., Lumley, T., & Pepe, M. S. (2000). Time-dependent ROC curves for censored survival data and a diagnostic marker. Biometrics, 56(2), 337–344. https://doi.org/10.1111/j.0006-341x.2000.00337.x
Cytowania BibTeX
@article{heagerty2005survival, author={Heagerty, Patrick J. and Zheng, Yingye}, title={{Survival model predictive accuracy and ROC curves}}, journal={Biometrics}, year={2005}, volume={61}, number={1}, pages={92--105}, doi={10.1111/j.0006-341x.2005.030814.x}}@article{heagerty2000timedependent, author={Heagerty, Patrick J. and Lumley, Thomas and Pepe, Margaret S.}, title={{Time-dependent ROC curves for censored survival data and a diagnostic marker}}, journal={Biometrics}, year={2000}, volume={56}, number={2}, pages={337--344}, doi={10.1111/j.0006-341x.2000.00337.x}}