Kim byli James Durbin i Geoffrey S. Watson?
James Durbin (1923–2012) urodził się 30 czerwca 1923 r. w Widnes w rodzinie bez tradycji akademickich. W 1942 r. zaczął studiować matematykę w St John’s College w Cambridge, ale z powodu wojny do 1945 r. pracował w wojskowej grupie badań operacyjnych (Army Operational Research Group). W 1948 r. wrócił do Cambridge i dołączył do nowego Department of Applied Economics, kierowanego przez Richarda Stone’a. W 1950 r. przeszedł do London School of Economics, gdzie w 1961 r. został profesorem i pracował do emerytury w 1988 r. Był prezesem Międzynarodowego Instytutu Statystycznego (od 1983 r.) i Royal Statistical Society (1986–1987). Zmarł 23 czerwca 2012 r. w Londynie (Harvey i Bartholomew, 2016).
Geoffrey Stuart Watson (1921–1998) był Australijczykiem. Dyplom uzyskał w Melbourne w 1942 r., a w 1947 r. zaczął studia doktoranckie w Institute of Statistics w Raleigh w Karolinie Północnej. Rozprawę pisał podczas pobytu w Cambridge, a doktorat otrzymał w 1951 r. Potem pracował w Melbourne, na Australian National University, w Toronto (od 1959 r.), na Johns Hopkins (od 1962 r.) i w Princeton (od 1970 r.), gdzie od 1992 r. był profesorem emerytowanym (Beran i Fisher, 1998). Zmarł 3 stycznia 1998 r. (Fisher i Hall, 1998).
Najważniejsze pomysły
- Test Durbina–Watsona (1950–1951). Latem 1949 r. Watson przyjechał na rok do Cambridge i zaczął z Durbinem rozmawiać o testowaniu korelacji szeregowej reszt regresji – problemie, z którym zmagali się ekonomiści z zespołu Stone’a. Rozkład statystyki dla reszt zależy od zmiennych objaśniających, więc autorzy wyprowadzili i stablicowali dolne i górne granice wartości krytycznych (Durbin i Watson, 1950, 1951; Harvey i Bartholomew, 2016). Test opisuje hasło test Durbina–Watsona; o początkach ekonometrii zob. Ragnar Frisch i Jan Tinbergen.
- Statystyka h i dalsze testy Durbina. Gdy test zaczęto stosować w modelach z opóźnioną zmienną zależną, czego autorzy nie przewidywali, Durbin zaproponował w 1970 r. statystykę h. Zajmował się też testami zgodności typu Kołmogorowa–Smirnowa i Cramera–von Misesa przy szacowanych parametrach oraz testem, który rozwinął później Hausman (Harvey i Bartholomew, 2016).
- Modele przestrzeni stanów. Od połowy lat 80. Durbin rozwijał z Andrew Harveyem i Siemem Janem Koopmanem modele strukturalne szeregów czasowych z filtrem Kalmana; w 2001 r. wydał z Koopmanem podręcznik (Harvey i Bartholomew, 2016). Zob. model przestrzeni stanów i filtr Kalmana.
- Watson: regresja nieparametryczna i dane kierunkowe. Watson jest współautorem estymatora Nadarai–Watsona w regresji nieparametrycznej (pokrewnego LOESS) oraz podstawowych metod analizy danych kierunkowych i osiowych; napisał monografię Statistics on Spheres (Beran i Fisher, 1998).
Ciekawostka
Durbin miał posturę sportowca. Jako młody człowiek wspinał się w górach, po ślubie przerzucił się na narty. Po pięćdziesiątce wszedł na Kilimandżaro, a swoje 60. urodziny uczcił wejściem na Mont Blanc – po zaledwie trzech miesiącach przygotowań, które polegały głównie na dojazdach rowerem z Hampstead do pracy w centrum Londynu. Jego koledzy z LSE piszą, że według krążącej opinii jedną z zalet życia akademickiego widział właśnie w czasie na takie wyprawy (Harvey i Bartholomew, 2016).
Watson miał inną pasję: według rozmowy opublikowanej w „Statistical Science” był uznanym malarzem akwareli, a część obrazów pokazywał na swojej stronie w Princeton (Beran i Fisher, 1998).
Przykład na danych z pakietu R
Zbiór Seatbelts z pakietu datasets to według pliku pomocy miesięczne dane z Wielkiej Brytanii z lat 1969–1984: liczba kierowców zabitych lub ciężko rannych, przejechane kilometry, cena benzyny i zmienna law oznaczająca obowiązek zapinania pasów, wprowadzony 31 stycznia 1983 r. Plik pomocy wskazuje jako literaturę właśnie analizę Harveya i Durbina (1986) – to dane, na których Durbin badał skutki ustawy, a analiza wpłynęła na decyzję o jej utrzymaniu (Harvey i Bartholomew, 2016).
Liczymy zwykłą regresję MNK logarytmu liczby ofiar na ustawę, logarytm ceny benzyny i logarytm kilometrów (192 miesiące, w tym 23 z ustawą). Bez uwzględnienia pór roku statystyka DW = 0.87, a z efektami miesięcy – 1.10; autokorelacja reszt pierwszego rzędu wynosi .45, a wzór 2(1 − r1) daje 1.10, czyli prawie tyle samo. Test dokładny z pakietu lmtest, który liczy rozkład DW dla konkretnej macierzy predyktorów, w obu modelach daje p < .001. Sezonowość nie wyjaśnia więc zależności między kolejnymi miesiącami.
Co to zmienia w praktyce? W modelu z miesiącami efekt ustawy to −0.161 w logarytmie, czyli spadek liczby ofiar o 14.9%. Błąd standardowy MNK wynosi 0.0227, a odporny na autokorelację (Newey–West) – 0.0251; efekt pozostaje wyraźny, ale zwykłe MNK przeszacowuje precyzję.
Na rysunku
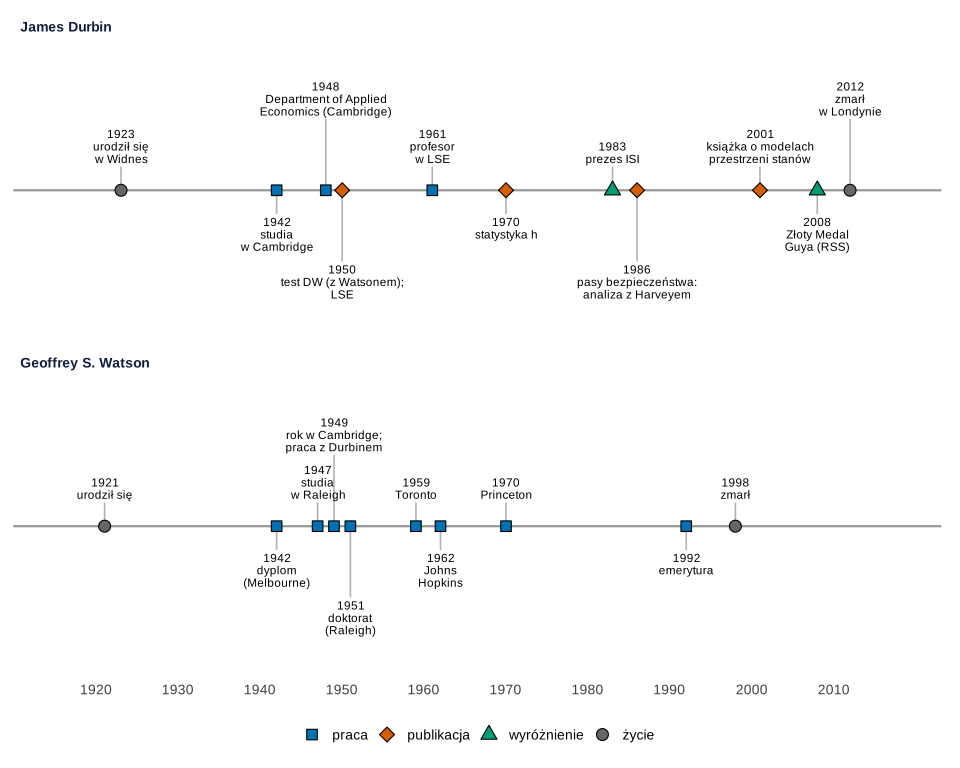
Co widać. Drogi obu autorów przecinają się na krótko w Cambridge w latach 1949–1950; potem Durbin zostaje na resztę kariery w LSE, a Watson zmienia uczelnie na trzech kontynentach.
Na co uważać. Na osi są tylko lata podane w przeczytanych źródłach; prezesurę ISI zaznaczono rokiem objęcia funkcji.
Podpis do pracy:
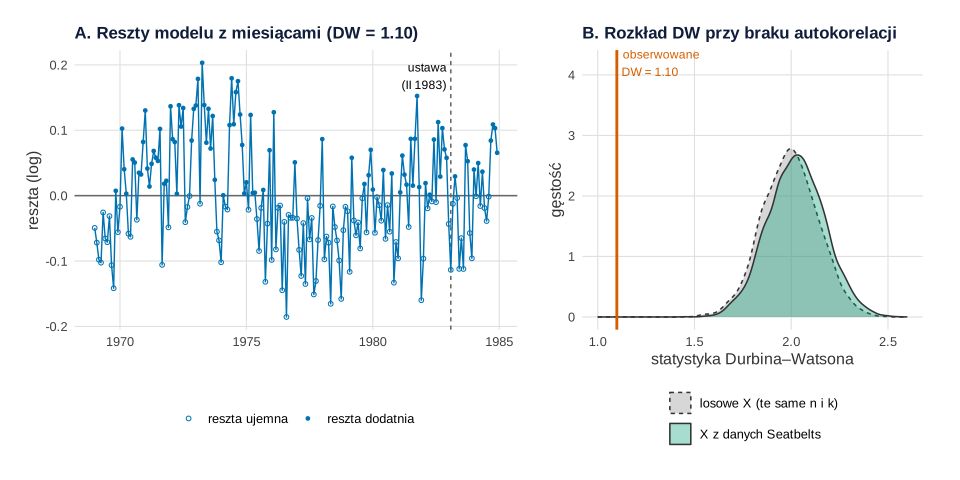
datasets::Seatbelts (1969–1984, 192 miesiące). Obliczenia i rysunek: R, pakiety lmtest, sandwich, ggplot2 i patchwork; symulacja – 4000 powtórzeń dla każdej macierzy, ziarno 1950.Co widać. W panelu A reszty z kolejnych miesięcy „trzymają się razem” – kilka miesięcy nad zerem, potem kilka pod nim; to autokorelacja dodatnia, którą DW = 1.10 sygnalizuje. W panelu B przy niezależnych błędach DW skupia się wokół 2 (w 90% symulacji od 1.79 do 2.27 dla naszej macierzy predyktorów), a żadna z 4000 symulacji nie dała wartości tak małej jak obserwowana.
Na co uważać. Rozkład DW zależy od macierzy predyktorów – stąd granice Durbina i Watsona i test dokładny. Tutaj obie krzywe różnią się niewiele (średnio 2.03 i 2.00), ale przy krótkich szeregach i wielu predyktorach różnica rośnie, a wartość między granicami tablic pozostaje nierozstrzygnięta. DW sprawdza tylko autokorelację pierwszego rzędu i nie nadaje się do modeli z opóźnioną zmienną zależną.
Podpis do pracy:
Gdzie spotkasz Durbina i Watsona w swojej pracy
Wszędzie tam, gdzie obserwacje mają naturalną kolejność: dane miesięczne i roczne, pomiary dzienne w dzienniczkach, kolejne sesje eksperymentu.
- po dopasowaniu regresji do szeregu czasowego podaj DW (albo test Breuscha–Godfreya) i obejrzyj reszty w czasie – więcej w haśle autokorelacja reszt;
- gdy autokorelacja jest wyraźna, użyj błędów odpornych typu Newey–West, dodaj strukturę błędu (np. ARIMA) albo model strukturalny; o ocenie skutków interwencji pisze wpis Regresja segmentowa i przerwany szereg czasowy;
- przy sezonowych danych uwzględnij sezonowość, ale – jak w przykładzie – nie zakładaj, że to usunie zależność między kolejnymi okresami.
Spory, mity i trudne strony
- „DW blisko 2 = wszystko w porządku”. DW wykrywa tylko autokorelację pierwszego rzędu, a prace Durbina i Watsona wyraźnie wykluczały modele z opóźnioną zmienną zależną. Gdy test zaczęto w nich mimo to podawać, Durbin poczuł się odpowiedzialny za naprawienie sytuacji i zaproponował statystykę h (Harvey i Bartholomew, 2016).
Statystyka Durbina–Watsona w R
Kod wczytuje dane Seatbelts, dopasowuje dwa modele regresji, liczy DW ręcznie i porównuje z 2(1 − r1), wykonuje test dokładny dwtest(), porównuje błędy standardowe MNK i Newey–West, symuluje rozkład DW przy braku autokorelacji i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Symulacja używa ziarna 1950 (rok pierwszej pracy Durbina i Watsona, ustalony raz), 4000 powtórzeń na macierz.
1. DW ręcznie, test dokładny i symulacja: rysunek 2
Kod R rysunku 2
# Durbin i Watson: statystyka DW ręcznie i testem dokładnym na danych o wypadkach drogowych (datasets::Seatbelts)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(lmtest); library(sandwich)})
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", zielony = "#009E73", szary = "grey55")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(Seatbelts, package = "datasets")
# miesięczne dane z Wielkiej Brytanii, 1969–1984: drivers – kierowcy zabici lub ciężko ranni;
# law – 1 od lutego 1983 (obowiązek zapinania pasów); PetrolPrice – cena benzyny; kms – przejechane kilometry
d <- data.frame(Seatbelts)
d$data <- as.numeric(time(Seatbelts)); d$miesiac <- factor(cycle(Seatbelts))
c(n = nrow(d), miesiecy_z_ustawa = sum(d$law))

# 1. Dwa modele regresji MNK: bez sezonowości i z efektami miesięcy
m1 <- lm(log(drivers) ~ law + log(PetrolPrice) + log(kms), data = d)
m2 <- lm(log(drivers) ~ law + log(PetrolPrice) + log(kms) + miesiac, data = d)

# 2. Statystyka Durbina–Watsona ręcznie: d = suma (e_t - e_{t-1})^2 / suma e_t^2, czyli w przybliżeniu 2(1 - r1)
dw_recznie <- function(m) { e <- resid(m); sum(diff(e)^2) / sum(e^2) }
r1 <- function(m) { e <- resid(m); sum(e[-1] * e[-length(e)]) / sum(e^2) }
round(rbind(bez_sezonowosci = c(DW = dw_recznie(m1), r1 = r1(m1), `2(1 - r1)` = 2 * (1 - r1(m1))),
            z_miesiacami    = c(DW = dw_recznie(m2), r1 = r1(m2), `2(1 - r1)` = 2 * (1 - r1(m2)))), 3)

# 3. Test dokładny (rozkład DW przy danej macierzy X, algorytm Pana) – pakiet lmtest
dwtest(m1)
dwtest(m2)

# 4. Co autokorelacja robi z błędami standardowymi: efekt ustawy w modelu z miesiącami
efekt <- rbind(MNK = coeftest(m2)["law", ], Newey_West = coeftest(m2, vcov. = NeweyWest(m2))["law", ])
cbind(round(efekt[, 1:3], 4), p = signif(efekt[, 4], 3))
round(c(spadek_procent = 100 * (1 - exp(coef(m2)[["law"]]))), 1)

# 5. Rozkład DW przy H0 zależy od macierzy X – symulacja (błędy niezależne, normalne)
set.seed(1950)
symuluj_dw <- function(X, R = 4000) {
  M <- diag(nrow(X)) - X %*% solve(crossprod(X), t(X))       # macierz tworząca reszty
  e <- M %*% matrix(rnorm(nrow(X) * R), nrow(X))
  colSums(diff(e)^2) / colSums(e^2)
}
X_dane <- model.matrix(m2)
X_losowa <- cbind(1, matrix(rnorm(nrow(X_dane) * (ncol(X_dane) - 1)), nrow(X_dane)))   # te same n i k, X bez trendów
dw_H0 <- data.frame(dw = c(symuluj_dw(X_dane), symuluj_dw(X_losowa)),
                    macierz = rep(c("X z danych Seatbelts", "losowe X (te same n i k)"), each = 4000))
round(do.call(rbind, tapply(dw_H0$dw, dw_H0$macierz, function(x)
  c(srednia = mean(x), q05 = unname(quantile(x, .05)), q95 = unname(quantile(x, .95))))), 3)
c(odsetek_symulacji_ponizej_obserwowanego = mean(dw_H0$dw[dw_H0$macierz == "X z danych Seatbelts"] <= dw_recznie(m2)))

# Rysunek: A – reszty modelu z miesiącami w czasie; B – rozkład DW przy H0 dla dwóch macierzy X
d$reszta <- resid(m2)
pA <- ggplot(d, aes(data, reszta)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_vline(xintercept = 1983 + 1 / 12, linetype = "22", colour = "grey40") +
  geom_line(colour = kol[["niebieski"]], linewidth = 0.5) +
  geom_point(aes(shape = reszta > 0), colour = kol[["niebieski"]], size = 1.3) +
  annotate("text", x = 1983, y = max(d$reszta), label = "ustawa\n(II 1983)", hjust = 1.05, vjust = 1, size = 3.2) +
  scale_shape_manual(values = c(`FALSE` = 1, `TRUE` = 16), labels = c("reszta ujemna", "reszta dodatnia"), name = NULL) +
  labs(title = sprintf("A. Reszty modelu z miesiącami (DW = %.2f)", dw_recznie(m2)), x = NULL, y = "reszta (log)") +
  motyw
pB <- ggplot(dw_H0, aes(dw, fill = macierz, linetype = macierz)) +
  geom_density(alpha = 0.35, colour = "grey20") +
  geom_vline(xintercept = dw_recznie(m2), colour = kol[["pomaranczowy"]], linewidth = 1) +
  annotate("text", x = dw_recznie(m2), y = 4.2, label = sprintf("obserwowane\nDW = %.2f", dw_recznie(m2)),
           hjust = -0.08, size = 3.2, colour = kol[["pomaranczowy"]]) +
  scale_fill_manual(values = c(kol[["szary"]], kol[["zielony"]]), name = NULL) +
  scale_linetype_manual(values = c("22", "solid"), name = NULL) +
  scale_x_continuous(limits = c(1, 2.6)) +
  labs(title = "B. Rozkład DW przy braku autokorelacji", x = "statystyka Durbina–Watsona", y = "gęstość") +
  motyw + guides(fill = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1))
p2 <- pA + pB + plot_layout(widths = c(1.3, 1))
p2
Wynik w R
                n miesiecy_z_ustawa
              192                23
                   DW    r1 2(1 - r1)
bez_sezonowosci 0.872 0.551     0.897
z_miesiacami    1.099 0.448     1.104

	Durbin-Watson test

data:  m1
DW = 0.87156, p-value = 3.567e-16
alternative hypothesis: true autocorrelation is greater than 0


	Durbin-Watson test

data:  m2
DW = 1.0988, p-value = 2.326e-10
alternative hypothesis: true autocorrelation is greater than 0

           Estimate Std. Error t value        p
MNK         -0.1614     0.0227 -7.1207 2.59e-11
Newey_West  -0.1614     0.0251 -6.4422 1.08e-09
spadek_procent
          14.9
                         srednia   q05   q95
losowe X (te same n i k)   1.995 1.762 2.231
X z danych Seatbelts       2.027 1.788 2.273
odsetek_symulacji_ponizej_obserwowanego
                                      0
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: James Durbin (1923–2012) i Geoffrey S. Watson (1921–1998) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1923, 1942, 1948, 1950, 1961, 1970, 1983, 1986, 2001, 2008, 2012,
          1921, 1942, 1947, 1949, 1951, 1959, 1962, 1970, 1992, 1998),
  osoba = c(rep("James Durbin", 11), rep("Geoffrey S. Watson", 10)),
  opis = c("urodził się\nw Widnes", "studia\nw Cambridge", "Department of Applied\nEconomics (Cambridge)",
           "test DW (z Watsonem);\nLSE", "profesor\nw LSE", "statystyka h",
           "prezes ISI", "pasy bezpieczeństwa:\nanaliza z Harveyem", "książka o modelach\nprzestrzeni stanów",
           "Złoty Medal\nGuya (RSS)", "zmarł\nw Londynie",
           "urodził się", "dyplom\n(Melbourne)", "studia\nw Raleigh", "rok w Cambridge;\npraca z Durbinem",
           "doktorat\n(Raleigh)", "Toronto", "Johns\nHopkins", "Princeton", "emerytura", "zmarł"),
  rodzaj = c("życie", "praca", "praca", "publikacja", "praca", "publikacja", "wyróżnienie", "publikacja", "publikacja",
             "wyróżnienie", "życie",
             "życie", "praca", "praca", "praca", "praca", "praca", "praca", "praca", "praca", "życie"),
  poziom = c(0.4, -0.4, 1.2, -1.2, 0.4, -0.4, 0.4, -1.2, 0.4, -0.4, 1.2,
             0.4, -0.4, 0.4, 1.2, -1.2, 0.4, -0.4, 0.4, -0.4, 0.4),     # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5,
                 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5))      # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
zdarzenia$osoba <- factor(zdarzenia$osoba, levels = c("James Durbin", "Geoffrey S. Watson"))
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  facet_wrap(~ osoba, ncol = 1) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1915, 2018), breaks = seq(1920, 2010, by = 10)) +
  scale_y_continuous(limits = c(-2.3, 2.3)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        strip.text = element_text(face = "bold", hjust = 0), legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (regresja – lm() z pakietu stats; test dokładny – dwtest() i coeftest() z pakietu lmtest; błędy Newey–West – NeweyWest() z pakietu sandwich; dane – pakiet datasets; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim byli James Durbin i Geoffrey Watson?
Statystykami, którzy w 1949 r. spotkali się w Department of Applied Economics w Cambridge. Durbin (1923–2012) był potem profesorem London School of Economics i prezesem Royal Statistical Society; Watson (1921–1998), Australijczyk, pracował m.in. w Toronto, na Johns Hopkins i w Princeton.
Jak powstał test Durbina–Watsona?
Latem 1949 r. Watson przyjechał na rok do Cambridge, gdzie ekonomiści z zespołu Richarda Stone’a mieli kłopot z korelacją szeregową reszt regresji. Ponieważ rozkład statystyki zależy od zmiennych objaśniających, Durbin i Watson stablicowali dolne i górne granice wartości krytycznych; prace ukazały się w „Biometrice” w 1950 i 1951 r.
Jak policzyć statystykę Durbina–Watsona ręcznie?
Podziel sumę kwadratów różnic kolejnych reszt przez sumę kwadratów reszt. Wynik jest w przybliżeniu równy 2(1 − r1), gdzie r1 to autokorelacja reszt. W regresji ofiar wypadków z danych Seatbelts DW = 1.10 przy r1 = .45, a test dokładny daje p < .001.
Czym zajmował się Geoffrey Watson poza testem DW?
Regresją nieparametryczną – jest współautorem estymatora Nadarai–Watsona – oraz statystyką danych kierunkowych i osiowych, o której napisał monografię Statistics on Spheres. Prywatnie był cenionym akwarelistą.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Beran, R. J., & Fisher, N. I. (1998). A conversation with Geoff Watson. Statistical Science, 13(1), 75–93. https://doi.org/10.1214/ss/1028905975 ● Otwarty dostęp
- Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression. I. Biometrika, 37(3–4), 409–428. https://doi.org/10.1093/biomet/37.3-4.409
- Durbin, J., & Watson, G. S. (1951). Testing for serial correlation in least squares regression. II. Biometrika, 38(1–2), 159–178. https://doi.org/10.1093/biomet/38.1-2.159
- Fisher, N. I., & Hall, P. (1998). Tribute: Geoffrey Stuart Watson: Tributes and obituary (3 December 1921 – 3 January 1998). Australian & New Zealand Journal of Statistics, 40(3), 257–268. https://doi.org/10.1111/1467-842x.00030
- Harvey, A. C., & Durbin, J. (1986). The effects of seat belt legislation on British road casualties: A case study in structural time series modelling. Journal of the Royal Statistical Society. Series A (General), 149(3), 187–227. https://doi.org/10.2307/2981553
- Harvey, A., & Bartholomew, D. (2016). James Durbin 1923–2012. Biographical Memoirs of Fellows of the British Academy, 15, 43–52. https://www.thebritishacademy.ac.uk/documents/1063/03-Durbin.pdf ● Otwarty dostęp
Cytowania BibTeX
@article{beran1998conversation, author={Beran, R. J. and Fisher, N. I.}, title={{A conversation with Geoff Watson}}, journal={Statistical Science}, year={1998}, volume={13}, number={1}, pages={75--93}, doi={10.1214/ss/1028905975}}@article{durbin1950testing, author={Durbin, J. and Watson, G. S.}, title={{Testing for serial correlation in least squares regression. I}}, journal={Biometrika}, year={1950}, volume={37}, number={3–4}, pages={409--428}, doi={10.1093/biomet/37.3-4.409}}@article{durbin1951testing, author={Durbin, J. and Watson, G. S.}, title={{Testing for serial correlation in least squares regression. II}}, journal={Biometrika}, year={1951}, volume={38}, number={1–2}, pages={159--178}, doi={10.1093/biomet/38.1-2.159}}@article{fisher1998tribute, author={Fisher, Nicholas I. and Hall, Peter}, title={{Tribute: Geoffrey Stuart Watson: Tributes and obituary (3 December 1921 – 3 January 1998)}}, journal={Australian \& New Zealand Journal of Statistics}, year={1998}, volume={40}, number={3}, pages={257--268}, doi={10.1111/1467-842x.00030}}@article{harvey1986effects, author={Harvey, A. C. and Durbin, J.}, title={{The effects of seat belt legislation on British road casualties: A case study in structural time series modelling}}, journal={Journal of the Royal Statistical Society. Series A (General)}, year={1986}, volume={149}, number={3}, pages={187--227}, doi={10.2307/2981553}}@article{harvey2016james, author={Harvey, Andrew and Bartholomew, David}, title={{James Durbin 1923–2012}}, journal={Biographical Memoirs of Fellows of the British Academy}, year={2016}, volume={15}, pages={43--52}, publisher={The British Academy}, url={https://www.thebritishacademy.ac.uk/documents/1063/03-Durbin.pdf}}