Co to jest frakcja przypisywalna?
Frakcja przypisywalna w populacji (ang. population attributable fraction, PAF) to odsetek wszystkich przypadków choroby w populacji, które można przypisać danej ekspozycji, czyli których by nie było, gdyby ekspozycji nie było. Mansournia i Altman (2018) zapisują ją jako PAF = (O − E) / O, gdzie O to liczba przypadków obserwowanych, a E – oczekiwanych bez ekspozycji. Słowo „przypisywalna” ma sens przyczynowy, więc liczba ta ma wartość tylko wtedy, gdy związek jest przyczynowy (zob. korelacja a przyczynowość).
Dwa wzory
Levin: PAF = p(RR − 1) / [1 + p(RR − 1)], p – odsetek eksponowanych w populacji
Miettinen: PAF = pc(RR − 1) / RR, pc – odsetek eksponowanych wśród chorych
Miettinen (1974) pokazał, że frakcja zależy od częstości ekspozycji wśród przypadków i od ilorazu ryzyka u eksponowanych, a jej oszacowanie jest szczególnie proste w badaniu kliniczno-kontrolnym.
Przykład z zakłóceniem
W symulowanej kohorcie 20 000 osób ekspozycja była częstsza u starszych, a starsi częściej chorowali. Prawdziwe ryzyko względne wynosiło 2 w obu grupach wieku. Surowe RR = 3.05, a RR Mantela–Haenszela skorygowane względem wieku – 2.10. PAF z definicji, (O − E) / O, wyniósł 0.326. Wzór Miettinena z RR skorygowanym dał 0.325, a wzór Levina 0.418 z RR surowym i 0.278 ze skorygowanym. Gdy wiek działa jak zmienna zakłócająca, wzór Levina zawodzi nawet z miarą skorygowaną; z RR skorygowanym łącz wzór Miettinena.
Na rysunku
Rysunek pokazuje, jak PAF ze wzoru Levina zależy od częstości ekspozycji w populacji przy trzech wartościach ryzyka względnego. Krzywe są wyliczone ze wzoru, a dwa punkty pochodzą z kohorty z przykładu (set.seed(530)), w której wiek zakłóca związek.
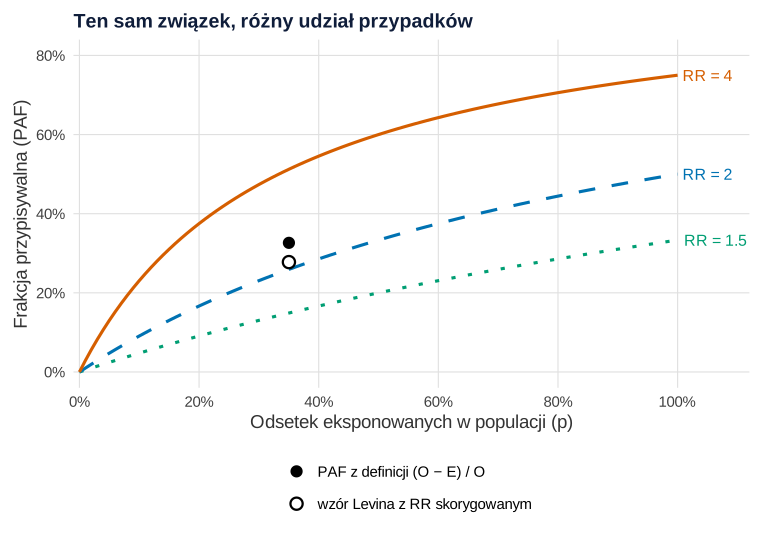
set.seed(530)).Co widać. PAF zależy od dwóch rzeczy naraz: siły związku i częstości ekspozycji. Rzadka ekspozycja (5% populacji) przy silnym związku RR = 4 odpowiada za 13.0% przypadków, a częsta (50%) przy słabym RR = 1.5 – za 20.0%. Gdy eksponowani są wszyscy, krzywe dochodzą do frakcji wśród eksponowanych, (RR − 1) / RR: 33.3%, 50.0% i 75.0%. Dwa punkty z przykładu leżą przy p = 35%: PAF z definicji wynosi 32.6%, a wzór Levina z RR skorygowanym (2.10) daje tylko 27.8%.
Na co uważać. Krzywe Levina są poprawne tylko wtedy, gdy RR jest nieobciążonym efektem przyczynowym i nie ma zakłócenia. Przykład pokazuje, że przy zakłóceniu nawet RR skorygowane wstawione do tego wzoru zaniża PAF (puste kółko pod pełnym) – wtedy łącz RR skorygowane ze wzorem Miettinena. Rysunek nie pokazuje niepewności ani tego, ile przypadków da się rzeczywiście uniknąć: interwencja rzadko usuwa ekspozycję u wszystkich. Jak zmienna zakłócająca zmienia oszacowanie związku, pokazuje wpis Zmienna zakłócająca i collider – wizualizacja.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu. Jest samowystarczalny: prosty motyw i paletę Okabe–Ito definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki. Wartości RR = 1.5, 2 i 4 wybrano ręcznie do porównania. Kod losuje raz, z ziarnem set.seed(530) z przykładu hasła; ziarna nie zmieniano.
Kod R rysunku 1
# Rysunek 1. PAF ze wzoru Levina w funkcji częstości ekspozycji dla RR = 1.5, 2 i 4 oraz przykład z zakłóceniem
library(ggplot2)

motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))
kolory <- c("RR = 1.5" = "#009E73", "RR = 2" = "#0072B2", "RR = 4" = "#D55E00")   # Okabe–Ito

levin <- function(p, rr) p * (rr - 1) / (1 + p * (rr - 1))
krzywe <- expand.grid(p = seq(0, 1, by = 0.01), rr = c(1.5, 2, 4))
krzywe$paf <- levin(krzywe$p, krzywe$rr)
krzywe$RR <- factor(paste("RR =", krzywe$rr), names(kolory))
tab <- outer(c(0.05, 0.10, 0.20, 0.35, 0.50, 0.80, 1), c(1.5, 2, 4), levin)
dimnames(tab) <- list(p = c(.05, .10, .20, .35, .50, .80, 1), RR = c(1.5, 2, 4)); round(tab, 3)

# Kohorta z przykładu hasła (wiek zakłóca związek): PAF z definicji a wzór Levina z RR skorygowanym
set.seed(530)
n <- 20000
starszy <- rbinom(n, 1, 0.5)
ekspozycja <- rbinom(n, 1, ifelse(starszy == 1, 0.50, 0.20))
ryzyko0 <- ifelse(starszy == 1, 0.08, 0.02)
choroba <- rbinom(n, 1, ryzyko0 * ifelse(ekspozycja == 1, 2, 1))
r0 <- sapply(0:1, function(s) mean(choroba[ekspozycja == 0 & starszy == s]))   # ryzyko bez ekspozycji
w <- sapply(0:1, function(s) {                    # składniki RR Mantela–Haenszela
  i <- starszy == s; N <- sum(i)
  c(sum(choroba[i & ekspozycja == 1]) * sum(i & ekspozycja == 0) / N,
    sum(choroba[i & ekspozycja == 0]) * sum(i & ekspozycja == 1) / N)
})
rr_mh <- sum(w[1, ]) / sum(w[2, ])
p <- mean(ekspozycja)
paf_def <- (sum(choroba) - sum(table(starszy) * r0)) / sum(choroba)   # (O − E) / O
punkty <- data.frame(p = p, paf = c(paf_def, levin(p, rr_mh)),
                     co = c("PAF z definicji (O − E) / O", "wzór Levina z RR skorygowanym"))
round(c(p = p, RR_MH = rr_mh, PAF_definicja = paf_def, Levin_RR_MH = levin(p, rr_mh)), 3)

p1 <- ggplot(krzywe, aes(p, paf)) +
  geom_line(aes(colour = RR, linetype = RR), linewidth = 1.1) +
  geom_text(data = subset(krzywe, p == 1), aes(label = RR, colour = RR), hjust = -0.1, size = 4.2,
            show.legend = FALSE) +
  geom_point(data = punkty, aes(shape = co), size = 3.5, fill = "white", stroke = 1.2) +
  scale_colour_manual(values = kolory, guide = "none") +
  scale_linetype_manual(values = c("dotted", "dashed", "solid"), guide = "none") +
  scale_shape_manual(values = c(16, 21), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%"), breaks = seq(0, 1, 0.2),
                     expand = expansion(mult = c(0.01, 0.12))) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 0.8)) +
  guides(shape = guide_legend(ncol = 1)) +
  labs(title = "Ten sam związek, różny udział przypadków",
       x = "Odsetek eksponowanych w populacji (p)", y = "Frakcja przypisywalna (PAF)") + motyw
p1   # zapis: ggsave("frakcja-przypisywalna-paf-czestosc-ekspozycji.svg", p1, width = 8, height = 5.6)
Wynik w R
      RR
p        1.5     2     4
  0.05 0.024 0.048 0.130
  0.1  0.048 0.091 0.231
  0.2  0.091 0.167 0.375
  0.35 0.149 0.259 0.512
  0.5  0.200 0.333 0.600
  0.8  0.286 0.444 0.706
  1    0.333 0.500 0.750
            p         RR_MH PAF_definicja   Levin_RR_MH
        0.350         2.098         0.326         0.278
Jak opisać w pracy
Na co uważać
- PAF a frakcja wśród eksponowanych. (RR − 1) / RR dotyczy tylko osób eksponowanych; PAF odnosi ją do wszystkich przypadków w populacji.
- PAF a różnica ryzyka. ARR to różnica ryzyk w punktach procentowych, a PAF – udział przypadków.
- Sumowanie czynników. PAF kilku czynników mogą w sumie przekroczyć 100%, bo ten sam przypadek może wymagać kilku przyczyn naraz.
PAF w R
Kod symuluje kohortę z wiekiem jako czynnikiem zakłócającym, liczy RR surowe i RR Mantela–Haenszela, PAF z definicji (O − E) / O oraz ze wzorów Levina i Miettinena. Liczby w tekście pochodzą z tego kodu.
PAF z definicji, wzór Levina i wzór Miettinena
R
set.seed(530)                                   # kohorta 20 000 osób, wiek jako czynnik zakłócający
n <- 20000
starszy <- rbinom(n, 1, 0.5)
ekspozycja <- rbinom(n, 1, ifelse(starszy == 1, 0.50, 0.20))  # ekspozycja częstsza u starszych
ryzyko0 <- ifelse(starszy == 1, 0.08, 0.02)                    # ryzyko bez ekspozycji
choroba <- rbinom(n, 1, ryzyko0 * ifelse(ekspozycja == 1, 2, 1)) # prawdziwe RR = 2 w obu warstwach
r <- function(e, s = c(0, 1)) mean(choroba[ekspozycja == e & starszy %in% s])
rr_surowe <- r(1) / r(0)
w <- sapply(0:1, function(s) {                  # RR Mantela-Haenszela
  i <- starszy == s; a <- sum(choroba[i & ekspozycja == 1]); c0 <- sum(choroba[i & ekspozycja == 0])
  n1 <- sum(i & ekspozycja == 1); n0 <- sum(i & ekspozycja == 0); N <- sum(i)
  c(licz = a * n0 / N, mian = c0 * n1 / N)
})
rr_mh <- sum(w["licz", ]) / sum(w["mian", ])
O <- sum(choroba)                               # obserwowane przypadki
E <- sum(sapply(0:1, function(s) sum(starszy == s) * r(0, s)))  # oczekiwane bez ekspozycji
p  <- mean(ekspozycja)                          # odsetek eksponowanych w populacji
pc <- mean(ekspozycja[choroba == 1])            # odsetek eksponowanych wśród chorych
levin <- function(rr) p * (rr - 1) / (1 + p * (rr - 1))
round(c(RR_surowe = rr_surowe, RR_MH = rr_mh, p = p, pc = pc,
        PAF_O_E = (O - E) / O,
        Levin_RR_surowe = levin(rr_surowe), Levin_RR_MH = levin(rr_mh),
        Miettinen_RR_MH = pc * (rr_mh - 1) / rr_mh), 3)
Wynik w R
      RR_surowe           RR_MH               p              pc         PAF_O_E
          3.047           2.098           0.350           0.622           0.326
Levin_RR_surowe     Levin_RR_MH Miettinen_RR_MH
          0.418           0.278           0.325
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (bez dodatkowych pakietów). Rysunek 1 wykonano w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy PAF = 30% oznacza, że 30% chorych zachorowało z powodu ekspozycji?
Tylko przy założeniu, że związek jest przyczynowy, a zakłócenia uwzględniono. PAF szacuje, ilu przypadków by nie było bez ekspozycji; nie wskazuje, którzy konkretnie chorzy zachorowali z jej powodu.
Który wzór wybrać: Levina czy Miettinena?
Wzór Levina tylko wtedy, gdy RR nie jest zakłócone. Przy zakłóceniu użyj RR skorygowanego we wzorze Miettinena z odsetkiem eksponowanych wśród chorych. W przykładzie Levin dał 0.278 wobec prawdziwych 0.326, a Miettinen 0.325.
Czy PAF można policzyć w badaniu kliniczno-kontrolnym?
Tak, wzorem Miettinena: odsetek eksponowanych wśród chorych daje grupa przypadków (Miettinen, 1974, wskazuje ten schemat jako szczególnie prosty), a RR zastępuje się ilorazem szans, który przy rzadkiej chorobie dobrze je przybliża.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Mansournia, M. A., & Altman, D. G. (2018). Population attributable fraction. BMJ, 360, Article k757. https://doi.org/10.1136/bmj.k757 ● Otwarty dostęp
- Miettinen, O. S. (1974). Proportion of disease caused or prevented by a given exposure, trait or intervention. American Journal of Epidemiology, 99(5), 325–332. https://doi.org/10.1093/oxfordjournals.aje.a121617
Cytowania BibTeX
@article{mansournia2018population, author={Mansournia, Mohammad Ali and Altman, Douglas G.}, title={{Population attributable fraction}}, journal={BMJ}, year={2018}, volume={360}, eid={k757}, doi={10.1136/bmj.k757}}@article{miettinen1974proportion, author={Miettinen, Olli S.}, title={{Proportion of disease caused or prevented by a given exposure, trait or intervention}}, journal={American Journal of Epidemiology}, year={1974}, volume={99}, number={5}, pages={325--332}, doi={10.1093/oxfordjournals.aje.a121617}}