Kim był Andriej Markow?
Andriej Andriejewicz Markow (1856–1922) był rosyjskim matematykiem z Petersburga, od którego nazwiska pochodzi łańcuch Markowa – model ciągu stanów, w którym następny stan zależy tylko od obecnego. Seneta (2013) nazywa go, obok Aleksandra Lapunowa, najwybitniejszym uczniem Pafnutija Czebyszewa. Pracował w duchu szkoły Czebyszewa, w której zamiast przybliżeń asymptotycznych ceniono ścisłe oszacowania błędu.
Był członkiem Petersburskiej Akademii Nauk – Bernstein pisał po latach o „zmarłym akademiku A. A. Markowie” (Seneta, 2013). Przez lata 1898–1906 wiele jego prac ukazywało się w czasopiśmie Towarzystwa Fizyczno-Matematycznego przy Uniwersytecie Kazańskim, wydawanym przez jego przyjaciela Aleksandra Wasiljewa. Od listopada 1910 do początku 1917 r. korespondował ze statystykiem Aleksandrem Czuprowem; ta wymiana listów zbliżyła rosyjski rachunek prawdopodobieństwa i statystykę. Zmarł w 1922 r., już po przejęciu władzy przez bolszewików, a jego podręcznik Rachunek prawdopodobieństwa ukazał się w 1924 r. w czwartym, pośmiertnym wydaniu (Seneta, 2013).
Najważniejsze pomysły
- Prawo wielkich liczb bez niezależności (1906). Wcześniejsze wersje prawa wielkich liczb – Jakoba Bernoulliego, Poissona i Czebyszewa – zakładały niezależność prób. Markow pokazał, że średnia z ciągu zmiennych zależnych też stabilizuje się wokół stałej, jeśli zależność ma odpowiednią postać. Jako przykład zbudował skończony, jednorodny łańcuch o dodatnich prawdopodobieństwach przejść i udowodnił dla niego prawo wielkich liczb. Praca kończy się wnioskiem, że niezależność zmiennych nie jest warunkiem koniecznym tego prawa (Seneta, 2013).
- Współczynnik ergodyczności. W tej samej pracy użył wielkości nazwanej później współczynnikiem ergodyczności: mierzy ona, jak mnożenie przez macierz przejść „ściąga” do siebie wartości wektora. Na tym oparł dowód, że łańcuch zapomina o stanie początkowym (Seneta, 1996).
- Nierówność Markowa. Dla nieujemnej zmiennej U i dodatniej liczby u zachodzi P(U ≥ u) ≤ E(U)/u. W trzecim wydaniu podręcznika (1913) to lemat, z którego Markow wyprowadza nierówność Bienaymégo–Czebyszewa w dzisiejszy, standardowy sposób; Bernstein nazywał ją lematem Czebyszewa (Seneta, 2013).
- Pierwsze zastosowanie do danych (1913). Teorię łańcuchów, rozwijaną czysto teoretycznie, Markow sprawdził w dwóch artykułach z 1913 r. na tekście literackim (Link, 2006).
Ciekawostka
Pierwszym „empirycznym” łańcuchem Markowa nie był proces fizyczny, tylko wiersz. 23 stycznia 1913 r. Markow przedstawił w Akademii Nauk w Petersburgu analizę 20 000 rosyjskich liter z „Eugeniusza Oniegina” Puszkina – całego pierwszego rozdziału i szesnastu strof drugiego – z pominięciem znaku miękkiego i twardego. Badał, jak samogłoski i spółgłoski następują po sobie, czyli czy kolejne „próby” w tekście są od siebie zależne (Markov, 1913/2006). Jego angielski przekład opublikowano w 2006 r.
W tym samym roku Markow zainicjował obchody 200-lecia prawa wielkich liczb, liczonego od Ars Conjectandi Jakoba Bernoulliego (1713). W 1913 r. ukazał się rosyjski przekład czwartej części tej książki z przedmową Markowa, a trzecie wydanie swojego podręcznika opatrzył dedykacją dla jubileuszu. Wygłosił też referat na uroczystym posiedzeniu, ale w liście do Czuprowa napisał zaraz potem, że nie zamierza go publikować – referat ukazał się jednak drukiem w 1914 r. (Seneta, 2013).
Przykład
Powtarzamy pomysł Markowa na tekście polskim: pierwsze 40 wersów „Pana Tadeusza” Adama Mickiewicza (domena publiczna; tekst według wydania Wolnych Lektur, wpisany w kod). Zostawiamy same litery, bez spacji i interpunkcji, i każdą oznaczamy jako samogłoskę (a, ą, e, ę, i, o, ó, u, y) albo spółgłoskę. Liczby pochodzą z naszego przeliczenia, nie z pracy Markowa.
Fragment ma 1440 liter, w tym 592 samogłoski (41.1%). Gdyby litery były niezależne, po samogłosce samogłoska wypadałaby z tą samą szansą. Tymczasem w tabeli przejść po 591 samogłoskach następna była samogłoską tylko 101 razy (0.171), a po 848 spółgłoskach – 491 razy (0.579). Test chi-kwadrat niezależności daje χ²(1) = 239.55, p < .001: następna litera zależy od obecnej. Rozkład stacjonarny łańcucha z tą macierzą przejść to 0.411 samogłosek – praktycznie tyle, ile w tekście.
Czy łańcuch pierwszego rzędu wystarcza? Model przewiduje, że dwie litery po samogłosce samogłoska wystąpi z prawdopodobieństwem 0.509, a w tekście było 0.426; po spółgłosce: 0.343 wobec 0.400. Od odstępu 4 przewidywania modelu i częstości w tekście są bliskie 0.41.
Na rysunku
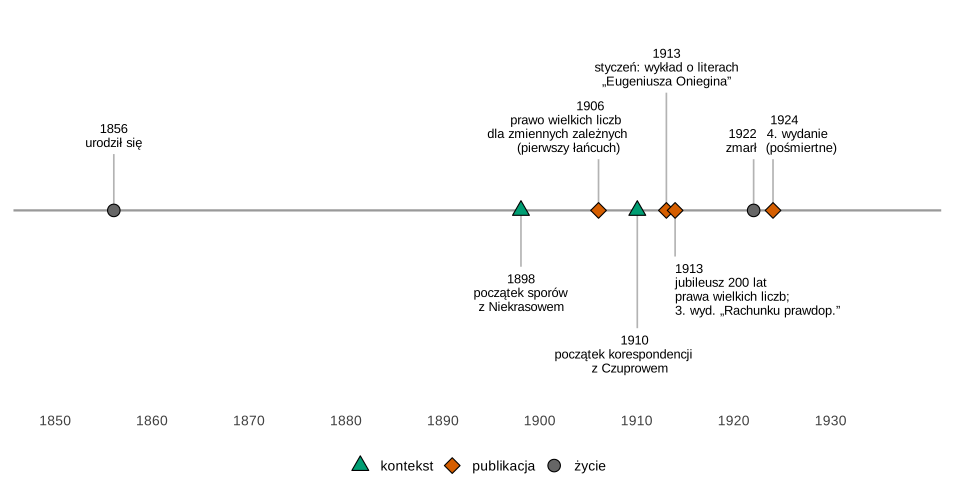
Co widać. Najważniejsze prace Markowa o zależności powstały w ostatnich dwóch dekadach jego życia i wyrastają ze sporu z Niekrasowem (od 1898 r.). Rok 1913 jest wyjątkowo gęsty: wykład o „Onieginie”, jubileusz prawa wielkich liczb i nowe wydanie podręcznika.
Na co uważać. Oś pokazuje tylko zdarzenia, których daty podają cytowane źródła. Brakuje na niej m.in. dat studiów, stopni naukowych i wyboru do Akademii, bo nie znaleźliśmy ich w źródłach, które mogliśmy przeczytać.
Podpis do pracy:
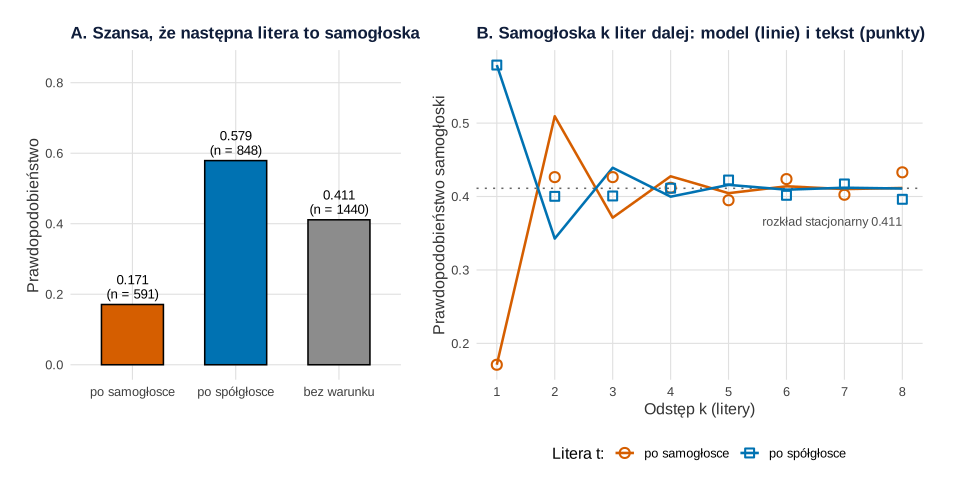
Co widać. Panel A pokazuje sedno pomysłu Markowa: szansa samogłoski silnie zależy od poprzedniej litery – po samogłosce jest ponad trzy razy mniejsza niż po spółgłosce. Panel B pokazuje, że wpływ ten szybko wygasa: po kilku literach przewidywania z obu stanów zbiegają do rozkładu stacjonarnego, co jest właśnie „zapominaniem” stanu początkowego.
Na co uważać. Przy odstępie 2 model przecenia oscylację: przewiduje 0.509 po samogłosce, a tekst daje 0.426. Łańcuch pierwszego rzędu nie widzi np. tego, że w polskiej pisowni „i” często tylko zmiękcza spółgłoskę („cię”, „się”), więc podział liter na dwa stany jest uproszczeniem. Fragment jest też krótki (1440 liter wobec 20 000 u Markowa), więc częstości w panelu B wahają się o kilka punktów procentowych.
Podpis do pracy:
Gdzie spotkasz Markowa w swojej pracy
Wszędzie tam, gdzie badani przechodzą między stanami w kolejnych pomiarach albo gdzie obserwacje nie są niezależne. W praktyce:
- przejścia między kategoriami w kolejnych falach badania opisujesz macierzą przejść – sposób jej szacowania i testy pokazuje hasło łańcuch Markowa;
- gdy stany są nieobserwowalne, a widzisz tylko ich skutki (np. nastrój w dzienniczku), sięgasz po ukryty model Markowa;
- w analizie ścieżek klientów łańcuch przypisuje zasługi kanałom – zob. wpis Atrybucja kanałów: łańcuch Markowa;
- w każdej pracy, w której średnia z zależnych obserwacji (np. dzień po dniu) ma przybliżać wartość oczekiwaną, korzystasz z myśli z 1906 r.: zależność nie przekreśla prawa wielkich liczb, ale zmienia jego tempo.
Spory, mity i trudne strony
- Spór z Niekrasowem. Paweł Niekrasow (1853–1924) twierdził w 1902 r., że prawo wielkich liczb wymaga niezależności (parami) zmiennych. Seneta (1996) pokazuje, że praca Markowa z 1906 r. była odpowiedzią na to twierdzenie, a sama teza Niekrasowa wiązała się z teologiczną doktryną wolnej woli, popularną wtedy wśród części matematyków moskiewskich. Według Seneta (2013) Niekrasow używał statystyki także jako narzędzia propagandy władz carskich i Cerkwi; spór obu uczonych był ostry również osobiście.
- Matematyka czy statystyka? Markow bronił ścisłości rachunku; po jubileuszu 1913 r. pisał Czuprowowi, że ten w swoim referacie wysunął zastosowania prawa wielkich liczb, które wydały mu się wątpliwe (Seneta, 2013). Prawo wielkich liczb było dla niego twierdzeniem matematycznym, które odzwierciedla prawidłowości statystyczne, ale ich nie wyjaśnia.
- Droga na Zachód. Link (2006) śledzi, jak wolno idee Markowa docierały do Europy Zachodniej i Ameryki Północnej.
Łańcuch liter w R
Kod zamienia pierwsze 40 wersów „Pana Tadeusza” w ciąg samogłosek i spółgłosek, liczy tabelę przejść, macierz przejść, rozkład stacjonarny i test chi-kwadrat niezależności, porównuje potęgi macierzy przejść z częstościami w tekście, a na końcu rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. Łańcuch samogłoska/spółgłoska: rysunek 2
Kod R rysunku 2
# Andriej Markow: łańcuch samogłoska/spółgłoska na początku „Pana Tadeusza” (A. Mickiewicz, domena publiczna)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(samogloska = "#D55E00", spolgloska = "#0072B2", tlo = "grey55")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# Księga I, w. 1–40, według wydania Wolnych Lektur
tekst <- c(
  "Litwo! Ojczyzno moja! ty jesteś jak zdrowie;", "Ile cię trzeba cenić, ten tylko się dowie,",
  "Kto cię stracił. Dziś piękność twą w całej ozdobie", "Widzę i opisuję, bo tęsknię po tobie.",
  "Panno święta, co Jasnej bronisz Częstochowy", "I w Ostrej świecisz Bramie! Ty, co gród zamkowy",
  "Nowogródzki ochraniasz z jego wiernym ludem!", "Jak mnie dziecko do zdrowia powróciłaś cudem",
  "(Gdy od płaczącej matki, pod Twoją opiekę", "Ofiarowany, martwą podniosłem powiekę;",
  "I zaraz mogłem pieszo, do Twych świątyń progu", "Iść za wrócone życie podziękować Bogu),",
  "Tak nas powrócisz cudem na Ojczyzny łono.", "Tymczasem przenoś moją duszę utęsknioną",
  "Do tych pagórków leśnych, do tych łąk zielonych,", "Szeroko nad błękitnym Niemnem rozciągnionych;",
  "Do tych pól malowanych zbożem rozmaitem,", "Wyzłacanych pszenicą, posrebrzanych żytem;",
  "Gdzie bursztynowy świerzop, gryka jak śnieg biała,", "Gdzie panieńskim rumieńcem dzięcielina pała,",
  "A wszystko przepasane jakby wstęgą, miedzą", "Zieloną, na niej z rzadka ciche grusze siedzą.",
  "Śród takich pól przed laty, nad brzegiem ruczaju,", "Na pagórku niewielkim, we brzozowym gaju,",
  "Stał dwór szlachecki, z drzewa, lecz podmurowany;", "Świeciły się z daleka pobielane ściany,",
  "Tym bielsze, że odbite od ciemnej zieleni", "Topoli, co go bronią od wiatrów jesieni.",
  "Dom mieszkalny niewielki, lecz zewsząd chędogi,", "I stodołę miał wielką, i przy niej trzy stogi",
  "Użątku, co pod strzechą zmieścić się nie może.", "Widać, że okolica obfita we zboże,",
  "I widać z liczby kopic, co wzdłuż i wszerz smugów", "Świecą gęsto jak gwiazdy, widać z liczby pługów",
  "Orzących wcześnie łany ogromne ugoru,", "Czarnoziemne, zapewne należne do dworu,",
  "Uprawne dobrze na kształt ogrodowych grządek:", "Że w tym domu dostatek mieszka i porządek.",
  "Brama na wciąż otwarta przechodniom ogłasza,", "Że gościnna, i wszystkich w gościnę zaprasza.")
# Tylko litery (Markow też liczył litery), bez spacji i interpunkcji, jako jeden ciąg; samogłoski w pisowni: a ą e ę i o ó u y
litery <- strsplit(gsub("[^[:alpha:]]", "", tolower(paste(tekst, collapse = ""))), "")[[1]]
stan <- factor(ifelse(litery %in% c("a", "ą", "e", "ę", "i", "o", "ó", "u", "y"), "S", "Z"), levels = c("S", "Z"))  # S – samogłoska, Z – spółgłoska
n <- length(stan)
c(liter = n, samoglosek = sum(stan == "S"))
round(prop.table(table(stan)), 4)

# Tabela przejść: litera t (wiersze) × litera t + 1 (kolumny) i macierz przejść P
przejscia <- table(teraz = stan[-n], potem = stan[-1])
przejscia
P <- prop.table(przejscia, 1)
round(P, 4)
# Rozkład stacjonarny: pi = pi P (dla dwóch stanów wzór zamknięty)
pi_stac <- c(S = P["Z", "S"], Z = P["S", "Z"]) / (P["Z", "S"] + P["S", "Z"])
round(pi_stac, 4)
# Czy następna litera zależy od obecnej? Test chi-kwadrat niezależności tabeli przejść
test <- chisq.test(przejscia, correct = FALSE)
round(c(chi2 = unname(test$statistic), df = unname(test$parameter), p = test$p.value), 4)

# Przewidywanie na k liter naprzód: P^k z łańcucha a częstości w tekście (litera t + k po samogłosce / spółgłosce)
Pm <- unclass(P)
kroki <- 1:8
model <- t(sapply(kroki, function(k) { Pk <- diag(2); for (i in seq_len(k)) Pk <- Pk %*% Pm; Pk[, "S"] }))
tekst_k <- t(sapply(kroki, function(k) tapply(stan[(1 + k):n] == "S", stan[1:(n - k)], mean)))
porown <- data.frame(k = kroki, model_po_S = model[, 1], tekst_po_S = tekst_k[, "S"],
                     model_po_Z = model[, 2], tekst_po_Z = tekst_k[, "Z"])
print(round(porown, 3), row.names = FALSE)

# Rysunek 2A: szansa samogłoski zależnie od poprzedniej litery
dA <- data.frame(warunek = factor(c("po samogłosce", "po spółgłosce", "bez warunku"),
                                  levels = c("po samogłosce", "po spółgłosce", "bez warunku")),
                 p = c(P["S", "S"], P["Z", "S"], mean(stan == "S")),
                 n = c(sum(przejscia["S", ]), sum(przejscia["Z", ]), n),
                 typ = c("S", "Z", "brak"))
pA <- ggplot(dA, aes(warunek, p, fill = typ)) +
  geom_col(width = 0.6, colour = "black") +
  geom_text(aes(label = sprintf("%.3f\n(n = %d)", p, n)), vjust = -0.25, size = 3.5, lineheight = 0.9) +
  scale_fill_manual(values = c(S = kol[["samogloska"]], Z = kol[["spolgloska"]], brak = kol[["tlo"]]), guide = "none") +
  scale_y_continuous(limits = c(0, 0.85), breaks = seq(0, 0.8, 0.2)) +
  labs(title = "A. Szansa, że następna litera to samogłoska", x = NULL, y = "Prawdopodobieństwo") +
  motyw
# Rysunek 2B: P^k z łańcucha (linie) a częstości w tekście (punkty)
dB <- rbind(data.frame(k = kroki, p = porown$model_po_S, start = "po samogłosce", zrodlo = "łańcuch Markowa (P^k)"),
            data.frame(k = kroki, p = porown$tekst_po_S, start = "po samogłosce", zrodlo = "tekst"),
            data.frame(k = kroki, p = porown$model_po_Z, start = "po spółgłosce", zrodlo = "łańcuch Markowa (P^k)"),
            data.frame(k = kroki, p = porown$tekst_po_Z, start = "po spółgłosce", zrodlo = "tekst"))
pB <- ggplot(dB, aes(k, p, colour = start, shape = start)) +
  geom_hline(yintercept = pi_stac[["S"]], linetype = "dotted", colour = "grey40") +
  geom_line(data = subset(dB, zrodlo != "tekst"), linewidth = 0.9) +
  geom_point(data = subset(dB, zrodlo == "tekst"), size = 2.8, stroke = 1.1) +
  annotate("text", x = 8, y = pi_stac[["S"]] - 0.045, label = sprintf("rozkład stacjonarny %.3f", pi_stac[["S"]]),
           hjust = 1, size = 3.3, colour = "grey30") +
  scale_colour_manual(values = c("po samogłosce" = kol[["samogloska"]], "po spółgłosce" = kol[["spolgloska"]]), name = "Litera t:") +
  scale_shape_manual(values = c("po samogłosce" = 21, "po spółgłosce" = 22), name = "Litera t:") +
  scale_x_continuous(breaks = kroki) +
  labs(title = "B. Samogłoska k liter dalej: model (linie) i tekst (punkty)", x = "Odstęp k (litery)",
       y = "Prawdopodobieństwo samogłoski") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.35))
p2
Wynik w R
     liter samoglosek
      1440        592
stan
     S      Z
0.4111 0.5889
     potem
teraz   S   Z
    S 101 490
    Z 491 357
     potem
teraz      S      Z
    S 0.1709 0.8291
    Z 0.5790 0.4210
     S      Z
0.4112 0.5888
    chi2       df        p
239.5516   1.0000   0.0000
 k model_po_S tekst_po_S model_po_Z tekst_po_Z
 1      0.171      0.171      0.579      0.579
 2      0.509      0.426      0.343      0.400
 3      0.371      0.426      0.439      0.401
 4      0.428      0.412      0.400      0.411
 5      0.405      0.395      0.416      0.422
 6      0.414      0.424      0.409      0.402
 7      0.410      0.402      0.412      0.417
 8      0.412      0.433      0.411      0.396
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Andriej Markow, 1856–1922 – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1856, 1898, 1906, 1910, 1913, 1913.9, 1922, 1924),
  opis = c("urodził się", "początek sporów\nz Niekrasowem", "prawo wielkich liczb\ndla zmiennych zależnych\n(pierwszy łańcuch)",
           "początek korespondencji\nz Czuprowem", "styczeń: wykład o literach\n„Eugeniusza Oniegina”",
           "jubileusz 200 lat\nprawa wielkich liczb;\n3. wyd. „Rachunku prawdop.”",
           "zmarł", "4. wydanie\n(pośmiertne)"),
  rodzaj = c("życie", "kontekst", "publikacja", "kontekst", "publikacja", "publikacja", "życie", "publikacja"),
  y = c(0.55, -0.55, 0.5, -1.15, 1.15, -0.45, 0.5, 0.5))
zdarzenia$wyrownanie <- c(0.5, 0.5, 0.8, 0.6, 0.5, 0, 0.9, 0.1)
ksztalty <- c("życie" = 21, "publikacja" = 23, "kontekst" = 24)
kolory <- c("życie" = "grey40", "publikacja" = "#D55E00", "kontekst" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = y), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 4, colour = "black") +
  geom_text(aes(y = y + 0.07 * sign(y), label = paste0(floor(rok), "\n", opis), vjust = ifelse(y > 0, 0, 1), hjust = wyrownanie),
            size = 3.4, lineheight = 0.9) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1850, 1937), breaks = seq(1850, 1930, by = 10)) +
  scale_y_continuous(limits = c(-1.75, 1.75)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tabela przejść i test – funkcje table(), prop.table() i chisq.test() z pakietów base i stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Andriej Markow?
Rosyjskim matematykiem (1856–1922), członkiem Akademii Nauk w Petersburgu i – obok Lapunowa – najwybitniejszym uczniem Czebyszewa. Zajmował się m.in. prawem wielkich liczb i centralnym twierdzeniem granicznym; jego nazwisko noszą łańcuchy Markowa i nierówność Markowa.
Po co Markow wymyślił łańcuchy?
Żeby obalić twierdzenie Pawła Niekrasowa, że prawo wielkich liczb wymaga niezależności zmiennych. W pracy z 1906 r. zbudował ciąg zależnych zmiennych – skończony, jednorodny łańcuch – i pokazał, że jego średnia także się stabilizuje (Seneta, 1996, 2013).
Co Markow liczył w „Eugeniuszu Onieginie”?
Następstwo samogłosek i spółgłosek w 20 000 rosyjskich liter z pierwszego rozdziału i szesnastu strof drugiego. Wyniki przedstawił 23 stycznia 1913 r. w Akademii Nauk w Petersburgu; był to pierwszy przypadek zastosowania jego teorii do danych empirycznych.
Czym jest nierówność Markowa?
To ograniczenie P(U ≥ u) ≤ E(U)/u dla nieujemnej zmiennej U i dodatniego u: zmienna nieujemna rzadko przekracza wielokrotność swojej średniej. W podręczniku Markowa z 1913 r. służy jako lemat do wyprowadzenia nierówności Bienaymégo–Czebyszewa.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Link, D. (2006). Chains to the West: Markov’s theory of connected events and its transmission to Western Europe. Science in Context, 19(4), 561–589. https://doi.org/10.1017/s0269889706001062
- Markov, A. A. (2006). An example of statistical investigation of the text Eugene Onegin concerning the connection of samples in chains. Science in Context, 19(4), 591–600. https://doi.org/10.1017/s0269889706001074
- Seneta, E. (1996). Markov and the birth of chain dependence theory. International Statistical Review, 64(3), 255–263. https://doi.org/10.2307/1403785
- Seneta, E. (2013). A tricentenary history of the law of large numbers. Bernoulli, 19(4), 1088–1121. https://doi.org/10.3150/12-bejsp12 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{link2006chains, author={Link, David}, title={{Chains to the West: Markov’s theory of connected events and its transmission to Western Europe}}, journal={Science in Context}, year={2006}, volume={19}, number={4}, pages={561--589}, doi={10.1017/s0269889706001062}}@article{markov2006example, author={Markov, A. A.}, title={{An example of statistical investigation of the text Eugene Onegin concerning the connection of samples in chains}}, journal={Science in Context}, year={2006}, volume={19}, number={4}, pages={591--600}, doi={10.1017/s0269889706001074}}@article{seneta1996markov, author={Seneta, Eugene}, title={{Markov and the birth of chain dependence theory}}, journal={International Statistical Review}, year={1996}, volume={64}, number={3}, pages={255--263}, doi={10.2307/1403785}}@article{seneta2013tricentenary, author={Seneta, Eugene}, title={{A tricentenary history of the law of large numbers}}, journal={Bernoulli}, year={2013}, volume={19}, number={4}, pages={1088--1121}, doi={10.3150/12-bejsp12}}