Co to jest wykres GOSH?
Wykres GOSH (ang. graphical display of study heterogeneity) to wykres rozrzutu, na którym każdy punkt jest osobną metaanalizą jednego podzbioru badań. Przy k badaniach podzbiorów jest 2k − 1, czyli 1023 dla dziesięciu badań. Na osi poziomej leży efekt łączny podzbioru, a na pionowej miara heterogeniczności, zwykle I². Olkin, Dahabreh i Trikalinos (2012) zaproponowali go jako narzędzie eksploracyjne: ma pomóc badać heterogeniczność, wskazywać badania wpływowe i podsuwać hipotezy o podgrupach.
Jak czytać wykres GOSH
- Jedna zwarta chmura – wynik nie zależy od tego, które badania wejdą do analizy.
- Dwie lub więcej chmur – w zbiorze są badania, których obecność przesuwa efekt i podnosi I². Pokoloruj punkty według tego, czy podzbiór zawiera dane badanie. Jeśli kolor pokrywa się z chmurami, znalazłeś badanie odpowiedzialne za podział.
- Pas punktów przy I² = 0 – to głównie podzbiory z jednym lub dwoma badaniami, w których heterogeniczności praktycznie nie da się oszacować. Nie traktuj ich jako „zgodnych” wyników.
Przykład
W symulowanej metaanalizie 10 badań porównujących grupę z treningiem i grupę kontrolną efekt wyrażono jako d Cohena. Prawdziwe efekty dziewięciu badań losowano wokół 0.30, a efekt badania 7 ustawiono ręcznie na 1.20, żeby podział chmury był wyraźny; ziarna (762) nie zmieniano. Model efektów losowych dla wszystkich badań dał d = 0.42 i I² = 66%. Bez badania 7 efekt spadł do d = 0.31, a I² do 29%. Wśród podzbiorów z co najmniej trzema badaniami mediana I² wyniosła 74% dla podzbiorów z badaniem 7 i 25% dla podzbiorów bez niego.
Na rysunku
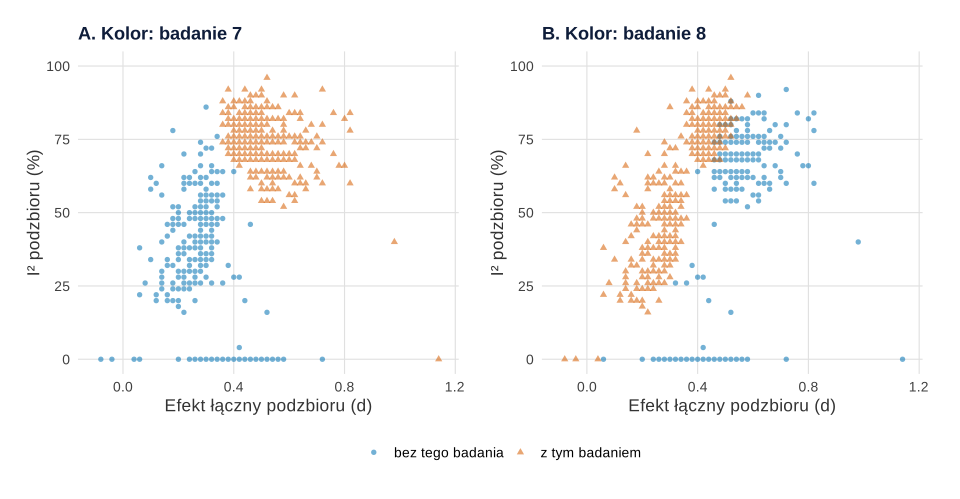
set.seed(762)).Co widać. W panelu A punkty z badaniem 7 (trójkąty) tworzą osobną chmurę: większy efekt łączny i I² zwykle powyżej 50%. Podzbiory bez tego badania (koła) leżą niżej i bliżej d = 0.3. W panelu B te same punkty pokolorowano według badania 8, które ma najniższy wynik (d = −0.08). Kolor przecina obie chmury, więc to nie badanie 8 dzieli zbiór, choć jego obecność też obniża efekt i podnosi I² (mediana 70% wobec 58%).
Na co uważać. Wykres nie mówi, dlaczego badanie 7 odstaje (inna populacja, inna procedura, błąd w danych) ani czy należy je usunąć. Podział chmury to sygnał, żeby wrócić do opisu badania, a nie dowód, że jest „złe”. Punkty na rysunku zaokrąglono do siatki 0.02 × 2 punkty procentowe i powtarzające się narysowano raz, żeby plik był lekki; liczby w tekście liczono bez zaokrągleń.
Podpis do pracy:
Jak opisać w pracy
Wykres GOSH opisz w części o analizie wrażliwości, razem z wynikiem bez wskazanego badania. Główny wynik raportuj dla zbioru ustalonego przed analizą.
Na co uważać
Wykres GOSH jest narzędziem eksploracyjnym (Olkin i in., 2012) i nie zastępuje diagnostyki pojedynczych badań. Viechtbauer i Cheung (2010) przenieśli na metaanalizę diagnostykę obserwacji odstających i wpływowych znaną z regresji – w pakiecie metafor daje ją funkcja influence(), a jej wyniki warto podać obok wykresu. Wyłączenie badania tylko dlatego, że „psuje” heterogeniczność, to decyzja podjęta po obejrzeniu danych; zgłoś ją jako analizę wrażliwości, a nie nowy wynik główny.
Liczba podzbiorów rośnie wykładniczo: przy 20 badaniach jest ich ponad milion i metafor losuje wtedy ich próbkę, więc obraz staje się przybliżony. Prostszy obraz wpływu każdego badania na heterogeniczność i wynik daje wykres Baujata, a wyniki badań z osobna – wykres lasu. Więcej rysunków metaanalizy pokazuje wpis metaanaliza w obrazkach.
Wykres GOSH w R
Funkcja gosh() z pakietu metafor (Viechtbauer, 2010) dopasowuje ten sam model co rma() do każdego podzbioru badań i zwraca tabelę wyników ($res) oraz macierz, które badania weszły do podzbioru ($incl). Gotowy wykres daje plot(g, out = 7); tu rysujemy go w ggplot2. Rysunek na stronie powstał z obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Wszystkie podzbiory 10 badań i ich wykres
R
# Wykres GOSH: metaanaliza każdego podzbioru 10 badań (dane symulowane)
suppressPackageStartupMessages({library(metafor); library(ggplot2); library(patchwork)})
kol <- c("z tym badaniem" = "#D55E00", "bez tego badania" = "#0072B2")   # Okabe–Ito; różnią się też kształtem
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
set.seed(762)                                       # 10 badań, d Cohena
k <- 10
n <- round(runif(k, 20, 80))                        # liczebność grupy
theta <- rnorm(k, 0.30, 0.05); theta[7] <- 1.20     # badanie 7 odstaje (ustawione ręcznie)
vi <- 2 / n + theta^2 / (4 * n)
yi <- rnorm(k, theta, sqrt(vi))
dat <- data.frame(badanie = 1:k, n, yi = round(yi, 3), vi = round(vi, 4))
m10 <- rma(yi, vi, data = dat)                      # model efektów losowych, REML
m9 <- rma(yi, vi, data = dat, subset = -7)
g <- gosh(m10, progbar = FALSE)                     # 2^10 − 1 = 1023 podzbiory
wg <- function(j) data.frame(g$res, grupa = ifelse(g$incl[, j], "z tym badaniem", "bez tego badania"))
rysuj <- function(j, tytul) {
  d <- wg(j)
  d <- unique(transform(d, estimate = round(estimate / 0.02) * 0.02, I2 = round(I2 / 2) * 2)[, c("estimate", "I2", "grupa")])
  ggplot(d, aes(estimate, I2, colour = grupa, shape = grupa)) +   # punkty zaokrąglone do siatki 0.02 × 2 (lżejszy plik)
    geom_point(size = 1.5, alpha = 0.55) +
    scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(16, 17), name = NULL) +
    coord_cartesian(xlim = c(-0.1, 1.15), ylim = c(0, 100)) +
    labs(title = tytul, x = "Efekt łączny podzbioru (d)", y = "I² podzbioru (%)")
}
p1 <- (rysuj(7, "A. Kolor: badanie 7") + rysuj(8, "B. Kolor: badanie 8")) +
  plot_layout(guides = "collect") & motyw
print(dat)
round(c(d_10 = coef(m10)[[1]], I2_10 = m10$I2, d_9 = coef(m9)[[1]], I2_9 = m9$I2), 2)
nrow(g$res)
mediany <- function(j) { d <- wg(j)[g$res$k >= 3, ]
  round(sapply(split(d[, c("estimate", "I2")], d$grupa), function(x) c(d = median(x$estimate), I2 = median(x$I2))), 2) }
mediany(7)
mediany(8)
p1
Wynik w R
   badanie  n     yi     vi
1        1 28  0.449 0.0723
2        2 73  0.296 0.0279
3        3 24  0.065 0.0840
4        4 50  0.476 0.0405
5        5 28  0.728 0.0723
6        6 29  0.389 0.0697
7        7 79  1.139 0.0299
8        8 77 -0.084 0.0262
9        9 30  0.398 0.0676
10      10 28  0.315 0.0721
 d_10 I2_10   d_9  I2_9
 0.42 66.02  0.31 28.70
[1] 1023
   bez tego badania z tym badaniem
d              0.32           0.50
I2            24.81          74.46
   bez tego badania z tym badaniem
d              0.50           0.37
I2            57.55          69.84
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- metafor (wersja 5.2-1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Ile podzbiorów badań pokazuje wykres GOSH?
Przy k badaniach jest 2k − 1 niepustych podzbiorów: 1023 dla 10 badań i ponad milion dla 20. Przy bardzo wielu badaniach funkcja gosh() z pakietu metafor losuje próbkę podzbiorów.
Co oznaczają dwie chmury punktów na wykresie GOSH?
Że wynik zależy od obecności jednego lub kilku badań. Pokoloruj punkty według tego, czy podzbiór zawiera dane badanie – badanie, którego kolor pokrywa się z chmurami, jest kandydatem do sprawdzenia i do analizy wrażliwości.
Czy na podstawie wykresu GOSH można usunąć badanie z metaanalizy?
Nie jako jedynej podstawy. Wykres jest eksploracyjny: wskazuje badanie do sprawdzenia, ale nie wyjaśnia, dlaczego odstaje. Główny wynik raportuj dla pełnego zbioru, a wynik bez badania podaj jako analizę wrażliwości.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Metaanaliza – wizualizacja na obrazkach
Wykres lasu w dwóch modelach, I² ≈ 0/50/80%, przedział predykcji, lejek z selekcją i 1000 metaanaliz z błędem publikacji – pięć rysunków z kodem R.
Czytaj →PoradnikMetaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Olkin, I., Dahabreh, I. J., & Trikalinos, T. A. (2012). GOSH – a graphical display of study heterogeneity. Research Synthesis Methods, 3(3), 214–223. https://doi.org/10.1002/jrsm.1053
- Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03 ● Otwarty dostęp
- Viechtbauer, W., & Cheung, M. W.-L. (2010). Outlier and influence diagnostics for meta-analysis. Research Synthesis Methods, 1(2), 112–125. https://doi.org/10.1002/jrsm.11
Cytowania BibTeX
@article{olkin2012gosh, author={Olkin, Ingram and Dahabreh, Issa J. and Trikalinos, Thomas A.}, title={{GOSH – a graphical display of study heterogeneity}}, journal={Research Synthesis Methods}, year={2012}, volume={3}, number={3}, pages={214--223}, doi={10.1002/jrsm.1053}}@article{viechtbauer2010conducting, author={Viechtbauer, Wolfgang}, title={{Conducting meta-analyses in R with the metafor package}}, journal={Journal of Statistical Software}, year={2010}, volume={36}, number={3}, pages={1--48}, doi={10.18637/jss.v036.i03}}@article{viechtbauer2010outlier, author={Viechtbauer, Wolfgang and Cheung, Mike W.-L.}, title={{Outlier and influence diagnostics for meta-analysis}}, journal={Research Synthesis Methods}, year={2010}, volume={1}, number={2}, pages={112--125}, doi={10.1002/jrsm.11}}