Co to jest technika zmiennej markerowej?
Technika zmiennej markerowej (ang. marker variable technique) to statystyczna korekta wspólnej wariancji metody (CMV) w badaniach przekrojowych. Lindell i Whitney (2001) zaproponowali, by do ankiety dołączyć zmienną markerową: mierzoną tą samą metodą co zmienne badane, ale teoretycznie z nimi niezwiązaną. Jej korelacja z nimi szacuje, ile związku wnosi sama metoda, a korekta przypomina korelację cząstkową. W odróżnieniu od testu Harmana, który próbuje CMV tylko wykryć, marker pozwala ją skorygować.
Wzór korekty
Skorygowana korelacja to rA = (rXY − rM)/(1 − rM), gdzie rXY to zwykła korelacja Pearsona, a rM – korelacja markera ze zmiennymi badanymi; często bierze się najmniejszą z nich. Istotność sprawdza test t = rA/√[(1 − rA2)/(n − 3)]. Korekta zakłada, że metoda działa na wszystkie zmienne jednakowo.
Wersja CFA
Williams, Hartman i Cavazotte (2010) przenieśli technikę do konfirmacyjnej analizy czynnikowej. Czynnik metody ładuje pozycje markera i pozycje badanych skal, a porównanie modeli z czynnikiem metody i bez niego pokazuje, czy CMV istnieje i jak zmienia korelacje między czynnikami. Autorzy podkreślają, że kluczowy jest teoretycznie uzasadniony dobór markera.
Przykład
300 osób wypełniło jedną ankietę: skale X i Y oraz marker o innej treści, po 3 pozycje; na wszystkie pozycje działał wspólny czynnik metody (dane symulowane). Korelacja X–Y wyniosła .41, marker korelował z X i Y na poziomie .26 i .20. Korekta: rA = (.41 − .20)/(1 − .20) = .26, t(297) = 4.71, p < .001 – blisko korelacji bez wpływu metody (.27, znanej tylko w symulacji). W CFA korelacja czynników spadła z .49 do .28 (prawdziwa: .30), a czynnik metody poprawił dopasowanie, Δχ²(1) = 24.39, p < .001.
Na rysunku
Jeden przykład nie pokazuje, kiedy korekta działa. Rysunek 1 zestawia średnie wyniki 500 symulowanych ankiet (n = 300) na każdy poziom wpływu metody. Model jest taki jak w przykładzie: skale X, Y i marker po 3 pozycje, prawdziwa korelacja czynników .30. Ręcznie ustawiono ładunki metody (0–.5) i dwa warianty markera; ziarno (7181) ustalono raz i nie zmieniano.
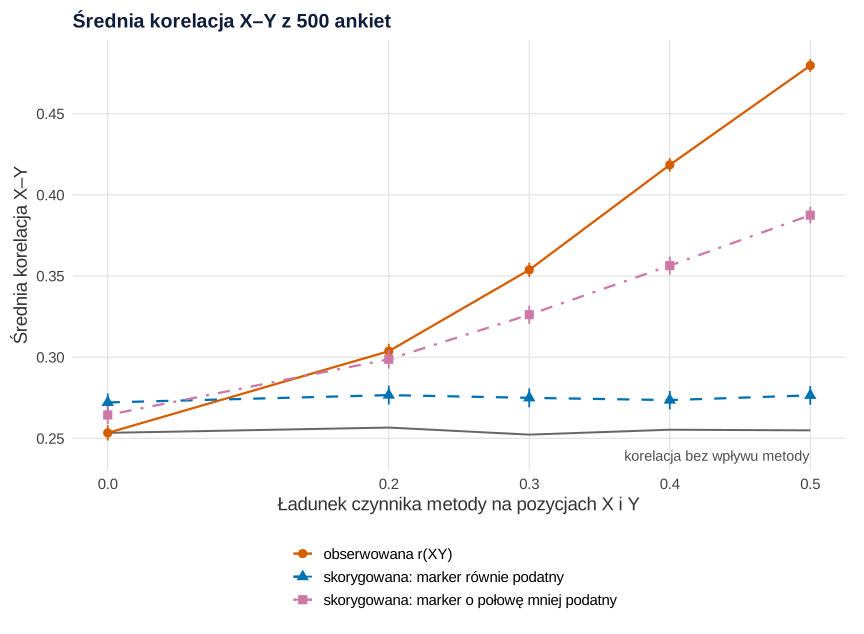
set.seed(7181)).Co widać. Bez korekty korelacja rośnie z .253 do .480, gdy ładunek metody rośnie od 0 do .5, choć związek bez wpływu metody stoi w miejscu (około .255). Gdy marker jest tak samo podatny na metodę jak X i Y, korekta usuwa ten przyrost: przy ładunku .5 daje .276. Gdy marker reaguje na metodę o połowę słabiej, korekta usuwa tylko część zawyżenia i zostawia .388. Odcinki ±1.96 błędu Monte Carlo (około ±.006) są krótsze niż różnice między liniami.
Na co uważać. Niebieska linia leży o około .02 nad szarą także wtedy, gdy metoda w ogóle nie działa (.272 wobec .253). To skutek wyboru najmniejszej z korelacji z markerem: przy zerowym wpływie metody jest ona zwykle lekko ujemna, więc „korekta” podnosi wynik. Rysunek nie pokazuje też przypadku, w którym marker jest związany z treścią X lub Y – wtedy korekta usuwa prawdziwy związek. Jak bardzo zawyżona korelacja wygląda na zwykłym wykresie rozrzutu, pokazuje wpis korelacje na wykresie.
Podpis do pracy:
Kod rysunku liczy też tabelę średnich z błędem Monte Carlo (wykonanie trwa kilka sekund). Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Korekta Lindella i Whitneya w 500 symulowanych ankietach na każdy poziom wpływu metody
library(ggplot2)

# Paleta Okabe–Ito i prosty motyw
kol <- c("obserwowana r(XY)" = "#D55E00", "skorygowana: marker równie podatny" = "#0072B2",
         "skorygowana: marker o połowę mniej podatny" = "#CC79A7")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", legend.direction = "vertical",
        plot.background = element_rect(fill = "white", colour = NA))

n <- 300                              # osób w jednej ankiecie
R <- 500                              # ankiet na każdy poziom wpływu metody
met_poz <- c(0, .2, .3, .4, .5)       # ładunek metody na pozycjach X i Y (ustawiony ręcznie)
lam <- .7                             # ładunek treści każdej pozycji; prawdziwa korelacja X–Y = .30
sd_bl <- sqrt(.26)                    # SD błędu pozycji, takie samo przy każdym poziomie metody

# Jedna ankieta: skale X, Y i marker po 3 pozycje; marker ma ładunek metody met_m
ankieta <- function(met, met_m) {
  eta <- MASS::mvrnorm(n, c(0, 0), matrix(c(1, .30, .30, 1), 2))
  metoda <- rnorm(n); g <- rnorm(n)                     # czynnik metody i treść markera
  skala <- function(f, m) rowMeans(sapply(1:3, function(i) lam * f + m * metoda + rnorm(n, 0, sd_bl)))
  X <- skala(eta[, 1], met); Y <- skala(eta[, 2], met); M <- skala(g, met_m)
  r_XY <- cor(X, Y)
  r_M <- min(cor(X, M), cor(Y, M))                      # najmniejsza korelacja z markerem
  c(r_XY = r_XY, r_A = (r_XY - r_M) / (1 - r_M),
    r_bez = cor(X - met * metoda, Y - met * metoda))    # korelacja bez metody (znana tylko w symulacji)
}

set.seed(7181)                        # ziarno ustalone raz
wyniki <- do.call(rbind, lapply(met_poz, function(met) {
  rown <- t(replicate(R, ankieta(met, met)))            # marker tak samo podatny na metodę
  pol  <- t(replicate(R, ankieta(met, met / 2)))        # marker o połowę słabiej podatny
  data.frame(ladunek_metody = met,
             miara = c(names(kol), "bez metody (prawda)"),
             srednia = c(mean(rown[, "r_XY"]), mean(rown[, "r_A"]), mean(pol[, "r_A"]), mean(rown[, "r_bez"])),
             bladMC = c(sd(rown[, "r_XY"]), sd(rown[, "r_A"]), sd(pol[, "r_A"]), sd(rown[, "r_bez"])) / sqrt(R))
}))
print(transform(wyniki, srednia = round(srednia, 3), bladMC = round(bladMC, 4)), row.names = FALSE)

prawda <- wyniki[wyniki$miara == "bez metody (prawda)", ]
linie  <- wyniki[wyniki$miara != "bez metody (prawda)", ]
linie$miara <- factor(linie$miara, levels = names(kol))
p <- ggplot(linie, aes(ladunek_metody, srednia, colour = miara, shape = miara, linetype = miara)) +
  geom_line(data = prawda, aes(ladunek_metody, srednia), inherit.aes = FALSE, colour = "grey40", linewidth = 0.7) +
  annotate("text", x = .5, y = mean(prawda$srednia) - .012, label = "korelacja bez wpływu metody",
           hjust = 1, vjust = 1, size = 3.8, colour = "grey30") +
  geom_line(linewidth = 0.8) + geom_point(size = 2.8) +
  geom_errorbar(aes(ymin = srednia - 1.96 * bladMC, ymax = srednia + 1.96 * bladMC), width = 0, linetype = 1) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotdash"), name = NULL) +
  scale_x_continuous(breaks = met_poz) +
  labs(title = "Średnia korelacja X–Y z 500 ankiet", x = "Ładunek czynnika metody na pozycjach X i Y",
       y = "Średnia korelacja X–Y") +
  motyw
p
Wynik w R
 ladunek_metody                                      miara srednia bladMC
            0.0                          obserwowana r(XY)   0.253 0.0024
            0.0         skorygowana: marker równie podatny   0.272 0.0028
            0.0 skorygowana: marker o połowę mniej podatny   0.264 0.0029
            0.0                        bez metody (prawda)   0.253 0.0024
            0.2                          obserwowana r(XY)   0.304 0.0024
            0.2         skorygowana: marker równie podatny   0.277 0.0029
            0.2 skorygowana: marker o połowę mniej podatny   0.299 0.0029
            0.2                        bez metody (prawda)   0.257 0.0024
            0.3                          obserwowana r(XY)   0.354 0.0022
            0.3         skorygowana: marker równie podatny   0.275 0.0030
            0.3 skorygowana: marker o połowę mniej podatny   0.326 0.0028
            0.3                        bez metody (prawda)   0.252 0.0024
            0.4                          obserwowana r(XY)   0.418 0.0021
            0.4         skorygowana: marker równie podatny   0.274 0.0029
            0.4 skorygowana: marker o połowę mniej podatny   0.356 0.0028
            0.4                        bez metody (prawda)   0.255 0.0024
            0.5                          obserwowana r(XY)   0.480 0.0020
            0.5         skorygowana: marker równie podatny   0.276 0.0029
            0.5 skorygowana: marker o połowę mniej podatny   0.388 0.0026
            0.5                        bez metody (prawda)   0.255 0.0024
Jak opisać w pracy
Na co uważać
- Marker dobierz przed badaniem. Powinien być podatny na te same źródła błędu, np. aprobatę społeczną czy ten sam format skali Likerta.
- Marker nie może być związany z konstruktami. Inaczej korekta usunie też prawdziwy związek.
- To nie zastępuje planu badania. Najlepszą ochroną są zabezpieczenia proceduralne (Podsakoff i in., 2003).
Technika zmiennej markerowej w R
Kod symuluje ankietę z czynnikiem metody, liczy korektę Lindella i Whitneya ręcznie, a potem porównuje w lavaan model CFA bez czynnika metody i z czynnikiem metody ładującym wszystkie pozycje. Liczby w tekście pochodzą z tego kodu.
Korekta korelacji i model CFA z markerem
R
set.seed(7180)
suppressPackageStartupMessages(library(lavaan))
n <- 300                                             # jedna ankieta, samoopis (dane symulowane)
eta <- MASS::mvrnorm(n, c(0, 0), matrix(c(1, .30, .30, 1), 2))   # prawdziwa korelacja X–Y = .30
metoda <- rnorm(n)                                   # wspólny czynnik metody
g <- rnorm(n)                                        # treść markera, niezwiązana z X i Y
poz <- function(f, lam = .7, met = .4) f * lam + metoda * met + rnorm(n, 0, sqrt(1 - lam^2 - met^2))
dane <- data.frame(x1 = poz(eta[, 1]), x2 = poz(eta[, 1]), x3 = poz(eta[, 1]),
                   y1 = poz(eta[, 2]), y2 = poz(eta[, 2]), y3 = poz(eta[, 2]),
                   m1 = poz(g), m2 = poz(g), m3 = poz(g))   # marker: inna treść, ta sama metoda
X <- rowMeans(dane[1:3]); Y <- rowMeans(dane[4:6]); M <- rowMeans(dane[7:9])
r <- cor(cbind(X, Y, M)); round(r, 3)
round(cor(X - .4 * metoda, Y - .4 * metoda), 3)    # korelacja bez metody (znana tylko w symulacji)
# korelacyjna technika markerowa: r_A = (r_XY - r_M) / (1 - r_M)
r_M <- min(r["X", "M"], r["Y", "M"])                 # wariant ostrożny: najmniejsza korelacja z markerem
r_A <- (r["X", "Y"] - r_M) / (1 - r_M)
t_A <- r_A / sqrt((1 - r_A^2) / (n - 3))             # test istotności skorygowanej korelacji
round(c(r_XY = r["X", "Y"], r_M = r_M, r_A = r_A, t = t_A, p = 2 * pt(-abs(t_A), n - 3)), 3)
# wersja CFA (Williams i in., 2010): czynnik metody ładuje pozycje markera oraz X i Y,
# ładunki metody równe (model Method-C), metoda nieskorelowana z czynnikami treści
bez <- 'X =~ x1 + x2 + x3
        Y =~ y1 + y2 + y3
        G =~ m1 + m2 + m3
        G ~~ 0*X + 0*Y'                              # treść markera z założenia niezwiązana z X i Y
z_metoda <- paste(bez, 'Metoda =~ a*m1 + a*m2 + a*m3 + a*x1 + a*x2 + a*x3 + a*y1 + a*y2 + a*y3
        Metoda ~~ 0*X + 0*Y + 0*G', sep = "\n")
fit0 <- cfa(bez, data = dane, std.lv = TRUE)
fit1 <- cfa(z_metoda, data = dane, std.lv = TRUE)
kor <- function(f) subset(standardizedSolution(f), lhs == "X" & op == "~~" & rhs == "Y")$est.std
round(c(kor_XY_bez_metody = kor(fit0), kor_XY_z_metoda = kor(fit1)), 3)
anova(fit1, fit0)                                    # czy czynnik metody poprawia dopasowanie
Wynik w R
      X     Y     M
X 1.000 0.411 0.259
Y 0.411 1.000 0.200
M 0.259 0.200 1.000
[1] 0.273
 r_XY   r_M   r_A     t     p
0.411 0.200 0.264 4.714 0.000
kor_XY_bez_metody   kor_XY_z_metoda
            0.494             0.279

Chi-Squared Difference Test

     Df    AIC    BIC  Chisq Chisq diff  RMSEA Df diff Pr(>Chisq)
fit1 25 6434.1 6508.2 26.291
fit0 26 6456.5 6526.8 50.677     24.386 0.2792       1  7.883e-07 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety lavaan i MASS). Rysunek 1 wykonano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Jak wybrać zmienną markerową?
Przed badaniem wybierz skalę o treści teoretycznie niezwiązanej z badanymi konstruktami, ale mierzoną tak samo: ten sam format odpowiedzi, to samo miejsce w ankiecie, podatność na te same tendencje odpowiedzi.
Którą korelację z markerem przyjąć jako r_M?
Często najmniejszą korelację markera ze zmiennymi badanymi, bo duża korelacja może zawierać prawdziwy związek treści. W przykładzie korelacje wyniosły .26 i .20, więc przyjęto r_M = .20.
Czym technika markerowa różni się od testu Harmana?
Test Harmana próbuje jedynie wykryć wspólną wariancję metody i robi to słabo. Technika markerowa szacuje jej wielkość i koryguje korelacje, a w wersji CFA pozwala też porównać modele z czynnikiem metody i bez niego.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Ograniczenia badania – jak je opisać
Jak znaleźć ograniczenia, ocenić kierunek i wielkość błędu, wybrać najważniejsze i opisać je konkretnie. Przykład ankiety online z liczbami z R.
Czytaj →PoradnikOdpowiedź recenzentom – wzory PL i EN
Zasady i struktura odpowiedzi oraz wzory PL/EN na 12 sytuacji: moc post hoc, korekta porównań, model mieszany, braki danych, CMV i przyznanie się do błędu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Lindell, M. K., & Whitney, D. J. (2001). Accounting for common method variance in cross-sectional research designs. Journal of Applied Psychology, 86(1), 114–121. https://doi.org/10.1037/0021-9010.86.1.114
- Podsakoff, P. M., MacKenzie, S. B., Lee, J.-Y., & Podsakoff, N. P. (2003). Common method biases in behavioral research: A critical review of the literature and recommended remedies. Journal of Applied Psychology, 88(5), 879–903. https://doi.org/10.1037/0021-9010.88.5.879
- Williams, L. J., Hartman, N., & Cavazotte, F. (2010). Method variance and marker variables: A review and comprehensive CFA marker technique. Organizational Research Methods, 13(3), 477–514. https://doi.org/10.1177/1094428110366036
Cytowania BibTeX
@article{lindell2001accounting, author={Lindell, Michael K. and Whitney, David J.}, title={{Accounting for common method variance in cross-sectional research designs}}, journal={Journal of Applied Psychology}, year={2001}, volume={86}, number={1}, pages={114--121}, doi={10.1037/0021-9010.86.1.114}}@article{podsakoff2003common, author={Podsakoff, Philip M. and MacKenzie, Scott B. and Lee, Jeong-Yeon and Podsakoff, Nathan P.}, title={{Common method biases in behavioral research: A critical review of the literature and recommended remedies}}, journal={Journal of Applied Psychology}, year={2003}, volume={88}, number={5}, pages={879--903}, doi={10.1037/0021-9010.88.5.879}}@article{williams2010method, author={Williams, Larry J. and Hartman, Nathan and Cavazotte, Flavia}, title={{Method variance and marker variables: A review and comprehensive CFA marker technique}}, journal={Organizational Research Methods}, year={2010}, volume={13}, number={3}, pages={477--514}, doi={10.1177/1094428110366036}}