Co to jest nomogram modelu regresji?
Nomogram modelu regresji to graficzny kalkulator dopasowanego modelu, najczęściej regresji logistycznej albo modelu przeżycia. Każdy predyktor ma własną oś, z której odczytuje się punkty; punkty są proporcjonalne do wkładu predyktora w predyktor liniowy (współczynnik × wartość). Suma punktów odpowiada wartości predyktora liniowego, a dolna oś przelicza ją na prawdopodobieństwo zdarzenia. Iasonos, Schrag, Raj i Panageas (2008) opisują nomogram jako sposób sprowadzenia modelu do jednej liczby dopasowanej do profilu konkretnej osoby. Nie należy go mylić z nomogramem Fagana, który przelicza prawdopodobieństwo przed testem diagnostycznym na prawdopodobieństwo po teście.
Jak czytać nomogram
- Dla każdego predyktora znajdź wartość osoby na jego osi i poprowadź pionową linię do górnej osi Punkty.
- Zsumuj punkty wszystkich predyktorów.
- Znajdź sumę na osi Suma punktów i zejdź pionowo na oś prawdopodobieństwa.
Długość osi pokazuje, jak bardzo predyktor może zmienić wynik w pokazanym zakresie wartości – to iloczyn współczynnika i zakresu, a nie sam iloraz szans. Oś odwrócona (wartości maleją w prawo) oznacza ujemny współczynnik.
Przykład
W symulowanych danych 600 pacjentów modelowano rezygnację z terapii (29.0% osób) na podstawie wieku, płci, nasilenia objawów (0–27 punktów) i wcześniejszej rezygnacji. Współczynniki symulacji ustawiono ręcznie, a nowy ośrodek ma niższy wyraz wolny (−2.1 zamiast −1.3), by pokazać złą kalibrację; ziaren (780 i 7800) nie zmieniano. W modelu każdy rok wieku zmniejszał szanse rezygnacji (OR = 0.942), każdy punkt objawów je zwiększał (OR = 1.115), a wcześniejsza rezygnacja – prawie czterokrotnie (OR = 3.870).
Na rysunku
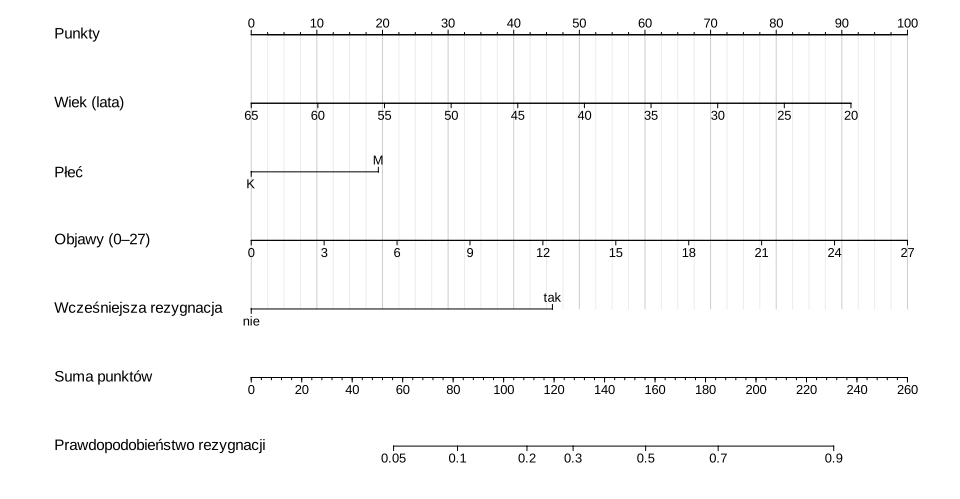
set.seed(780)).Co widać. Odczyt dla 24-letniej kobiety z 20 punktami objawów, która wcześniej przerwała terapię: wiek daje 83.3 punktu, płeć 0, objawy 74.1, wcześniejsza rezygnacja 45.9 – razem 203.2 punktu, co na dolnej osi odpowiada prawdopodobieństwu 0.800. Funkcja predict() daje dokładnie tę samą liczbę: nomogram jest tylko innym zapisem równania.
Na co uważać. Nomogram nie pokazuje niepewności – 0.800 to oszacowanie punktowe bez przedziału. Balachandran, Gonen, Smith i DeMatteo (2015) zwracają uwagę, że użytkownicy nomogramów często nie doceniają niepewności prognoz. Osie warto ograniczyć do zakresu danych (tu wiek 20–65 lat), bo inaczej nomogram zachęca do ekstrapolacji.
Podpis do pracy:
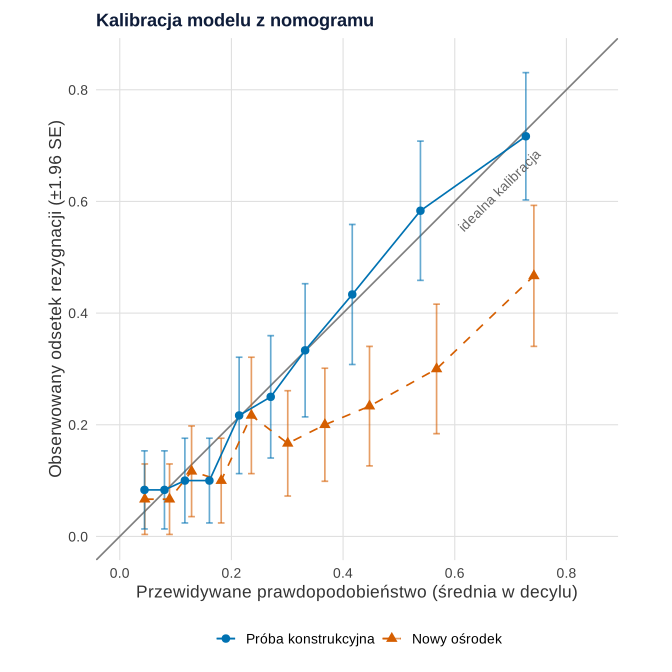
set.seed(780) i set.seed(7800)).Co widać. W próbie konstrukcyjnej średnie przewidywane prawdopodobieństwo równa się odsetkowi rezygnacji (0.290), a punkty leżą przy przekątnej. W nowym ośrodku ten sam nomogram przewiduje średnio 0.31, a rezygnuje 19.3% osób; w najwyższym decylu – 0.742 wobec 0.467. Nomogram wygląda identycznie w obu ośrodkach, ale w drugim systematycznie zawyża ryzyko.
Na co uważać. Sam nomogram nie mówi nic o trafności modelu. Trzeba go uzupełnić oceną kalibracji i dyskryminacji w niezależnych danych – Steyerberg i Vergouwe (2014) wymieniają m.in. kalibrację ogólną, nachylenie kalibracji i statystykę c. Tu AUC (pole pod krzywą ROC) spadło z 0.785 do 0.696, a wynik Briera wzrósł z 0.161 do 0.167. Walidację opisuje wpis modele predykcyjne: walidacja i kalibracja.
Podpis do pracy:
Kod obu rysunków zawiera sekcja Nomogram w R; na stronie nomogram zapisano do SVG tą samą funkcją rysuj_nomogram(), a p2 dostał tylko motyw serwisu.
Jak opisać w pracy
Na co uważać
- Nomogram zamiast walidacji. Atrakcyjny wykres nie zastępuje oceny kalibracji i dyskryminacji w nowych danych.
- Za dużo predyktorów. Każda oś to kolejny odczyt i błąd sumowania.
- Brak informacji o modelu. Podaj w pracy pełne równanie (współczynniki), bo z rysunku nie da się ich dokładnie odtworzyć.
- Prawdopodobieństwo jako pewność. Wynik 0.80 nie znaczy, że ta osoba zrezygnuje – mechanikę modelu logistycznego pokazuje wpis regresja logistyczna w obrazkach.
Nomogram w R
Kod symuluje dane, dopasowuje model funkcją lrm() z pakietu rms, rysuje nomogram funkcją nomogram(), odczytuje punkty dla jednej osoby i porównuje wynik z predict(), a potem sprawdza kalibrację w drugim, symulowanym ośrodku. Etykiety osi nadaje funkcja label() z pakietu Hmisc, ładowanego razem z rms.
Nomogram, odczyt i kalibracja
R
# Nomogram regresji logistycznej (rms) i kalibracja w nowym ośrodku
suppressPackageStartupMessages({library(rms); library(ggplot2)})
kol <- c("Próba konstrukcyjna" = "#0072B2", "Nowy ośrodek" = "#D55E00")  # Okabe–Ito
ksz <- c("Próba konstrukcyjna" = 16, "Nowy ośrodek" = 17)
lin <- c("Próba konstrukcyjna" = "solid", "Nowy ośrodek" = "dashed")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom")
symuluj <- function(n, wyraz_wolny) {               # współczynniki ustalone ręcznie
  d <- data.frame(wiek = round(runif(n, 18, 65)),
                  plec = factor(sample(c("K", "M"), n, replace = TRUE)),
                  objawy = round(pmin(27, pmax(0, rnorm(n, 13, 5)))),
                  wczesniej = factor(sample(c("nie", "tak"), n, replace = TRUE, prob = c(0.7, 0.3))))
  lp <- wyraz_wolny - 0.035 * (d$wiek - 40) + 0.2 * (d$plec == "M") +
    0.10 * (d$objawy - 13) + 0.9 * (d$wczesniej == "tak")
  d$rezygnacja <- rbinom(n, 1, plogis(lp))
  d
}
set.seed(780)                                       # próba konstrukcyjna: 600 pacjentów
d <- symuluj(600, -1.3)
label(d$wiek) <- "Wiek (lata)"; label(d$plec) <- "Płeć"            # etykiety osi nomogramu (Hmisc)
label(d$objawy) <- "Objawy (0–27)"; label(d$wczesniej) <- "Wcześniejsza rezygnacja"
dd <- datadist(d); options(datadist = "dd")
fit <- lrm(rezygnacja ~ wiek + plec + objawy + wczesniej, data = d)
print(round(cbind(b = coef(fit), OR = exp(coef(fit))), 3))
nom <- nomogram(fit, wiek = seq(20, 65, by = 5), objawy = seq(0, 27, by = 3), lp = FALSE,
                fun = plogis, funlabel = "Prawdopodobieństwo rezygnacji",
                fun.at = c(0.05, 0.1, 0.2, 0.3, 0.5, 0.7, 0.9))
rysuj_nomogram <- function() {
  par(mar = c(2, 1, 1, 1), cex = 0.95)
  plot(nom, xfrac = 0.3, lmgp = 0.2, col.grid = c("grey80", "grey92"),
       points.label = "Punkty", total.points.label = "Suma punktów")
}
rysuj_nomogram()
# Odczyt dla jednej osoby: kobieta, 24 lata, objawy 20 pkt, wcześniej rezygnowała z terapii
osoba <- data.frame(wiek = 24, plec = "K", objawy = 20, wczesniej = "tak")
pkt_dla <- function(os, v) {                        # punkty z osi nomogramu dla wartości v
  x <- os[[1]]
  if (is.numeric(x)) approx(x, os$points, v)$y else unname(os$points[x == v])
}
pkt <- setNames(mapply(pkt_dla, nom[1:4], osoba), names(osoba))
info <- attr(nom, "info")                           # sc: punkty na jednostkę predyktora liniowego
lp_z_punktow <- info$Intercept + sum(pkt) / info$sc   # Intercept: predyktor liniowy przy 0 punktów
round(c(pkt, suma = sum(pkt)), 1)
format(round(c(z_nomogramu = plogis(unname(lp_z_punktow)),
               z_predict = unname(predict(fit, osoba, type = "fitted"))), 3), nsmall = 3)
# Ten sam model w nowym ośrodku o niższym ryzyku wyjściowym
set.seed(7800)
nowy <- symuluj(600, -2.1)
oceny <- rbind(cbind(d, p = predict(fit, d, type = "fitted"), zbior = "Próba konstrukcyjna"),
               cbind(nowy, p = predict(fit, nowy, type = "fitted"), zbior = "Nowy ośrodek"))
auc <- function(p, y) mean(outer(p[y == 1], p[y == 0], ">") + 0.5 * outer(p[y == 1], p[y == 0], "=="))
podsum <- do.call(rbind, lapply(split(oceny, factor(oceny$zbior, levels = names(kol))), function(z)
  data.frame(zbior = z$zbior[1], srednie_p = mean(z$p), odsetek_obserw = mean(z$rezygnacja),
             AUC = auc(z$p, z$rezygnacja), Brier = mean((z$rezygnacja - z$p)^2))))
print(transform(podsum, srednie_p = round(srednie_p, 3), odsetek_obserw = round(odsetek_obserw, 3),
                AUC = round(AUC, 3), Brier = round(Brier, 3)), row.names = FALSE)
oceny$decyl <- ave(oceny$p, oceny$zbior, FUN = function(p) cut(rank(p), 10, labels = FALSE))
kal <- aggregate(cbind(p, rezygnacja) ~ zbior + decyl, data = oceny, FUN = mean)
kal$n <- aggregate(p ~ zbior + decyl, data = oceny, FUN = length)$p
kal$se <- sqrt(kal$rezygnacja * (1 - kal$rezygnacja) / kal$n)
kal$zbior <- factor(kal$zbior, levels = names(kol))
print(transform(kal[kal$decyl == 10, c("zbior", "p", "rezygnacja")], p = round(p, 3),
                rezygnacja = round(rezygnacja, 3)), row.names = FALSE)   # najwyższy decyl ryzyka
p2 <- ggplot(kal, aes(p, rezygnacja, colour = zbior, shape = zbior, linetype = zbior)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey50") +
  geom_errorbar(aes(ymin = pmax(0, rezygnacja - 1.96 * se), ymax = pmin(1, rezygnacja + 1.96 * se)),
                width = 0.012, linetype = "solid", alpha = 0.6) +
  geom_line() + geom_point(size = 2.6) +
  annotate("text", x = 0.68, y = 0.62, label = "idealna kalibracja", angle = 45, colour = "grey40", size = 3.6) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = ksz, name = NULL) +
  scale_linetype_manual(values = lin, name = NULL) +
  coord_equal(xlim = c(0, 0.85), ylim = c(0, 0.85)) +
  labs(title = "Kalibracja modelu z nomogramu",
       x = "Przewidywane prawdopodobieństwo (średnia w decylu)",
       y = "Obserwowany odsetek rezygnacji (±1.96 SE)")
p2 <- p2 + motyw
p2
Wynik w R
                   b    OR
Intercept     -0.715 0.489
wiek          -0.060 0.942
plec=M         0.571 1.770
objawy         0.109 1.115
wczesniej=tak  1.353 3.870
     wiek      plec    objawy wczesniej      suma
     83.3       0.0      74.1      45.9     203.2
z_nomogramu   z_predict
    "0.800"     "0.800"
               zbior srednie_p odsetek_obserw   AUC Brier
 Próba konstrukcyjna      0.29          0.290 0.785 0.161
        Nowy ośrodek      0.31          0.193 0.696 0.167
               zbior     p rezygnacja
        Nowy ośrodek 0.742      0.467
 Próba konstrukcyjna 0.727      0.717
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (model i nomogram – pakiet rms z pakietem Hmisc; rysunek kalibracji – pakiet ggplot2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- rms (wersja 8.2-1): Harrell, F. E., Jr. (2026). rms: Regression modeling strategies (R package version 8.2-1) [Computer software]. https://doi.org/10.32614/CRAN.package.rms
- Hmisc (wersja 5.3.0): Harrell, F. E., Jr. (2026). Hmisc: Harrell miscellaneous (R package version 5.3-0) [Computer software]. https://doi.org/10.32614/CRAN.package.Hmisc
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Dlaczego predyktor z największym ilorazem szans nie ma najdłuższej osi na nomogramie?
Długość osi zależy od iloczynu współczynnika i zakresu wartości predyktora pokazanych na nomogramie. Zmienna 0/1 o dużym ilorazie szans może więc dać mniej punktów niż zmienna ciągła o małym współczynniku na jednostkę, ale szerokim zakresie.
Czy nomogram można zbudować dla modelu z interakcją lub splajnem?
Tak. Przy splajnie oś predyktora jest nierównomierna albo zawraca, a przy interakcji pakiet rms rysuje osobne osie jednego predyktora dla poziomów drugiego. Taki nomogram trudniej czytać, więc w podpisie warto opisać jego konstrukcję.
Czy z nomogramu da się odczytać przedział ufności dla prawdopodobieństwa?
Na typowym nomogramie nie – pokazuje on tylko oszacowanie punktowe. Przedział dla konkretnej osoby trzeba policzyć z modelu, np. funkcją predict() z błędem standardowym na skali logitów, i dopiero potem przeliczyć na prawdopodobieństwo.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Modele predykcyjne: walidacja i kalibracja
Liczebność, przeuczenie, walidacja krzyżowa i bootstrap, LASSO i ridge, kalibracja, wynik Briera i TRIPOD+AI – na danych do pobrania, z kodem R.
Czytaj →PoradnikRegresja logistyczna w obrazkach
Prosta MNK na 0/1, krzywa S, logit a prawdopodobieństwo, interakcja w dwóch skalach i separacja – pięć rysunków z kodem R i podpisami APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Balachandran, V. P., Gonen, M., Smith, J. J., & DeMatteo, R. P. (2015). Nomograms in oncology: More than meets the eye. The Lancet Oncology, 16(4), e173–e180. https://doi.org/10.1016/s1470-2045(14)71116-7 ● Otwarty dostęp: pełny tekst
- Iasonos, A., Schrag, D., Raj, G. V., & Panageas, K. S. (2008). How to build and interpret a nomogram for cancer prognosis. Journal of Clinical Oncology, 26(8), 1364–1370. https://doi.org/10.1200/jco.2007.12.9791
- Steyerberg, E. W., & Vergouwe, Y. (2014). Towards better clinical prediction models: Seven steps for development and an ABCD for validation. European Heart Journal, 35(29), 1925–1931. https://doi.org/10.1093/eurheartj/ehu207 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{balachandran2015nomograms, author={Balachandran, Vinod P. and Gonen, Mithat and Smith, J. Joshua and DeMatteo, Ronald P.}, title={{Nomograms in oncology: More than meets the eye}}, journal={The Lancet Oncology}, year={2015}, volume={16}, number={4}, pages={e173--e180}, doi={10.1016/s1470-2045(14)71116-7}}@article{iasonos2008how, author={Iasonos, Alexia and Schrag, Deborah and Raj, Ganesh V. and Panageas, Katherine S.}, title={{How to build and interpret a nomogram for cancer prognosis}}, journal={Journal of Clinical Oncology}, year={2008}, volume={26}, number={8}, pages={1364--1370}, doi={10.1200/jco.2007.12.9791}}@article{steyerberg2014towards, author={Steyerberg, Ewout W. and Vergouwe, Yvonne}, title={{Towards better clinical prediction models: Seven steps for development and an ABCD for validation}}, journal={European Heart Journal}, year={2014}, volume={35}, number={29}, pages={1925--1931}, doi={10.1093/eurheartj/ehu207}}