Co to jest nomogram Fagana?
Nomogram Fagana (ang. Fagan nomogram) to wykres z trzema równoległymi osiami, który bez obliczeń przelicza prawdopodobieństwo choroby przed testem na prawdopodobieństwo po teście. Lewa oś pokazuje prawdopodobieństwo przed testem, środkowa – iloraz wiarygodności (LR) w skali logarytmicznej, a prawa – prawdopodobieństwo po teście. Caraguel i Vanderstichel (2013) przypominają, że Fagan opublikował go w 1975 roku, aby lekarz mógł bez kalkulatora ocenić prawdopodobieństwo choroby przy danym wyniku testu; ich dwustopniowa wersja dodaje krok przeliczenia czułości i swoistości na LR.
Jak go czytać
- Zaznacz na lewej osi prawdopodobieństwo przed testem, np. chorobowość w danej grupie albo ocenę kliniczną.
- Zaznacz na środkowej osi LR+ dla wyniku dodatniego albo LR− dla ujemnego.
- Poprowadź prostą przez oba punkty; jej przecięcie z prawą osią to prawdopodobieństwo po teście.
Prosta działa, bo osie są wyskalowane tak, że logit prawdopodobieństwa po teście jest sumą logitu przed testem i logarytmu LR. To graficzna wersja reguły „szansa po teście = szansa przed testem × LR”, którą opisują Deeks i Altman (2004).
Przykład
Test o czułości .85 i swoistości .80 ma LR+ = 4.250 i LR− = 0.188. Przy prawdopodobieństwie przed testem 5% wynik dodatni podnosi je do 18.3%, przy 20% – do 51.5%, a przy 50% – do 81.0%. Wynik ujemny obniża te wartości do 1.0%, 4.5% i 15.8%. Ten sam test znaczy więc co innego w badaniu przesiewowym i w poradni specjalistycznej, co wiąże się z wartościami predykcyjnymi.
Na rysunku
Nomogram narysowany w R dla testu z przykładu (czułość .85, swoistość .80) i prawdopodobieństwa przed testem 20%. Zależność prawdopodobieństwa po teście od prawdopodobieństwa przed testem dla wszystkich wartości naraz pokazuje rysunek w haśle iloraz wiarygodności.
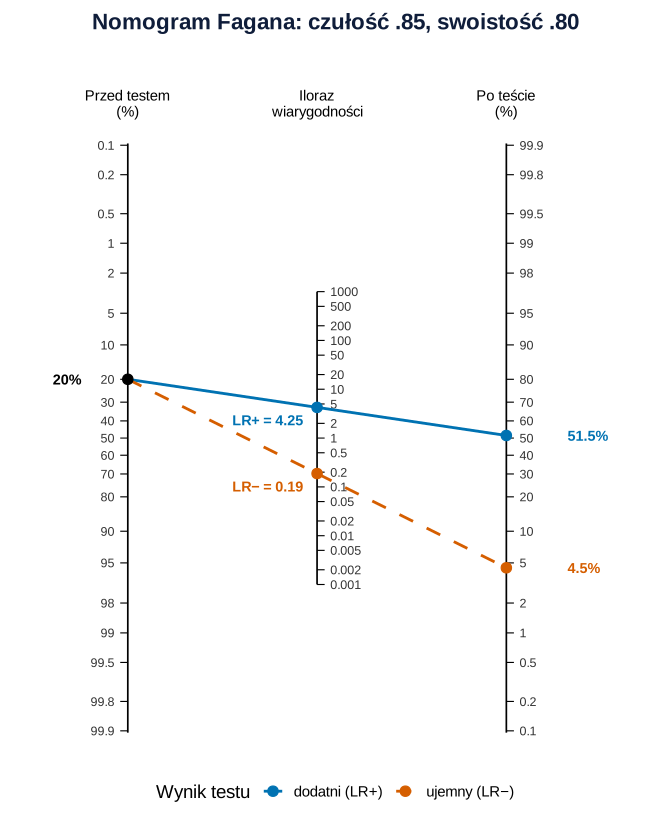
Co widać. Obie linie zaczynają się w tym samym punkcie lewej osi (20%). Niebieska linia ciągła przechodzi przez LR+ = 4.25 i trafia w prawą oś przy 51.5%, pomarańczowa przerywana przechodzi przez LR− = 0.19 i trafia przy 4.5%. To te same liczby, które daje rachunek na szansach w przykładzie. Lewa oś jest odwrócona (małe wartości u góry), a środkowa ma o połowę mniejszą podziałkę niż osie boczne. Dzięki temu prosta przez dwa punkty dodaje logarytm LR do logitu prawdopodobieństwa przed testem. Kod sprawdza, że odczyt z prawej osi zgadza się z obliczeniem co do 0.1 pp. Kto chce przesunąć 20% do 80%, potrzebuje LR = 16 – dużo więcej niż daje ten test.
Na co uważać. Z papierowego nomogramu wynik odczytuje się na oko, więc z ograniczoną dokładnością, zwłaszcza tam, gdzie podziałka jest gęsta. Do pracy podaj liczby policzone, a nomogram traktuj jako ilustrację. Rysunek nie pokazuje niepewności LR: przedział ufności LR+ daje cały wachlarz linii, a nie jedną. Nie widać też, że LR mogą się różnić między populacjami. Linie dla dwóch testów wykonanych po kolei można złożyć tylko przy ich warunkowej niezależności.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu. Jest samowystarczalny: rysuje osie nomogramu w ggplot2 i sam definiuje paletę Okabe–Ito i motyw. Rysunek na stronie powstał z tego samego obiektu pa; różni się tylko krojem czcionki i kolorem tytułu. Kod nic nie losuje.
Kod R rysunku 1
# Rysunek 1. Nomogram Fagana dla LR+ i LR− przy prawdopodobieństwie przed testem 20%
library(ggplot2)

# Paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw); wynik testu rozróżnia też typ linii i etykieta
kol <- c("dodatni" = "#0072B2", "ujemny" = "#D55E00")
lin <- c("dodatni" = "solid", "ujemny" = "dashed")
motyw <- theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", hjust = 0.5, margin = margin(b = 8)),
        legend.position = "bottom", plot.margin = margin(10, 10, 10, 10))

czul <- 0.85; swoi <- 0.80                        # test z przykładu hasła
LR <- c(dodatni = czul / (1 - swoi), ujemny = (1 - czul) / swoi)
p0 <- 0.20                                         # prawdopodobieństwo przed testem
po_tescie <- function(p0, lr) { s <- p0 / (1 - p0) * lr; s / (1 + s) }
p1 <- po_tescie(p0, LR)
round(c(LR, 100 * p1), 3)

# Położenie na osiach (w jednostkach logitu): lewa oś odwrócona, środkowa w połowie skali.
# Prosta przez (0, −logit(p0)) i (1, ln(LR)/2) przecina x = 2 w punkcie logit(p0) + ln(LR) = logit(p1).
y_lewa  <- function(p)  -qlogis(p)
y_srod  <- function(lr) log(lr) / 2
y_prawa <- function(p)  qlogis(p)
odczyt <- sapply(LR, function(lr) 2 * y_srod(lr) - y_lewa(p0))   # wysokość prostej przy x = 2
round(100 * plogis(odczyt), 1)                     # odczyt z prawej osi = prawdopodobieństwo po teście
round((0.8 / 0.2) / (p0 / (1 - p0)), 1)            # jaki LR przenosi 20% na 80%

proc <- c(0.1, 0.2, 0.5, 1, 2, 5, 10, 20, 30, 40, 50, 60, 70, 80, 90, 95, 98, 99, 99.5, 99.8, 99.9)
lr_tick <- c(0.001, 0.002, 0.005, 0.01, 0.02, 0.05, 0.1, 0.2, 0.5, 1, 2, 5, 10, 20, 50, 100, 200, 500, 1000)
podz <- rbind(
  data.frame(x = 0, y = y_lewa(proc / 100), etyk = format(proc, drop0trailing = TRUE), strona = -1),
  data.frame(x = 1, y = y_srod(lr_tick), etyk = format(lr_tick, scientific = FALSE, drop0trailing = TRUE), strona = 1),
  data.frame(x = 2, y = y_prawa(proc / 100), etyk = format(proc, drop0trailing = TRUE), strona = 1))
podz$etyk <- trimws(podz$etyk)

linie <- data.frame(wynik = names(LR), x = 0, y = y_lewa(p0), xend = 2, yend = y_prawa(p1))
punkty <- rbind(data.frame(wynik = names(LR), x = 1, y = y_srod(LR)),
                data.frame(wynik = names(LR), x = 2, y = y_prawa(p1)))
opisy <- data.frame(wynik = names(LR), x = c(0.95, 0.95, 2.3, 2.3), y = c(y_srod(LR) - 0.3, y_prawa(p1)),
                    h = c(1, 1, 0, 0),
                    tekst = c(sprintf("LR+ = %.2f", LR[1]), sprintf("LR− = %.2f", LR[2]),
                              sprintf("%.1f%%", 100 * p1[1]), sprintf("%.1f%%", 100 * p1[2])))

pa <- ggplot() +
  geom_segment(aes(x = c(0, 1, 2), xend = c(0, 1, 2), y = c(-6.95, y_srod(0.001), -6.95),
                   yend = c(6.95, y_srod(1000), 6.95)), linewidth = 0.6) +
  geom_segment(data = podz, aes(x = x, xend = x + 0.04 * strona, y = y, yend = y), linewidth = 0.4) +
  geom_text(data = podz, aes(x = x + 0.07 * strona, y = y, label = etyk,
                             hjust = ifelse(strona < 0, 1, 0)), size = 3.3, colour = "grey20") +
  geom_segment(data = linie, aes(x = x, y = y, xend = xend, yend = yend, colour = wynik, linetype = wynik),
               linewidth = 1) +
  annotate("point", x = 0, y = y_lewa(p0), size = 3.2) +
  annotate("label", x = -0.32, y = y_lewa(p0), label = "20%", size = 3.8, fontface = "bold",
           linewidth = 0, fill = "white") +
  geom_point(data = punkty, aes(x, y, colour = wynik), size = 3.2) +
  geom_label(data = opisy, aes(x, y, label = tekst, colour = wynik, hjust = h), size = 3.8,
             fontface = "bold", linewidth = 0, fill = "white", show.legend = FALSE) +
  annotate("text", x = c(0, 1, 2), y = 7.9, size = 3.9, lineheight = 0.9,
           label = c("Przed testem\n(%)", "Iloraz\nwiarygodności", "Po teście\n(%)")) +
  scale_colour_manual(values = kol, name = "Wynik testu",
                      labels = c(dodatni = "dodatni (LR+)", ujemny = "ujemny (LR−)")) +
  scale_linetype_manual(values = lin, name = "Wynik testu",
                        labels = c(dodatni = "dodatni (LR+)", ujemny = "ujemny (LR−)")) +
  scale_x_continuous(limits = c(-0.45, 2.65)) +
  scale_y_continuous(limits = c(-7.1, 8.5)) +
  labs(title = "Nomogram Fagana: czułość .85, swoistość .80") + motyw

pa   # zapis: ggsave("nomogram-fagana-20.svg", pa, width = 7, height = 8.5)
Wynik w R
dodatni  ujemny dodatni  ujemny
  4.250   0.188  51.515   4.478
dodatni  ujemny
   51.5     4.5
[1] 16
Jak opisać w pracy
Na co uważać
- LR musi pasować do pacjenta. LR z badania z błędem spektrum przesuwa wynik za daleko.
- Kolejne testy. Dwa dodatnie wyniki pozwalają pomnożyć LR (w przykładzie 20% → 81.9%) tylko wtedy, gdy testy są warunkowo niezależne; testy mierzące to samo zwykle nie są.
- Wiele progów. Grimes i Schulz (2005) przypominają, że LR można liczyć dla kilku przedziałów wyniku, więc nomogram stosuje się też do testów wielopoziomowych. Obliczenia na tabeli 2 × 2 wykona kalkulator testu diagnostycznego.
Nomogram Fagana w R
Kod liczy LR+ i LR− z czułości i swoistości, przelicza trzy prawdopodobieństwa przed testem na prawdopodobieństwa po teście i sprawdza, że nomogram odpowiada dodawaniu na skali logitów. Liczby w tekście pochodzą z tego kodu.
Prawdopodobieństwo po teście z LR
R
set.seed(607)                                    # obliczenia deterministyczne; ziarno dla porządku
czul <- 0.85; swoi <- 0.80                       # test z badania walidacyjnego
LR <- c(dodatni = czul / (1 - swoi), ujemny = (1 - czul) / swoi)
po_tescie <- function(p0, lr) { s <- p0 / (1 - p0) * lr; s / (1 + s) }  # szansa × LR → prawdopodobieństwo
p0 <- c(0.05, 0.20, 0.50)                        # trzy prawdopodobieństwa przed testem
round(LR, 3)
round(100 * sapply(LR, function(lr) po_tescie(p0, lr)), 1)  # wiersze: p0 = 5%, 20%, 50%
# nomogram = suma na skali logitów: logit(po) = logit(przed) + ln(LR)
all.equal(qlogis(po_tescie(0.20, LR[1])), qlogis(0.20) + log(LR[1]), check.attributes = FALSE)
round(100 * po_tescie(0.20, LR[1] * LR[1]), 1)   # dwa niezależne dodatnie wyniki (LR mnożone)
Wynik w R
dodatni  ujemny
  4.250   0.188
     dodatni ujemny
[1,]    18.3    1.0
[2,]    51.5    4.5
[3,]    81.0   15.8
[1] TRUE
dodatni
   81.9
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (bez dodatkowych pakietów). Rysunek 1 wykonano w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Skąd wziąć prawdopodobieństwo przed testem do nomogramu Fagana?
Najczęściej z chorobowości w grupie podobnej do pacjenta, np. w danej poradni, albo z oceny klinicznej opartej na objawach. Ta liczba silnie wpływa na wynik, więc podaj jej źródło w pracy.
Dlaczego oś ilorazu wiarygodności w nomogramie jest logarytmiczna?
Na skali logitów prawdopodobieństwo po teście to suma logitu przed testem i logarytmu LR. Logarytmiczna oś zamienia mnożenie szans przez LR na dodawanie odcinków, więc wystarczy jedna prosta.
Czy nomogram Fagana można stosować dla dwóch testów po kolei?
Tak, prawdopodobieństwo po pierwszym teście staje się prawdopodobieństwem przed drugim. Jest to poprawne tylko wtedy, gdy wyniki obu testów są warunkowo niezależne przy danym stanie chorobowym.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kalkulator testu diagnostycznego
Czułość, swoistość, PPV, NPV, LR+ i LR− z przedziałami ufności z tabeli 2×2 oraz wykres wartości predykcyjnych w funkcji częstości.
Czytaj →PoradnikStatystyka dla lekarza
ARR, RR, NNT i NNH z przedziałem ufności, PPV i ilorazy wiarygodności, krzywe Kaplana–Meiera i HR, non-inferiority, pułapki i pierwsze kroki własnego badania.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Caraguel, C. G. B., & Vanderstichel, R. (2013). The two-step Fagan’s nomogram: Ad hoc interpretation of a diagnostic test result without calculation. Evidence-Based Medicine, 18(4), 125–128. https://doi.org/10.1136/eb-2013-101243 ● Otwarty dostęp
- Deeks, J. J., & Altman, D. G. (2004). Diagnostic tests 4: Likelihood ratios. BMJ, 329(7458), 168–169. https://doi.org/10.1136/bmj.329.7458.168 ● Otwarty dostęp
- Grimes, D. A., & Schulz, K. F. (2005). Refining clinical diagnosis with likelihood ratios. The Lancet, 365(9469), 1500–1505. https://doi.org/10.1016/s0140-6736(05)66422-7
Cytowania BibTeX
@article{caraguel2013two, author={Caraguel, Charles G. B. and Vanderstichel, Raphaël}, title={{The two-step Fagan’s nomogram: Ad hoc interpretation of a diagnostic test result without calculation}}, journal={Evidence-Based Medicine}, year={2013}, volume={18}, number={4}, pages={125--128}, doi={10.1136/eb-2013-101243}}@article{deeks2004diagnostic, author={Deeks, Jonathan J. and Altman, Douglas G.}, title={{Diagnostic tests 4: Likelihood ratios}}, journal={BMJ}, year={2004}, volume={329}, number={7458}, pages={168--169}, doi={10.1136/bmj.329.7458.168}}@article{grimes2005refining, author={Grimes, David A. and Schulz, Kenneth F.}, title={{Refining clinical diagnosis with likelihood ratios}}, journal={The Lancet}, year={2005}, volume={365}, number={9469}, pages={1500--1505}, doi={10.1016/s0140-6736(05)66422-7}}