Kim jest Andrew F. Hayes?
Andrew F. Hayes to psycholog i metodolog. Licencjat z psychologii (z komunikacją jako drugim kierunkiem) zdobył na San Jose State University, a doktorat z psychologii – na Cornell University w 1996 r. Przez dwa lata był wykładowcą w School of Psychology University of New England w Australii, a w latach 1998–2001 pracował w Amos Tuck School of Business w Dartmouth College jako specjalista od obliczeń w badaniach statystycznych (Hayes, b.d.).
W 2001 r. przeszedł na Ohio State University. Do 2014 r. pracował w School of Communication, gdzie przeszedł drogę od adiunkta do profesora, a w latach 2014–2021 był profesorem na wydziale psychologii. 1 stycznia 2021 r. został Distinguished Research Professor w Haskayne School of Business University of Calgary (Perl-Pollard, 2021), a od 2026 r. kieruje tam katedrą badawczą (Research Excellence Chair). Od 2019 r. co roku trafia na listę najczęściej cytowanych badaczy Clarivate, a w 2025 r. dostał nagrodę Society for Personality and Social Psychology dla innowatorów metodologicznych (Hayes, b.d.).
Najważniejsze pomysły
- Warunkowa analiza procesu. Podręcznik Introduction to Mediation, Moderation, and Conditional Process Analysis (2013; 3. wyd. 2022) łączy w ramach regresji MNK mediację (jak X działa na Y przez M), moderację (kiedy i dla kogo) i ich połączenie: efekty pośrednie, które zależą od moderatora (Hayes, 2022). Rama ta opiera się na rozróżnieniu moderatora i mediatora, które spopularyzowali Baron i Kenny.
- Indeks moderowanej mediacji (2015). W „Multivariate Behavioral Research” Hayes (2015) zaproponował jedną liczbę – współczynnik funkcji liniowej, która wiąże efekt pośredni z moderatorem – i test moderowanej mediacji oparty na jej przedziale ufności. Szczegóły w haśle indeks moderowanej mediacji.
- PROCESS. Hayes jest twórcą makra PROCESS dla SPSS, SAS i R, w którym model mediacji lub moderacji wybiera się z listy ponumerowanych schematów, a program podaje efekty warunkowe i przedziały bootstrapowe (Perl-Pollard, 2021; Hayes, 2022).
- Rzetelność kodowania. Z Klausem Krippendorffem zaproponował alfę Krippendorffa jako standardową miarę zgodności koderów – działa przy dowolnej liczbie obserwatorów, każdym poziomie pomiaru i brakach danych – i udostępnił do niej makro dla SPSS i SAS (Hayes i Krippendorff, 2007).
Ciekawostka
Zanim Hayes został profesorem, przez trzy lata nie był wykładowcą, tylko specjalistą od obliczeń statystycznych w szkole biznesu w Dartmouth (Hayes, b.d.). Ta perspektywa użytkownika programów wraca w jego pracy: według komunikatu University of Calgary buduje narzędzia jako rozszerzenia programów, których badacze i tak już używają, żeby łatwo było je przyjąć. Sam ujął to tak: „My audience is the everyday researcher, not the professional methodologist” – jego odbiorcą jest zwykły badacz, nie zawodowy metodolog (Perl-Pollard, 2021).
Dwadzieścia lat po Dartmouth wrócił do szkoły biznesu – w 2021 r. przeszedł do Haskayne School of Business, do grupy zachowań organizacyjnych. Komunikat uczelni wymienia marketing, rachunkowość behawioralną i przedsiębiorczość wśród dziedzin, na które wpłynęły jego metody (Perl-Pollard, 2021).
Przykład na prawdziwych danych
Zbiór Garcia (alias GSBE) z pakietu psych to – według pliku pomocy – dane z eksperymentu Garcii i in. (2010), których Hayes używa w podręczniku jako zbioru „protest” do przykładu moderowanej mediacji. 129 kobiet czytało o prawniczce pominiętej przy awansie na rzecz mniej wykwalifikowanego mężczyzny. W losowo przydzielonych warunkach prawniczka nie protestowała albo protestowała indywidualnie lub w imieniu kobiet; jak w zmiennej prot2 łączymy oba rodzaje protestu (X; 88 osób w warunkach z protestem, 41 bez protestu). Mierzono przekonanie badanej, że dyskryminacja kobiet jest powszechna (W), ocenę, czy reakcja prawniczki była właściwa (M), i sympatię do niej (Y).
Liczymy prostszy wariant niż w podręczniku: moderator działa tylko na ścieżce X → M (model 7 w numeracji PROCESS), więc liczby nie muszą się zgadzać z książką. Interakcja na ścieżce a jest wyraźna: a3 = 0.810 (p = .005). Bez protestu im silniejsze przekonanie o dyskryminacji, tym gorzej oceniano reakcję (a2 = −0.529, p = .027). Ocena właściwości reakcji wiąże się z sympatią, b = 0.402 (p < .001), a efekt bezpośredni protestu jest bliski zera, c′ = −0.101 (p = .616).
Warunkowy efekt pośredni (a1 + a3W)b rośnie z W: przy 16. centylu W (4.31) wynosi 0.323, 95% CI [0.063; 0.615], przy medianie (5.12) – 0.588 [0.321; 0.896], a przy 84. centylu (5.87) – 0.832 [0.406; 1.345]. Indeks moderowanej mediacji a3b = 0.326, 95% CI [0.037; 0.682] – przedział nie obejmuje zera, więc efekt pośredni zależy od moderatora. Przedziały pochodzą z bootstrapu percentylowego (5000 prób, ziarno 2015).
Na rysunku
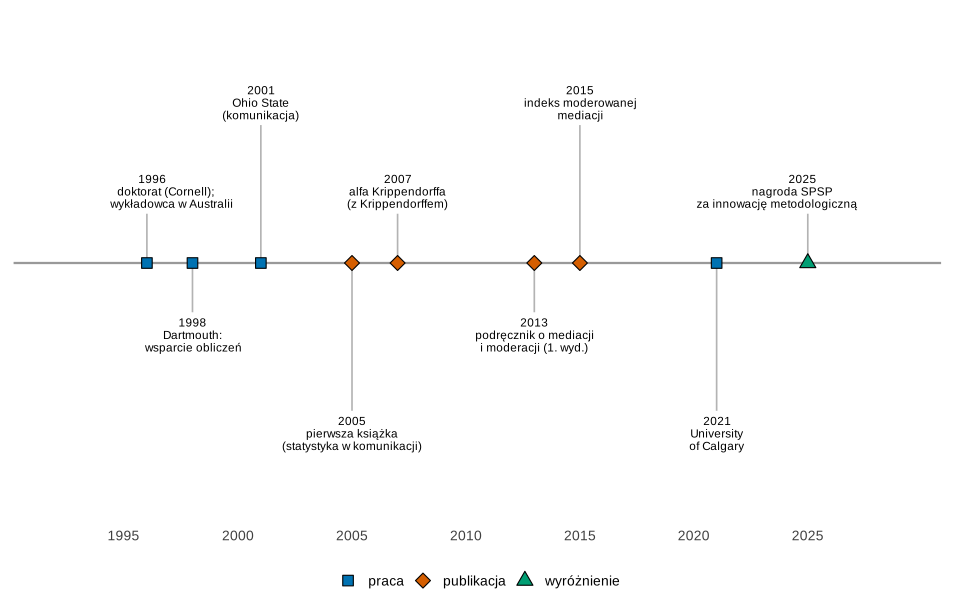
Co widać. Droga od statystyki w naukach o komunikowaniu (2005, 2007) do metodologii mediacji i moderacji (2013, 2015).
Na co uważać. Hayes żyje, więc oś zawiera tylko zdarzenia zawodowe; nie podajemy roku urodzenia ani roku licencjatu, bo dwie strony autora podają go różnie.
Podpis do pracy:
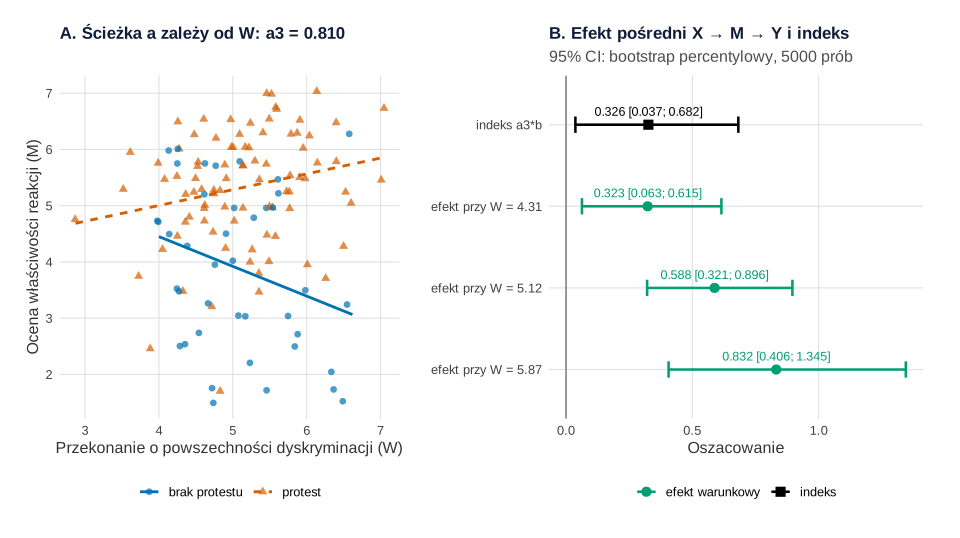
psych::Garcia, N = 129): ocena właściwości reakcji w zależności od przekonania o powszechności dyskryminacji w dwóch warunkach (A) oraz warunkowe efekty pośrednie protestu na sympatię i indeks moderowanej mediacji z 95% przedziałami (B). Bootstrap: 5000 prób, set.seed(2015); punkty w panelu A lekko rozsunięte (set.seed(2010)). Obliczenia i rysunek: R, pakiety boot, ggplot2 i patchwork.Co widać. W panelu A proste się krzyżują: bez protestu ocena reakcji spada wraz z przekonaniem o dyskryminacji, przy proteście rośnie. Różnica między prostymi to ścieżka a przy danym W – a efekt pośredni to ta różnica pomnożona przez b. W panelu B efekt pośredni rośnie z W prawie trzykrotnie, a indeks opisuje tempo tego wzrostu.
Na co uważać. Losowo przydzielono tylko protest; moderatora i mediatora zmierzono, więc związek M z Y może zakłócać trzecia zmienna. Dolna granica przedziału indeksu (0.037) leży blisko zera.
Podpis do pracy:
Gdzie spotkasz Hayesa w swojej pracy
- Hipotezy „X działa przez M, ale zależnie od W”. Jeśli Twoja hipoteza łączy mediację z moderacją, opisujesz ją językiem Hayesa: warunkowy efekt pośredni, indeks moderowanej mediacji, przedziały bootstrapowe. Proste nachylenia sondujesz jak w haśle proste nachylenia.
- PROCESS w SPSS. Jeśli analizujesz dane w SPSS, prawdopodobnie użyjesz makra PROCESS – krok po kroku w poradniku mediacja i moderacja w SPSS z PROCESS; podstawy w poradnikach analiza mediacji krok po kroku i analiza moderacji krok po kroku.
- Raportowanie. Podaj numer i schemat modelu, współczynniki obu równań, efekty warunkowe przy wybranych wartościach W, indeks z przedziałem, liczbę prób bootstrapowych i ziarno. Cytuj makro i podręcznik w wersji, której użyłeś.
- Zgodność koderów. Jeśli kodujesz treści (np. wypowiedzi, artykuły), alfa Krippendorffa z pracy Hayesa i Krippendorffa (2007) to jedna z miar zgodności do raportu.
Moderowana mediacja ręcznie w R
Kod wczytuje dane Garcii i in. (2010), szacuje dwa modele regresji (mediator z interakcją X·W i wynik z X i M), liczy indeks moderowanej mediacji i warunkowe efekty pośrednie przy 16., 50. i 84. centylu moderatora, wyznacza ich przedziały bootstrapem percentylowym i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Losowanie: bootstrap z set.seed(2015) (5000 prób) i rozsunięcie punktów na wykresie z set.seed(2010).
1. Dwa modele, indeks i bootstrap: rysunek 2
Kod R rysunku 2
# Hayes: moderowana mediacja ręcznie – dwa modele lm, indeks moderowanej mediacji i bootstrap
# (psych::GSBE – dane Garcii i in., 2010, zbiór „protest” z podręcznika Hayesa)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(boot)})
kol <- c(brak = "#0072B2", protest = "#D55E00", efekt = "#009E73", indeks = "#000000")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(GSBE, package = "psych")                  # wczytuje obiekt Garcia
# prot2 – X: prawniczka zaprotestowała przeciw dyskryminacji (1) albo nie (0); sexism – W: przekonanie, że
# dyskryminacja kobiet jest powszechna (średnia 8 pozycji); respappr – M: ocena, czy reakcja była właściwa;
# liking – Y: sympatia do prawniczki
d <- Garcia[, c("prot2", "sexism", "respappr", "liking")]
c(N = nrow(d), braki = sum(is.na(d)))
table(X = d$prot2)

# Model 7 (moderator na ścieżce a): M = a0 + a1 X + a2 W + a3 XW;  Y = b0 + c' X + b M
m_M <- lm(respappr ~ prot2 * sexism, data = d)
m_Y <- lm(liking ~ prot2 + respappr, data = d)
wsp <- rbind(summary(m_M)$coef, summary(m_Y)$coef[-1, ])
rownames(wsp) <- c("a0 (wyraz wolny)", "a1 (X)", "a2 (W)", "a3 (X*W)", "c' (X -> Y)", "b (M -> Y)")
round(wsp, 3)
a1 <- coef(m_M)[["prot2"]]; a3 <- coef(m_M)[["prot2:sexism"]]; b <- coef(m_Y)[["respappr"]]
# Warunkowy efekt pośredni X -> M -> Y przy danym W: (a1 + a3 W) b;  indeks moderowanej mediacji: a3 b
W <- quantile(d$sexism, c(0.16, 0.50, 0.84))
round(c(indeks = a3 * b, setNames((a1 + a3 * W) * b, paste0("efekt_W_", round(W, 2)))), 3)

# Bootstrap percentylowy: 5000 prób losowanych ze zwracaniem, w każdej oba modele od nowa
stat <- function(dane, i) {
  x <- dane[i, ]
  mm <- coef(lm(respappr ~ prot2 * sexism, data = x)); bb <- coef(lm(liking ~ prot2 + respappr, data = x))[["respappr"]]
  c(mm[["prot2:sexism"]] * bb, (mm[["prot2"]] + mm[["prot2:sexism"]] * W) * bb)
}
set.seed(2015)
bt <- boot(d, stat, R = 5000)
ci <- t(apply(bt$t, 2, quantile, c(0.025, 0.975)))
tab <- data.frame(row.names = NULL, wielkosc = c("indeks a3*b", paste0("efekt przy W = ", round(W, 2))),
                  oszacowanie = bt$t0, dolna = ci[, 1], gorna = ci[, 2])
tab[, 2:4] <- round(tab[, 2:4], 3)
tab

# Rysunek: A – M względem W w dwóch warunkach (interakcja na ścieżce a); B – efekty warunkowe i indeks z 95% CI
d$warunek <- factor(d$prot2, levels = 0:1, labels = c("brak protestu", "protest"))
set.seed(2010)                                   # tylko do rozsunięcia punktów (jitter), nie wpływa na wyniki
pA <- ggplot(d, aes(sexism, respappr, colour = warunek, shape = warunek, linetype = warunek)) +
  geom_jitter(width = 0.05, height = 0.05, size = 2, alpha = 0.7) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, linewidth = 1) +
  scale_colour_manual(values = unname(kol[c("brak", "protest")]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "22"), name = NULL) +
  labs(title = sprintf("A. Ścieżka a zależy od W: a3 = %.3f", a3),
       x = "Przekonanie o powszechności dyskryminacji (W)", y = "Ocena właściwości reakcji (M)") +
  motyw
tab$rodzaj <- factor(c("indeks", rep("efekt warunkowy", 3)), levels = c("efekt warunkowy", "indeks"))
tab$wielkosc <- factor(tab$wielkosc, levels = rev(tab$wielkosc))
pB <- ggplot(tab, aes(oszacowanie, wielkosc, colour = rodzaj, shape = rodzaj)) +
  geom_vline(xintercept = 0, colour = "grey50") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, linewidth = 0.9, orientation = "y") +
  geom_point(size = 3.2) +
  geom_text(aes(label = sprintf("%.3f [%.3f; %.3f]", oszacowanie, dolna, gorna)), vjust = -1, size = 3.3,
            show.legend = FALSE) +
  scale_colour_manual(values = unname(kol[c("efekt", "indeks")]), name = NULL) +
  scale_shape_manual(values = c(16, 15), name = NULL) +
  labs(title = "B. Efekt pośredni X → M → Y i indeks",
       subtitle = "95% CI: bootstrap percentylowy, 5000 prób", x = "Oszacowanie", y = NULL) +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.1))
p2
Wynik w R
    N braki
  129     0
X
 0  1
41 88
                 Estimate Std. Error t value Pr(>|t|)
a0 (wyraz wolny)    6.567      1.209   5.429    0.000
a1 (X)             -2.687      1.452  -1.851    0.067
a2 (W)             -0.529      0.236  -2.243    0.027
a3 (X*W)            0.810      0.282   2.873    0.005
c' (X -> Y)        -0.101      0.200  -0.502    0.616
b (M -> Y)          0.402      0.070   5.788    0.000
      indeks efekt_W_4.31 efekt_W_5.12 efekt_W_5.87
       0.326        0.323        0.588        0.832
             wielkosc oszacowanie dolna gorna
1         indeks a3*b       0.326 0.037 0.682
2 efekt przy W = 4.31       0.323 0.063 0.615
3 efekt przy W = 5.12       0.588 0.321 0.896
4 efekt przy W = 5.87       0.832 0.406 1.345
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Andrew F. Hayes – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1996, 1998, 2001, 2005, 2007, 2013, 2015, 2021, 2025),
  opis = c("doktorat (Cornell);\nwykładowca w Australii", "Dartmouth:\nwsparcie obliczeń", "Ohio State\n(komunikacja)",
           "pierwsza książka\n(statystyka w komunikacji)", "alfa Krippendorffa\n(z Krippendorffem)",
           "podręcznik o mediacji\ni moderacji (1. wyd.)", "indeks moderowanej\nmediacji", "University\nof Calgary",
           "nagroda SPSP\nza innowację metodologiczną"),
  rodzaj = c("praca", "praca", "praca", "publikacja", "publikacja", "publikacja", "publikacja", "praca", "wyróżnienie"),
  poziom = c(0.5, -0.5, 1.4, -1.5, 0.5, -0.5, 1.4, -1.5, 0.5),   # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.3, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.7))   # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1992, 2029), breaks = seq(1995, 2025, by = 5)) +
  scale_y_continuous(limits = c(-2.4, 2.3)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (regresje – funkcja lm() z pakietu stats; bootstrap – pakiet boot; dane – pakiet psych; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions [R package]. https://doi.org/10.32614/CRAN.package.boot
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest Andrew F. Hayes?
To psycholog i metodolog. Doktorat z psychologii zrobił na Cornell University w 1996 r., uczył w Australii, pracował w Dartmouth College, a od 2001 do 2021 r. na Ohio State University – najpierw w School of Communication, potem na wydziale psychologii. Od 2021 r. jest profesorem w Haskayne School of Business University of Calgary.
Co to jest PROCESS Hayesa?
To makro dla SPSS, SAS i R, które szacuje modele mediacji, moderacji i ich połączeń, czyli warunkowej analizy procesu, wraz z efektami pośrednimi, warunkowymi i bootstrapowymi przedziałami ufności. Modele mają w nim numery, np. model 7 to moderator na ścieżce X → M. Hayes opisuje je w podręczniku Introduction to Mediation, Moderation, and Conditional Process Analysis.
Co mierzy indeks moderowanej mediacji Hayesa?
O ile zmienia się efekt pośredni X → M → Y, gdy moderator rośnie o jednostkę. Przy moderatorze na ścieżce a jest to iloczyn a3 · b. Hayes (2015) zaproponował, by przedział ufności tego indeksu traktować jako test moderowanej mediacji. W przykładzie na danych Garcii i in. indeks wynosi 0.326, 95% CI [0.037; 0.682].
Czy moderowaną mediację da się policzyć bez PROCESS?
Tak. Wystarczą dwa modele regresji – dla mediatora z interakcją X·W i dla wyniku z X i M – oraz bootstrap, który powtarza oba modele na próbach losowanych ze zwracaniem. Pokazujemy to w kodzie R na tej stronie; w lavaan ten sam model można zapisać jako model ścieżkowy ze zdefiniowanymi parametrami.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Mediacja i moderacja w SPSS z PROCESS
Instalacja makra Hayesa, modele 1, 4 i 7, efekt pośredni z bootstrapem, efekty warunkowe, indeks moderowanej mediacji i zapis APA – z plikiem .sav.
Czytaj →PoradnikAnaliza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Garcia, D. M., Schmitt, M. T., Branscombe, N. R., & Ellemers, N. (2010). Women’s reactions to ingroup members who protest discriminatory treatment: The importance of beliefs about inequality and response appropriateness. European Journal of Social Psychology, 40(5), 733–745. https://doi.org/10.1002/ejsp.644
- Hayes, A. F. (2015). An index and test of linear moderated mediation. Multivariate Behavioral Research, 50(1), 1–22. https://doi.org/10.1080/00273171.2014.962683
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press.
- Hayes, A. F. (b.d.). C.V. afhayes.com. Pobrano 22 listopada 2026 z https://www.afhayes.com/my-cv.html ● Otwarty dostęp
- Hayes, A. F., & Krippendorff, K. (2007). Answering the call for a standard reliability measure for coding data. Communication Methods and Measures, 1(1), 77–89. https://doi.org/10.1080/19312450709336664
- Perl-Pollard, K. (2021). Leading expert in applied data analysis joins Haskayne School of Business. UCalgary News. https://news.ucalgary.ca/news/leading-expert-applied-data-analysis-joins-haskayne-school-business ● Otwarty dostęp
Cytowania BibTeX
@article{garcia2010women, author={Garcia, Donna M. and Schmitt, Michael T. and Branscombe, Nyla R. and Ellemers, Naomi}, title={{Women’s reactions to ingroup members who protest discriminatory treatment: The importance of beliefs about inequality and response appropriateness}}, journal={European Journal of Social Psychology}, year={2010}, volume={40}, number={5}, pages={733--745}, doi={10.1002/ejsp.644}}@article{hayes2015index, author={Hayes, Andrew F.}, title={{An index and test of linear moderated mediation}}, journal={Multivariate Behavioral Research}, year={2015}, volume={50}, number={1}, pages={1--22}, doi={10.1080/00273171.2014.962683}}@book{hayes2022introduction, author={Hayes, Andrew F.}, title={{Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.)}}, year={2022}, publisher={Guilford Press}, url={https://www.guilford.com/books/Introduction-to-Mediation-Moderation-and-Conditional-Process-Analysis/Andrew-Hayes/9781462549030}}@misc{hayescv, author={Hayes, Andrew F.}, title={{C.V.}}, howpublished={afhayes.com}, url={https://www.afhayes.com/my-cv.html}}@article{hayes2007answering, author={Hayes, Andrew F. and Krippendorff, Klaus}, title={{Answering the call for a standard reliability measure for coding data}}, journal={Communication Methods and Measures}, year={2007}, volume={1}, number={1}, pages={77--89}, doi={10.1080/19312450709336664}}@misc{perlpollard2021hayes, author={Perl-Pollard, Karen}, title={{Leading expert in applied data analysis joins Haskayne School of Business}}, howpublished={UCalgary News}, year={2021}, publisher={University of Calgary}, url={https://news.ucalgary.ca/news/leading-expert-applied-data-analysis-joins-haskayne-school-business}}