Kim byli William Kermack i Anderson McKendrick?
Anderson Gray McKendrick (1876–1943) urodził się 8 września 1876 r. w Edynburgu jako syn profesora fizjologii. Dyplom lekarza uzyskał w Glasgow w 1900 r. i wstąpił do Indian Medical Service. W 1901 r. wyjechał z Ronaldem Rossem na wyprawę malaryczną do Sierra Leone – według Hirscha (2004) to Ross przekonał go o sile metod matematycznych w medycynie. Od 1905 r. pracował w Instytucie Pasteura w Kasauli w Indiach, w latach 1914–1920 jako jego dyrektor. W 1920 r. ze względów zdrowotnych wrócił do Szkocji i został superintendentem laboratorium Royal College of Physicians of Edinburgh (RCPE). Zmarł 30 maja 1943 r. (Hirsch, 2004).
William Ogilvy Kermack (1898–1970) urodził się 26 kwietnia 1898 r. w Kirriemuir. W 1918 r. ukończył w Aberdeen matematykę z filozofią naturalną oraz studia przyrodnicze, potem zajmował się chemią barwników w Oksfordzie, a w 1921 r. objął dział chemii w laboratorium RCPE. Był przede wszystkim chemikiem – jego prace ułatwiły produkcję leku przeciwmalarycznego mepakryny. W 1944 r. został członkiem Royal Society, w 1949 r. – pierwszym profesorem chemii biologicznej w Aberdeen. Zmarł nagle 20 lipca 1970 r. w swoim gabinecie na uczelni (Pennington, 2004).
Najważniejsze pomysły
- Teoria progu (1927). Kermack i McKendrick (1927) badali, co się dzieje po wprowadzeniu zakażonych do społeczności podatnych, gdy chorzy zdrowieją z trwałą odpornością albo umierają. Pokazali, że dla danych współczynników zakaźności, wyzdrowień i zgonów istnieje progowa gęstość populacji: poniżej niej epidemia nie wybucha, a powyżej – wybucha i zwykle kończy się, zanim zabraknie podatnych.
- Model ogólniejszy niż „SIR”. Oryginalny model pozwalał, by zakaźność i szansa wyzdrowienia zależały od czasu od zakażenia; autorzy wyprowadzili z niego równanie końcowego rozmiaru epidemii. Układ trzech równań S′, I′, R′ to tylko jego szczególny przypadek, który przez lata uchodził za cały model (Brauer, 2017). Progowej wielkości nie nazwali – dziś to R0, nazwany wprost dopiero przez Macdonalda w 1957 r.
- Wcześniejsze prace McKendricka. W 1912 r. modelował malarię (ludzie i komary), w pracy z 1914 r. o leukocytach niezależnie wyprowadził rozkład Poissona, a w drugiej pracy z 1914 r. opisał procesy losowe zwane dziś procesem czystych urodzin i procesem urodzin i śmierci. W rozprawie z 1926 r. podał równanie dla rozkładu wieku populacji (równanie McKendricka) i pierwsze stochastyczne ujęcie epidemii (Hirsch, 2004).
- Kohorty urodzeniowe (1934). Z P. McKinlayem analizowali umieralność w Wielkiej Brytanii i Szwecji i doszli do wniosku, że kluczowe dla zdrowia w całym życiu są warunki do 15. roku życia – to wczesny przykład myślenia o efekcie kohorty.
Teorię sprawdzali m.in. na epidemiach w stadach myszy, które badali Major Greenwood i W. W. C. Topley (Pennington, 2004). Prawidłowości w epidemiach szukali wcześniej Farr i Snow (Brauer, 2017).
Ciekawostka
Słynną pracę o teorii epidemii współtworzył człowiek niewidomy. 2 czerwca 1924 r. Kermack pracował sam w laboratorium chemicznym, gdy preparat wybuchł i żrąca zasada trafiła go w oczy – stracił wzrok całkowicie i na stałe. Przeszkolił się na nowo i przed końcem roku wrócił do pracy; Department of Scientific and Industrial Research i Carnegie Trust opłaciły mu asystenta (Pennington, 2004).
Przez kolejne 25 lat w laboratorium opublikował 84 prace, w tym – trzy lata po wypadku – artykuł z McKendrickiem z 1927 r. Publikacje czytali mu współpracownicy (Pennington, 2004).
Przykład na fikcyjnych danych
Przykład jest ilustracją z ręcznie dobranymi parametrami: populacja 10 000 osób, jedna zakażona na starcie, średni czas zakaźności 7 dni, R0 = 0.9, 1.5 i 2.5. Równania rozwiązujemy metodą Rungego–Kutty krokiem 0.1 dnia.
Przy R0 = 0.9 zachoruje łącznie około 0.1% populacji (10 osób) – epidemii nie ma. Przy R0 = 1.5 szczyt przypada na 112. dzień (6.3% chorych naraz), a przy 2.5 – na 45. dzień (23.4%). W obu przypadkach szczyt wypada dokładnie wtedy, gdy odsetek podatnych spada do progu 1/R0 (66.6% i 40.0%). Epidemia kończy się, choć podatni zostali: przy R0 = 1.5 nie zachoruje 41.7% ludzi, przy 2.5 – 10.7%. Te same wartości (58.3% i 89.3% chorych) daje równanie końcowego rozmiaru.
Hirsch (2004) streszcza twierdzenie progowe tak: epidemia kończy się mniej więcej tak daleko poniżej progu, jak daleko powyżej zaczęła. W kodzie widać, że to przybliżenie dla R0 bliskich 1: przy 1.1 odległości wynoszą .091 i .086, ale przy 1.5 już .333 i .250. Na koniec wersja losowa w duchu McKendricka: 2000 epidemii w populacji 1000 osób (ziarno 1927). Przy R0 = 1.5 aż 68.0% z nich szybko wygasa, a reszta obejmuje średnio 58.1% populacji.
Na rysunku
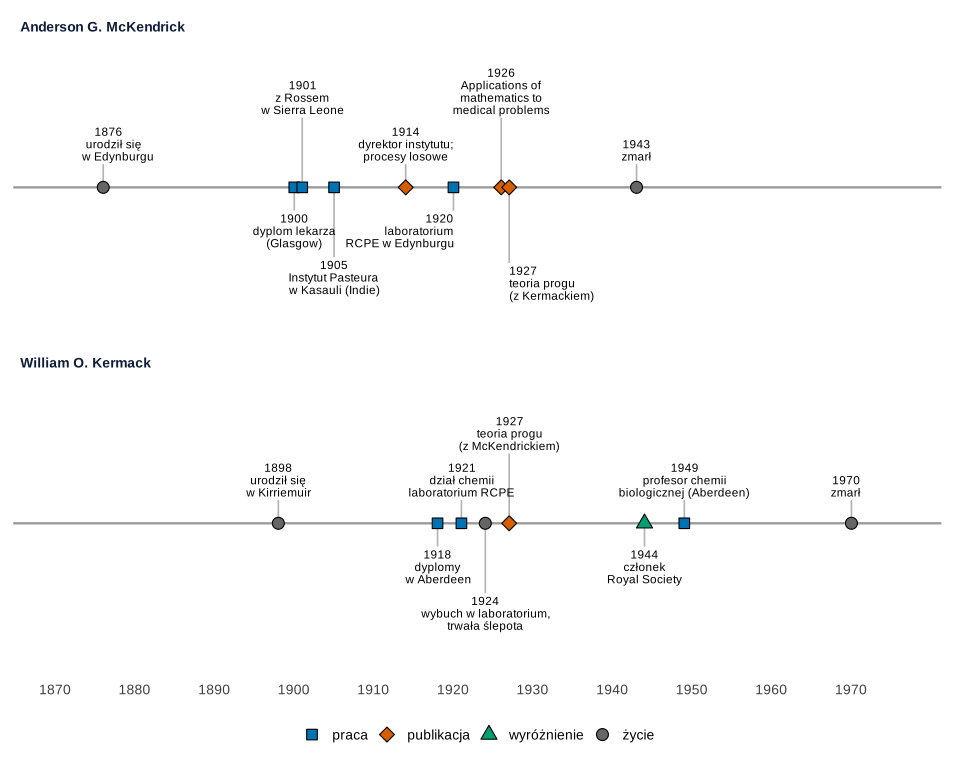
Co widać. Drogi lekarza z Indii i chemika z Aberdeen spotykają się w Edynburgu na początku lat 20.; praca o progu powstaje trzy lata po utracie wzroku przez Kermacka.
Na co uważać. Oś pomija dalsze prace z serii o epidemiach i prace chemiczne Kermacka.
Podpis do pracy:
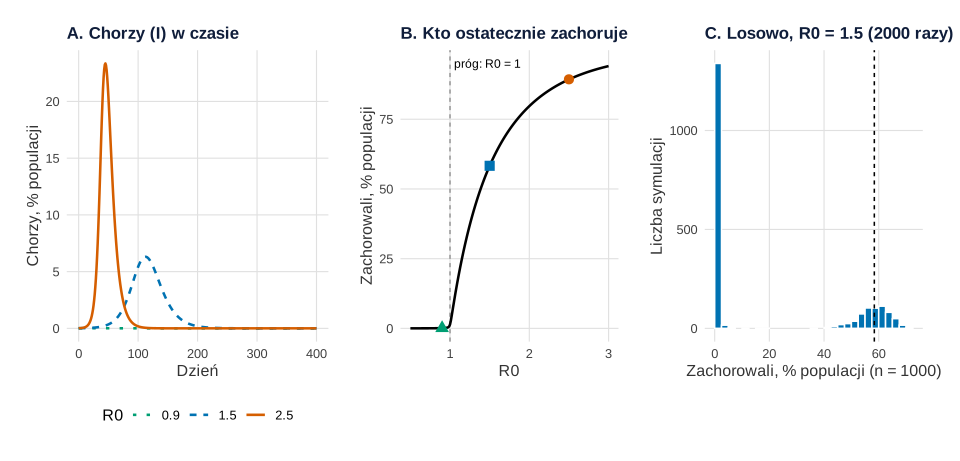
Co widać. Panel A pokazuje próg w działaniu: przy R0 poniżej 1 krzywa nie rośnie wcale. Panel B – że końcowy rozmiar nigdy nie obejmuje wszystkich. Panel C pokazuje to, czego model deterministyczny nie widzi: część epidemii gaśnie w zarodku.
Na co uważać. To model jednorodnego mieszania, bez urodzin, migracji, sezonowości i z wykładniczym czasem zakaźności. Liczby z rysunku nie opisują żadnej prawdziwej choroby.
Podpis do pracy:
Gdzie spotkasz Kermacka i McKendricka w swojej pracy
Wszędzie tam, gdzie pojawia się R0, „próg epidemiczny” albo krzywa zachorowań. Na co zwracać uwagę:
- model przedziałowy mówi o liczbie nowych zakażeń w czasie, czyli o zapadalności, a liczba chorych w danej chwili to chorobowość – nie myl ich na wykresach;
- prosty model zakłada wykładniczy czas zakaźności i pełne wymieszanie; w małych grupach lepiej sprawdza się symulacja losowa – zaplanuj ją jak badanie (wpis Jak zaplanować badanie symulacyjne);
- w analizie zliczeń przypadków punktem wyjścia jest rozkład Poissona, którego historię opisuje hasło Siméon Denis Poisson.
Spory, mity i trudne strony
- Dżuma w Bombaju. Rysunek dopasowania modelu do epidemii dżumy w Bombaju z 1906 r. jest według Bacaëra (2012) najczęściej przedrukowywanym rysunkiem w książkach o epidemiologii matematycznej. Bacaër pokazuje jednak, że stałe parametry dają nierealistyczne wartości, a epidemie w Bombaju powtarzały się sezonowo co roku od 1897 do co najmniej 1911 r. Epidemia z 1906 r. nie skończyła się więc dlatego, że podatnych ubyło poniżej progu.
- Kto wymyślił R0? Ani Ross, ani Kermack i McKendrick nie nadali progowi nazwy; pojęcie wyraźnie nazwano dopiero w pracach o malarii z 1957 r. (Brauer, 2017). W 1927 r. autorzy nawiązywali do prac Rossa i Hudson (1915–1917).
Model Kermacka–McKendricka w R
Kod rozwiązuje prosty model Kermacka–McKendricka metodą Rungego–Kutty, sprawdza próg i równanie końcowego rozmiaru, symuluje epidemie losowe i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Część losowa ma ziarno 1927.
1. Model SIR, próg i końcowy rozmiar: rysunek 2
Kod R rysunku 2
# Kermack i McKendrick: model SIR rozwiązany numerycznie (Runge–Kutta 4. rzędu), próg epidemiczny,
# równanie końcowego rozmiaru epidemii i wersja losowa (dane fikcyjne, parametry dobrane ręcznie)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c("0.9" = "#009E73", "1.5" = "#0072B2", "2.5" = "#D55E00", szary = "grey60")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# Parametry ilustracyjne: populacja N, 1 osoba zakażona na starcie, średni czas zakaźności 1/gamma = 7 dni
N <- 10000; I0 <- 1; gamma <- 1 / 7
# Prosty model Kermacka–McKendricka: S' = -beta S I / N,  I' = beta S I / N - gamma I,  R' = gamma I
pochodne <- function(x, beta) {
  inf <- beta * x[1] * x[2] / N
  c(-inf, inf - gamma * x[2], gamma * x[2])
}
sir_rk4 <- function(R0, dt = 0.1, t_max = 400) {        # beta = R0 * gamma
  beta <- R0 * gamma; kroki <- round(t_max / dt)
  x <- c(N - I0, I0, 0); wynik <- matrix(NA, kroki + 1, 4); wynik[1, ] <- c(0, x)
  for (k in 1:kroki) {
    k1 <- pochodne(x, beta); k2 <- pochodne(x + dt / 2 * k1, beta)
    k3 <- pochodne(x + dt / 2 * k2, beta); k4 <- pochodne(x + dt * k3, beta)
    x <- x + dt / 6 * (k1 + 2 * k2 + 2 * k3 + k4)
    wynik[k + 1, ] <- c(k * dt, x)
  }
  data.frame(t = wynik[, 1], S = wynik[, 2], I = wynik[, 3], R = wynik[, 4], R0 = R0)
}
przebiegi <- do.call(rbind, lapply(c(0.9, 1.5, 2.5), sir_rk4))

# 1. Próg: epidemia rośnie tylko wtedy, gdy R0 · S/N > 1
podsum <- do.call(rbind, lapply(split(przebiegi, przebiegi$R0), function(d) {
  k <- which.max(d$I)
  data.frame(R0 = d$R0[1], szczyt_I = round(d$I[k], 1), dzien_szczytu = d$t[k],
             S_w_szczycie_proc = round(100 * d$S[k] / N, 1), prog_proc = round(100 / d$R0[1], 1),
             zachorowali_proc = round(100 * (N - tail(d$S, 1)) / N, 1),
             nie_zachorowali_proc = round(100 * tail(d$S, 1) / N, 1))
}))
podsum

# 2. Równanie końcowego rozmiaru (w odsetkach s = S/N): log(s0 / s_inf) = R0 * (1 - s_inf)
rozmiar_koncowy <- function(R0, s0 = 1 - I0 / N) {
  f <- function(s) log(s0 / s) - R0 * (1 - s)
  if (R0 * s0 <= 1) return(1 - uniroot(f, c(s0 - 0.5, s0 - 1e-12), tol = 1e-14)$root)   # mały wybuch
  1 - uniroot(f, c(1e-9, 1 / R0), tol = 1e-12)$root                                    # pierwiastek poniżej progu
}
c(R0_1.5 = rozmiar_koncowy(1.5), R0_2.5 = rozmiar_koncowy(2.5))   # zgodne z kolumną zachorowali_proc

# 3. "Tyle samo poniżej progu, ile powyżej": przy R0 nieco większym od 1
for (R0 in c(1.1, 1.2, 1.5)) {
  s_inf <- 1 - rozmiar_koncowy(R0); prog <- 1 / R0                  # próg jako odsetek podatnych
  print(round(c(R0 = R0, powyzej_progu_na_starcie = 1 - I0 / N - prog, ponizej_progu_na_koncu = prog - s_inf), 3))
}

# 4. Wersja losowa (McKendrick 1926 – pierwsze ujęcie stochastyczne): kolejne zdarzenia to zakażenie albo wyzdrowienie
koniec_losowy <- function(R0, n = 1000) {
  S <- n - 1; I <- 1
  while (I > 0) {
    p_zak <- R0 * S / n / (R0 * S / n + 1)                # udział zakażeń wśród najbliższych zdarzeń
    if (runif(1) < p_zak) { S <- S - 1; I <- I + 1 } else I <- I - 1
  }
  (n - S) / n                                             # odsetek, który przeszedł chorobę
}
set.seed(1927)
losowe <- data.frame(R0 = rep(c(0.9, 1.5, 2.5), each = 2000))
losowe$rozmiar <- sapply(losowe$R0, koniec_losowy)
aggregate(rozmiar ~ R0, losowe, function(x) round(c(maly_wybuch = mean(x < 0.1), srednia_duzych = mean(x[x >= 0.1])), 3))

# Rysunek: A – liczba chorych w czasie; B – końcowy rozmiar vs R0; C – rozmiary epidemii losowych (R0 = 1.5)
przebiegi$R0f <- factor(przebiegi$R0)
pA <- ggplot(subset(przebiegi, round(10 * t) %% 10 == 0), aes(t, 100 * I / N, colour = R0f, linetype = R0f)) +   # co 1 dzień
  geom_line(linewidth = 0.9) +
  scale_colour_manual(values = kol[c("0.9", "1.5", "2.5")], name = "R0") +
  scale_linetype_manual(values = c("dotted", "22", "solid"), name = "R0") +
  labs(title = "A. Chorzy (I) w czasie", x = "Dzień", y = "Chorzy, % populacji") +
  motyw
siatka <- data.frame(R0 = seq(0.5, 3, by = 0.01)); siatka$p <- sapply(siatka$R0, rozmiar_koncowy)
punkty <- data.frame(R0 = podsum$R0, p = podsum$zachorowali_proc / 100, R0f = factor(podsum$R0))
pB <- ggplot(siatka, aes(R0, 100 * p)) +
  geom_vline(xintercept = 1, colour = kol[["szary"]], linetype = "22") +
  geom_line(linewidth = 0.9) +
  geom_point(data = punkty, aes(colour = R0f, shape = R0f), size = 3.2) +
  annotate("text", x = 1.05, y = 95, hjust = 0, size = 3.2, label = "próg: R0 = 1") +
  scale_colour_manual(values = kol[c("0.9", "1.5", "2.5")], guide = "none") +
  scale_shape_manual(values = c(17, 15, 16), guide = "none") +
  labs(title = "B. Kto ostatecznie zachoruje", x = "R0", y = "Zachorowali, % populacji") +
  motyw
pC <- ggplot(subset(losowe, R0 == 1.5), aes(100 * rozmiar)) +
  geom_histogram(binwidth = 2.5, boundary = 0, fill = kol[["1.5"]], colour = "white") +
  geom_vline(xintercept = 100 * rozmiar_koncowy(1.5, s0 = 999 / 1000), linetype = "22") +
  labs(title = "C. Losowo, R0 = 1.5 (2000 razy)", x = "Zachorowali, % populacji (n = 1000)", y = "Liczba symulacji") +
  motyw
p2 <- pA + pB + pC + plot_layout(widths = c(1.2, 1, 1))
p2
Wynik w R
     R0 szczyt_I dzien_szczytu S_w_szczycie_proc prog_proc zachorowali_proc
0.9 0.9      1.0           0.0             100.0     111.1              0.1
1.5 1.5    630.9         112.4              66.6      66.7             58.3
2.5 2.5   2335.2          44.9              40.0      40.0             89.3
    nie_zachorowali_proc
0.9                 99.9
1.5                 41.7
2.5                 10.7
   R0_1.5    R0_2.5
0.5829231 0.8926594
                      R0 powyzej_progu_na_starcie   ponizej_progu_na_koncu
                   1.100                    0.091                    0.086
                      R0 powyzej_progu_na_starcie   ponizej_progu_na_koncu
                   1.200                    0.167                    0.147
                      R0 powyzej_progu_na_starcie   ponizej_progu_na_koncu
                   1.500                    0.333                    0.250
   R0 rozmiar.maly_wybuch rozmiar.srednia_duzych
1 0.9               0.988                  0.145
2 1.5               0.680                  0.581
3 2.5               0.436                  0.891
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Anderson G. McKendrick (1876–1943) i William O. Kermack (1898–1970) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1876, 1900, 1901, 1905, 1914, 1920, 1926, 1927, 1943,
          1898, 1918, 1921, 1924, 1927, 1944, 1949, 1970),
  osoba = c(rep("Anderson G. McKendrick", 9), rep("William O. Kermack", 8)),
  opis = c("urodził się\nw Edynburgu", "dyplom lekarza\n(Glasgow)", "z Rossem\nw Sierra Leone",
           "Instytut Pasteura\nw Kasauli (Indie)", "dyrektor instytutu;\nprocesy losowe", "laboratorium\nRCPE w Edynburgu",
           "Applications of\nmathematics to\nmedical problems", "teoria progu\n(z Kermackiem)", "zmarł",
           "urodził się\nw Kirriemuir", "dyplomy\nw Aberdeen", "dział chemii\nlaboratorium RCPE",
           "wybuch w laboratorium,\ntrwała ślepota", "teoria progu\n(z McKendrickiem)", "członek\nRoyal Society",
           "profesor chemii\nbiologicznej (Aberdeen)", "zmarł"),
  rodzaj = c("życie", "praca", "praca", "praca", "publikacja", "praca", "publikacja", "publikacja", "życie",
             "życie", "praca", "praca", "życie", "publikacja", "wyróżnienie", "praca", "życie"),
  poziom = c(0.4, -0.4, 1.2, -1.2, 0.4, -0.4, 1.2, -1.3, 0.4,
             0.4, -0.4, 0.4, -1.2, 1.2, -0.4, 0.4, 0.4),     # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.3, 0.5, 0.5, 0.5, 0.5, 1, 0.5, 0, 0.5,
                 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.7))     # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
zdarzenia$osoba <- factor(zdarzenia$osoba, levels = c("Anderson G. McKendrick", "William O. Kermack"))
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  facet_wrap(~ osoba, ncol = 1) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1870, 1976), breaks = seq(1870, 1970, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.3)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        strip.text = element_text(face = "bold", hjust = 0), legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (równania rozwiązane własną funkcją metody Rungego–Kutty, pierwiastek równania – uniroot() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim byli Kermack i McKendrick?
Badaczami z laboratorium Royal College of Physicians w Edynburgu. McKendrick (1876–1943) był lekarzem Indian Medical Service i dyrektorem Instytutu Pasteura w Kasauli, a od 1920 r. kierował laboratorium. Kermack (1898–1970) był chemikiem i matematykiem z Aberdeen; w 1924 r. stracił wzrok w wypadku, a mimo to w 1927 r. współtworzył z McKendrickiem teorię epidemii, później był profesorem chemii biologicznej w Aberdeen.
Co mówi twierdzenie progowe Kermacka–McKendricka?
Że dla danej zakaźności i tempa zdrowienia istnieje progowa gęstość osób podatnych: poniżej niej wprowadzenie zakażonych nie wywoła epidemii, powyżej – wywoła. Epidemia kończy się, zanim zabraknie podatnych. W prostym modelu próg odpowiada R0 = 1, a szczyt zachorowań wypada, gdy odsetek podatnych spadnie do 1/R0.
Czy model SIR to model Kermacka i McKendricka?
Tylko jego szczególny przypadek. W pracy z 1927 r. zakaźność i szansa wyzdrowienia mogły zależeć od czasu od zakażenia; układ S′, I′, R′ ze stałymi współczynnikami wynika z założenia wykładniczego czasu zakaźności. Sami autorzy nie używali też nazwy R0.
Jak policzyć model SIR w R bez pakietów?
Wystarczy funkcja z pochodnymi S′ = −βSI/N, I′ = βSI/N − γI, R′ = γI i pętla metody Rungego–Kutty 4. rzędu z małym krokiem. Końcowy rozmiar epidemii można sprawdzić, rozwiązując funkcją uniroot() równanie log(s0/s∞) = R0(1 − s∞). Pełny kod jest w sekcji z przykładem.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bacaër, N. (2012). The model of Kermack and McKendrick for the plague epidemic in Bombay and the type reproduction number with seasonality. Journal of Mathematical Biology, 64(3), 403–422. https://doi.org/10.1007/s00285-011-0417-5 ● Otwarty dostęp: pełny tekst
- Brauer, F. (2017). Mathematical epidemiology: Past, present, and future. Infectious Disease Modelling, 2(2), 113–127. https://doi.org/10.1016/j.idm.2017.02.001 ● Otwarty dostęp
- Hirsch, W. M. (2004). McKendrick, Anderson Gray (1876–1943), mathematician, epidemiologist, and army officer. In Oxford dictionary of national biography. Oxford University Press. https://mathshistory.st-andrews.ac.uk/DNB/McKendrick.html ● Otwarty dostęp
- Kermack, W. O., & McKendrick, A. G. (1927). A contribution to the mathematical theory of epidemics. Proceedings of the Royal Society of London. Series A, Containing Papers of a Mathematical and Physical Character, 115(772), 700–721. https://doi.org/10.1098/rspa.1927.0118 ● Otwarty dostęp
- Pennington, T. H. (2004). Kermack, William Ogilvy (1898–1970), biochemist and mathematical epidemiologist. In Oxford Dictionary of National Biography. Oxford University Press. https://doi.org/10.1093/ref:odnb/34299
Cytowania BibTeX
@article{bacaer2012model, author={Bacaër, Nicolas}, title={{The model of Kermack and McKendrick for the plague epidemic in Bombay and the type reproduction number with seasonality}}, journal={Journal of Mathematical Biology}, year={2012}, volume={64}, number={3}, pages={403--422}, doi={10.1007/s00285-011-0417-5}}@article{brauer2017mathematical, author={Brauer, Fred}, title={{Mathematical epidemiology: Past, present, and future}}, journal={Infectious Disease Modelling}, year={2017}, volume={2}, number={2}, pages={113--127}, doi={10.1016/j.idm.2017.02.001}}@incollection{hirsch2004mckendrick, author={Hirsch, Warren M.}, title={{McKendrick, Anderson Gray (1876–1943), mathematician, epidemiologist, and army officer}}, booktitle={Oxford dictionary of national biography}, year={2004}, publisher={Oxford University Press}, url={https://mathshistory.st-andrews.ac.uk/DNB/McKendrick.html}}@article{kermack1927contribution, author={Kermack, William Ogilvy and McKendrick, Anderson Gray}, title={{A contribution to the mathematical theory of epidemics}}, journal={Proceedings of the Royal Society of London. Series A, Containing Papers of a Mathematical and Physical Character}, year={1927}, volume={115}, number={772}, pages={700--721}, doi={10.1098/rspa.1927.0118}}@incollection{pennington2004kermack, author={Pennington, T. H.}, title={{Kermack, William Ogilvy (1898–1970), biochemist and mathematical epidemiologist}}, booktitle={Oxford Dictionary of National Biography}, year={2004}, publisher={Oxford University Press}, doi={10.1093/ref:odnb/34299}}