Co to jest q Cohena?
q Cohena to wielkość efektu dla różnicy dwóch korelacji Pearsona z niezależnych prób. Zamiast odejmować same r, każdą korelację przekształca się transformacją Fishera z, a potem odejmuje: q = z1 − z2, gdzie z = artanh(r). Miarę wprowadził Cohen (1988) w podręczniku analizy mocy, obok h Cohena dla proporcji i d Cohena dla średnich.
Dlaczego nie zwykła różnica r?
Ta sama różnica korelacji znaczy co innego przy różnych poziomach. Para .90 i .80 daje q = 0.37, a para .20 i .10 tylko 0.10. Po transformacji Fishera błąd standardowy nie zależy od wartości korelacji, więc q ma stałą skalę. Cohen (1988) przyjął q = 0.10, 0.30 i 0.50 jako efekt mały, średni i duży – liczbowo jak progi dla r, ale na innej skali.
Na rysunku
Dwa rysunki pokazują, dlaczego q liczy się po transformacji Fishera: pierwszy – krzywą transformacji (obliczenia analityczne), drugi – symulację 1000 prób po n = 50 dla każdej z czterech korelacji populacyjnych (set.seed(709)).
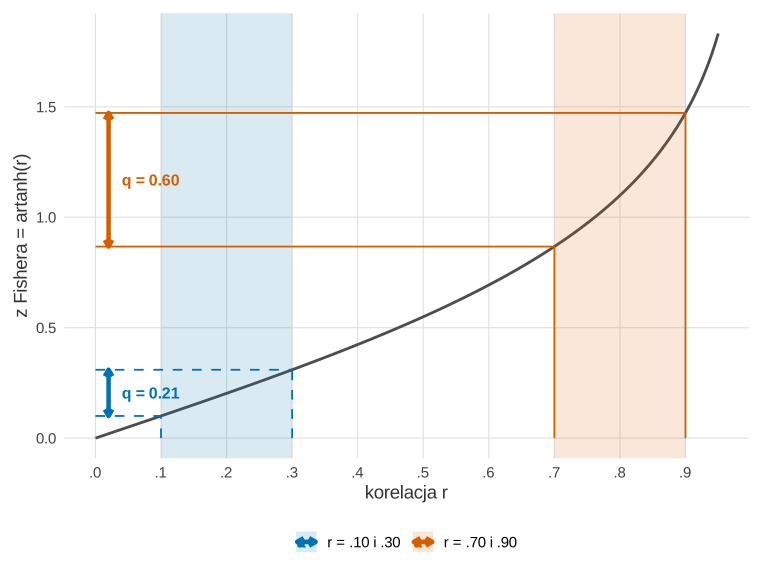
Co widać. Oba pasy na osi r mają tę samą szerokość .20, ale na osi z pierwszy daje q = 0.21 (efekt mały), a drugi q = 0.60 (efekt duży). Krzywa jest prawie prosta przy słabych korelacjach i coraz bardziej stroma przy silnych, więc rozciąga różnice blisko 1.
Podpis do pracy:
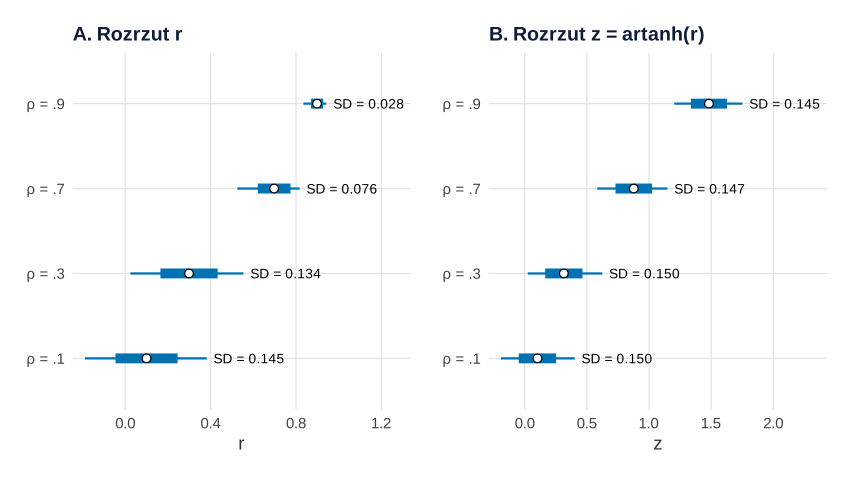
Co widać. Na skali r rozrzut wyników zależy od korelacji w populacji: SD wynosi 0.145 przy ρ = .1 i tylko 0.028 przy ρ = .9. Po transformacji SD mieści się między 0.145 a 0.150 dla wszystkich czterech wartości, blisko wartości ze wzoru 1/√(n − 3) = 0.146 (błąd Monte Carlo każdego SD ≈ 0.003). Dlatego jeden błąd standardowy wystarcza do testu i przedziału dla q, niezależnie od poziomu korelacji.
Na co uważać. Rysunki nie mówią, czy różnica jest ważna merytorycznie – duże q przy korelacjach bliskich 1 może oznaczać zmianę z .90 na .70, która w praktyce bywa mało istotna, a w badaniach rzetelności bardzo ważna. Symulacja dotyczy danych z rozkładu normalnego dwuwymiarowego; przy skośnych rozkładach stabilizacja wariancji jest gorsza. Podłoże transformacji opisuje hasło transformacja Fishera z.
Podpis do pracy:
Kod poniżej wymaga pakietów ggplot2 i patchwork; blok z symulacją ma własne ziarno set.seed(709) (ustalone raz, niedobierane) i liczy się w ułamku sekundy. Rysunki na stronie różnią się od wyniku kodu tylko motywem (czcionka, siatka).
Kod R rysunków 1 i 2
library(ggplot2); library(patchwork)
kol <- c(niska = "#0072B2", wysoka = "#D55E00")                          # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(legend.position = "bottom", panel.grid.minor = element_blank())
# Rysunek 1: krzywa transformacji Fishera i dwie pary o tej samej różnicy r = .20
krzywa <- data.frame(r = seq(0, .95, by = .005)); krzywa$z <- atanh(krzywa$r)
pary <- data.frame(para = c("r = .10 i .30", "r = .70 i .90"), r1 = c(.10, .70), r2 = c(.30, .90))
pary$z1 <- atanh(pary$r1); pary$z2 <- atanh(pary$r2); pary$q <- pary$z2 - pary$z1
round(data.frame(pary[, -1], row.names = pary$para), 3)
p1 <- ggplot(krzywa, aes(r, z)) +
  geom_line(linewidth = 1, colour = "grey30") +
  geom_rect(data = pary, aes(xmin = r1, xmax = r2, ymin = -Inf, ymax = Inf, fill = para),
            inherit.aes = FALSE, alpha = .15) +
  geom_segment(data = pary, aes(x = r1, xend = r1, y = 0, yend = z1, colour = para, linetype = para), inherit.aes = FALSE) +
  geom_segment(data = pary, aes(x = r2, xend = r2, y = 0, yend = z2, colour = para, linetype = para), inherit.aes = FALSE) +
  geom_segment(data = pary, aes(x = 0, xend = r2, y = z2, yend = z2, colour = para, linetype = para), inherit.aes = FALSE) +
  geom_segment(data = pary, aes(x = 0, xend = r1, y = z1, yend = z1, colour = para, linetype = para), inherit.aes = FALSE) +
  geom_segment(data = pary, aes(x = 0.02, xend = 0.02, y = z1, yend = z2, colour = para),
               inherit.aes = FALSE, linewidth = 1.6, arrow = arrow(ends = "both", length = unit(2, "mm"))) +
  geom_text(data = pary, aes(x = 0.04, y = (z1 + z2) / 2, label = sprintf("q = %.2f", q), colour = para),
            inherit.aes = FALSE, hjust = 0, size = 4.2, fontface = "bold") +
  scale_colour_manual(values = c("r = .10 i .30" = kol[["niska"]], "r = .70 i .90" = kol[["wysoka"]]), name = NULL) +
  scale_fill_manual(values = c("r = .10 i .30" = kol[["niska"]], "r = .70 i .90" = kol[["wysoka"]]), name = NULL) +
  scale_linetype_manual(values = c("r = .10 i .30" = "dashed", "r = .70 i .90" = "solid"), name = NULL) +
  scale_x_continuous(breaks = seq(0, .9, .1), labels = sub("^0", "", sprintf("%.1f", seq(0, .9, .1)))) +
  labs(x = "korelacja r", y = "z Fishera = artanh(r)") + motyw
# Rysunek 2: 1000 prób po n = 50 dla czterech korelacji populacyjnych – rozrzut r i z
set.seed(709)
n <- 50; rho <- c(.1, .3, .7, .9); powt <- 1000
sym <- do.call(rbind, lapply(rho, function(p) {
  r <- replicate(powt, { x <- rnorm(n); y <- p * x + sqrt(1 - p^2) * rnorm(n); cor(x, y) })
  data.frame(rho = p, r = r, z = atanh(r))
}))
sym$rho_et <- factor(sprintf("ρ = %s", sub("^0", "", sym$rho)))
rozrzut <- aggregate(cbind(r, z) ~ rho, sym, sd)
names(rozrzut) <- c("rho", "SD_r", "SD_z"); rozrzut$SD_z_wzor <- 1 / sqrt(n - 3)
rozrzut$blad_MC_SD_z <- rozrzut$SD_z / sqrt(2 * (powt - 1))      # przybliżony błąd Monte Carlo SD
round(rozrzut, 3)
opis <- do.call(rbind, lapply(c("r", "z"), function(zm) do.call(rbind, lapply(split(sym, sym$rho_et), function(d)
  data.frame(zm = zm, rho_et = d$rho_et[1], m = mean(d[[zm]]), sd = sd(d[[zm]]),
             lo = quantile(d[[zm]], .025), hi = quantile(d[[zm]], .975))))))
skala <- function(jaka, tyt) ggplot(subset(opis, zm == jaka), aes(y = rho_et)) +
  geom_linerange(aes(xmin = lo, xmax = hi), colour = kol[["niska"]], linewidth = 0.8) +
  geom_linerange(aes(xmin = m - sd, xmax = m + sd), colour = kol[["niska"]], linewidth = 3.5) +
  geom_point(aes(x = m), shape = 21, fill = "white", size = 2.6) +
  geom_text(aes(x = hi, label = sprintf("SD = %.3f", sd)), hjust = -0.1, size = 3.6) +
  scale_x_continuous(expand = expansion(mult = c(.05, .35))) +
  labs(title = tyt, x = jaka, y = NULL) + motyw
p2 <- skala("r", "A. Rozrzut r") + skala("z", "B. Rozrzut z = artanh(r)")
# print(p1); print(p2)   # albo: ggsave("q-cohena-fisher.svg", p1, width = 8, height = 6)
Wynik w R
               r1  r2    z1    z2     q
r = .10 i .30 0.1 0.3 0.100 0.310 0.209
r = .70 i .90 0.7 0.9 0.867 1.472 0.605
  rho  SD_r  SD_z SD_z_wzor blad_MC_SD_z
1 0.1 0.145 0.150     0.146        0.003
2 0.3 0.134 0.150     0.146        0.003
3 0.7 0.076 0.147     0.146        0.003
4 0.9 0.028 0.145     0.146        0.003
Test i moc
Statystyka z = q/√[1/(n1 − 3) + 1/(n2 − 3)] ma przy H0 rozkład normalny. Przy równych grupach liczebność na grupę dla mocy .80 i α = .05 wynosi 2·[(1.96 + 0.84)/q]² + 3: 178 osób dla q = 0.30 i aż 1573 dla 0.10. Czynnika 2 nie wolno pominąć, bo różnica obejmuje błąd z obu prób. Tablice liczebności dla mocy .80 przy konwencjonalnych efektach zestawił Cohen (1992).
Przykład
W grupie 120 studentów stacjonarnych korelacja stresu ze snem wyniosła r = .54, a wśród 110 niestacjonarnych r = .28 (dane symulowane). q = 0.31, 95% CI [0.05, 0.58], z = 2.35, p = .019 – to samo daje psych::paired.r().
Jak opisać w pracy
Na co uważać
- Tylko próby niezależne. Dwie korelacje z tej samej próby porównuje test Steigera.
- Różnica w jednostkach r. Jeśli chcesz podać przedział dla r1 − r2, użyj metody Zou (2007), opartej na przedziałach dla pojedynczych korelacji.
- Istotna i nieistotna to nie różnica. To, że jedna korelacja jest istotna, a druga nie, nie dowodzi, że się różnią.
Obie sytuacje krok po kroku omawia wpis Jak porównać dwie korelacje?, a gotowe obliczenia – kalkulator porównania korelacji.
q Cohena w R
Kod symuluje dwie niezależne próby, liczy q, test z i 95% CI, sprawdza wynik funkcją psych::paired.r(), a potem liczy moc i liczebność na grupę. Liczby w tekście pochodzą z tego kodu.
q Cohena, test różnicy korelacji i liczebność
R
set.seed(7092)
library(MASS)
n1 <- 120; n2 <- 110                                 # dwie niezależne grupy (dane symulowane)
g1 <- mvrnorm(n1, c(0, 0), matrix(c(1, .5, .5, 1), 2))
g2 <- mvrnorm(n2, c(0, 0), matrix(c(1, .3, .3, 1), 2))
r1 <- cor(g1)[1, 2]; r2 <- cor(g2)[1, 2]
q <- atanh(r1) - atanh(r2)                           # q Cohena = z1 - z2 (transformacja Fishera)
se <- sqrt(1 / (n1 - 3) + 1 / (n2 - 3))
z <- q / se
round(c(r1 = r1, r2 = r2, q = q, se = se, z = z, p = 2 * pnorm(-abs(z))), 3)
round(q + c(-1, 1) * qnorm(.975) * se, 3)            # 95% CI dla q
print(psych::paired.r(r1, r2, n = n1, n2 = n2)); cat("\n")  # kontrola: ten sam test z
round(c(q_09_08 = atanh(.9) - atanh(.8), q_02_01 = atanh(.2) - atanh(.1)), 3)  # ta sama różnica r, inne q
pwr::cohen.ES(test = "r", size = "medium")$effect.size   # konwencja dla r (nie dla q)
moc <- function(q, n) pnorm(abs(q) / sqrt(2 / (n - 3)) - qnorm(.975))
round(c(moc_q03_n115 = moc(.3, 115), moc_q01_n115 = moc(.1, 115)), 3)
n_q <- function(q, moc = .80) 2 * ((qnorm(.975) + qnorm(moc)) / q)^2 + 3   # n na grupę
round(sapply(c(maly = .1, sredni = .3, duzy = .5), n_q), 1)
Wynik w R
   r1    r2     q    se     z     p
0.539 0.281 0.314 0.134 2.346 0.019
[1] 0.052 0.576
Call: psych::paired.r(xy = r1, xz = r2, n = n1, n2 = n2)
[1] "test of difference between two independent correlations"
z = 2.35  With probability =  0.02
q_09_08 q_02_01
  0.374   0.102
[1] 0.3
moc_q03_n115 moc_q01_n115
       0.612        0.113
  maly sredni   duzy
1572.8  177.4   65.8
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety MASS, psych i pwr); Rysunki 1 i 2 wykonano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- pwr (wersja 1.3.0): Champely, S. (2020). pwr: Basic functions for power analysis (R package version 1.3-0) [Computer software]. https://doi.org/10.32614/CRAN.package.pwr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Jak policzyć q Cohena?
Przekształć obie korelacje funkcją artanh (transformacja Fishera z) i odejmij: q = artanh(r1) − artanh(r2). W R: atanh(r1) - atanh(r2). Dla r = .54 i .28 q ≈ 0.31.
Jaka wartość q Cohena oznacza duży efekt?
Według konwencji Cohena 0.10 to efekt mały, 0.30 średni, a 0.50 duży. Progi są umowne; ważniejsze jest, co różnica znaczy w danej dziedzinie.
Ile osób potrzeba, by wykryć różnicę korelacji?
Przy równych grupach, α = .05 i mocy .80 potrzeba około 178 osób w każdej grupie dla q = 0.30, 66 dla q = 0.50 i 1573 dla q = 0.10.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak porównać dwie korelacje?
Test z Fishera dla dwóch grup, test Williamsa dla korelacji z tej samej próby, przedział ufności różnicy i gotowy opis wyniku z kodem R.
Czytaj →PoradnikKalkulator korelacji: istotność i porównanie dwóch korelacji
Istotność r, porównanie korelacji niezależnych i zależnych (Steiger, Williams, Meng) z przedziałem Zou oraz korelacja cząstkowa z trzech r.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Zou, G. Y. (2007). Toward using confidence intervals to compare correlations. Psychological Methods, 12(4), 399–413. https://doi.org/10.1037/1082-989x.12.4.399
Cytowania BibTeX
@book{cohen1988statistical, author={Cohen, Jacob}, title={{Statistical power analysis for the behavioral sciences}}, year={1988}, edition={2}, publisher={Lawrence Erlbaum Associates}, url={https://openlibrary.org/books/OL2035961M}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{zou2007toward, author={Zou, Guang Yong}, title={{Toward using confidence intervals to compare correlations}}, journal={Psychological Methods}, year={2007}, volume={12}, number={4}, pages={399--413}, doi={10.1037/1082-989x.12.4.399}}