Co to jest skalowanie Mokkena?
Skalowanie Mokkena (ang. Mokken scale analysis, MSA) to sposób budowy i oceny skali, który przenosi ideę skali Guttmana do świata probabilistycznego. Van Schuur (2003) opisuje je jako model porządkowego, jednowymiarowego pomiaru z rodziny IRT, umieszczony między skalogramem Guttmana a parametrycznymi modelami, takimi jak model Rascha. Model nie zakłada krzywej logistycznej, a jedynie to, że wraz z poziomem cechy rośnie szansa wyższej odpowiedzi.
Dwa modele
- Monotoniczna homogeniczność: pozycje mierzą jedną cechę (jednowymiarowość), a odpowiedzi rosną monotonicznie z jej poziomem. Wtedy suma punktów porządkuje osoby na skali porządkowej.
- Podwójna monotoniczność: dodatkowo krzywe pozycji się nie przecinają, więc kolejność trudności pozycji jest taka sama dla wszystkich osób.
Oba modele obejmują pozycje dychotomiczne i wielokategorialne (van Schuur, 2003). Sijtsma i van der Ark (2017) w samouczku opisują zalecaną procedurę i częste błędy w stosowaniu MSA.
Współczynnik H Loevingera
Dla pary pozycji H to kowariancja odpowiedzi podzielona przez największą kowariancję możliwą przy tych samych odsetkach odpowiedzi, czyli przy idealnym wzorcu Guttmana. Podobnie liczy się H dla pozycji (Hj) i dla całej skali. W praktyce przyjmuje się, że H ≥ 0.30 to skala słaba, ≥ 0.40 średnia, a ≥ 0.50 silna. Procedura doboru pozycji odrzuca te z Hj poniżej progu, podobnie jak analiza pozycji testu odrzuca pozycje o słabej mocy różnicującej.
Przykład
300 symulowanych osób odpowiedziało na 5 pozycji o rosnącej trudności (odsetki „tak” od 0.87 do 0.15) i jedną pozycję losową. Dla sześciu pozycji H = 0.31, a pozycja losowa miała Hj = −0.02. Po jej usunięciu H = 0.58, czyli skala silna.
Na rysunku
Oba rysunki powstały z danych z przykładu: 300 osób, pięć pozycji o rosnącej trudności i jedna pozycja losowa (set.seed(54701)).
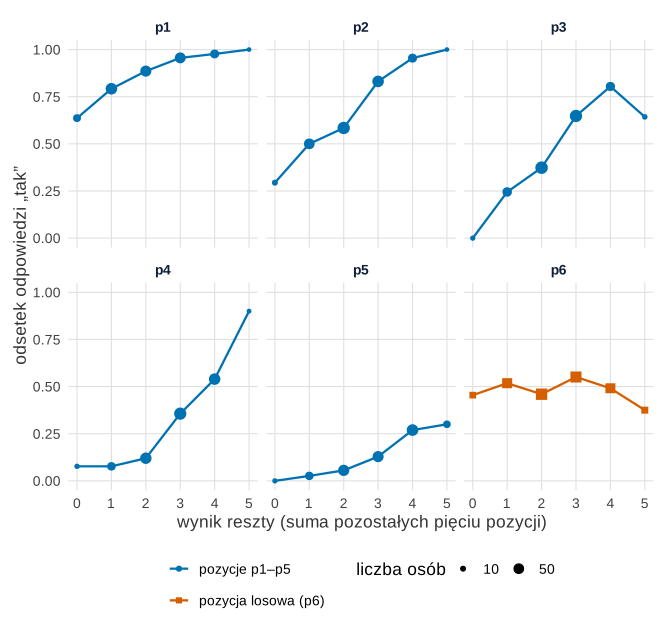
Co widać. Wynik reszty to suma pozostałych pięciu pozycji – zastępuje nieobserwowany poziom cechy. Model monotonicznej homogeniczności wymaga, by odsetek „tak” rósł razem z nim. Tak jest w pozycjach p1–p5, np. w p4 od .08 do .90. Pozycja losowa p6 daje linię płaską (.38–.55): odpowiedź nie zależy od reszty skali.
Na co uważać. Spadek w p3 z .80 do .64 przy wyniku reszty 5 dotyczy tylko 14 osób, a do reszty wlicza się tu pozycja losowa. Takie drobne odchylenia zwykle są przypadkowe; dlatego funkcja check.monotonicity() z pakietu mokken łączy małe grupy i testuje tylko spadki większe od ustalonego minimum. Wykres nie sprawdza też, czy krzywe pozycji się przecinają – to pytanie o podwójną monotoniczność.
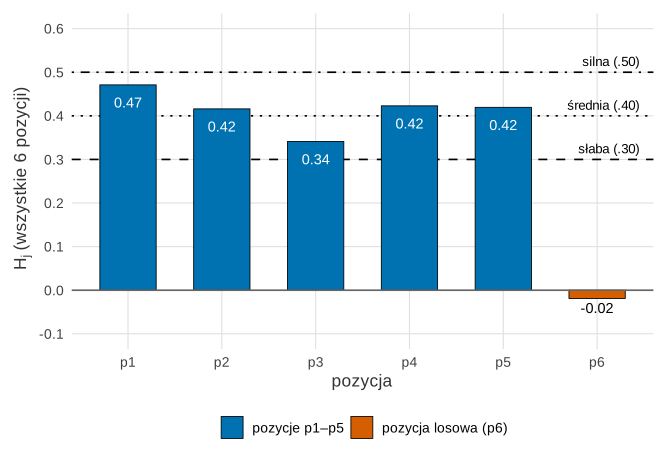
Co widać. Wszystkie pozycje p1–p5 przekraczają próg .30 (Hj od .34 do .47), a p6 leży przy zerze (−.02) – to ją procedura doboru odrzuca jako pierwszą.
Na co uważać. Hj zależy od pozostałych pozycji w zestawie: tę samą pozycję ocenia się względem innych, a po usunięciu p6 H całej skali wzrasta z 0.31 do 0.58. Słupki nie pokazują błędu standardowego; w małej próbie pozycja tuż nad progiem może równie dobrze leżeć pod nim.
Kod poniżej odtwarza dane z przykładu i oba wykresy; Hj liczy ręcznie, więc wymaga tylko pakietu ggplot2. Rysunki na stronie różnią się od wyniku kodu tylko motywem (czcionka, siatka).
Kod R rysunków 1 i 2
library(ggplot2)
kol <- c(skala = "#0072B2", poza = "#D55E00")                       # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(legend.position = "bottom", panel.grid.minor = element_blank())
set.seed(54701)                                                      # te same dane co w przykładzie
n <- 300
theta <- rnorm(n)
b <- c(-1.5, -0.5, 0, 0.7, 1.5)
X <- sapply(b, function(bj) rbinom(n, 1, plogis(1.7 * (theta - bj))))
X <- cbind(X, rbinom(n, 1, 0.5))                                     # pozycja 6: losowa
colnames(X) <- paste0("p", 1:6)
# Rysunek 1: odsetek „tak” w funkcji wyniku reszty (suma pozostałych 5 pozycji)
reszta <- do.call(rbind, lapply(colnames(X), function(j) {
  r <- rowSums(X[, colnames(X) != j])
  data.frame(pozycja = j, reszta = sort(unique(r)), n = as.vector(table(r)),
             odsetek = as.vector(tapply(X[, j], r, mean)))
}))
reszta$w_skali <- ifelse(reszta$pozycja == "p6", "pozycja losowa (p6)", "pozycje p1–p5")
print(xtabs(round(odsetek, 2) ~ pozycja + reszta, reszta)); print(xtabs(n ~ pozycja + reszta, reszta))
p1 <- ggplot(reszta, aes(reszta, odsetek, colour = w_skali, shape = w_skali)) +
  geom_line(linewidth = 0.8) + geom_point(aes(size = n)) +
  facet_wrap(~ pozycja, ncol = 3) +
  scale_colour_manual(values = c("pozycje p1–p5" = kol[["skala"]], "pozycja losowa (p6)" = kol[["poza"]]),
                      breaks = c("pozycje p1–p5", "pozycja losowa (p6)"), name = NULL) +
  scale_shape_manual(values = c("pozycje p1–p5" = 16, "pozycja losowa (p6)" = 15),
                     breaks = c("pozycje p1–p5", "pozycja losowa (p6)"), name = NULL) +
  scale_size_area(max_size = 4, breaks = c(10, 50, 100), name = "liczba osób") +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.25)) +
  labs(x = "wynik reszty (suma pozostałych pięciu pozycji)", y = "odsetek odpowiedzi „tak”") +
  guides(colour = guide_legend(order = 1, ncol = 1), shape = guide_legend(order = 1, ncol = 1)) + motyw
# Rysunek 2: współczynniki H_j z progami .30, .40 i .50
H_loevingera <- function(X) {
  p <- colMeans(X)
  C <- cov(X) * (nrow(X) - 1) / nrow(X)
  Cmax <- outer(p, p, function(a, b) pmin(a, b) * (1 - pmax(a, b)))
  diag(C) <- 0; diag(Cmax) <- 0
  list(H = sum(C) / sum(Cmax), Hj = rowSums(C) / rowSums(Cmax))
}
hj <- data.frame(pozycja = colnames(X), Hj = H_loevingera(X)$Hj)
hj$w_skali <- ifelse(hj$pozycja == "p6", "pozycja losowa (p6)", "pozycje p1–p5")
round(setNames(hj$Hj, hj$pozycja), 2)
p2 <- ggplot(hj, aes(pozycja, Hj, fill = w_skali)) +
  geom_hline(yintercept = c(0.3, 0.4, 0.5), linetype = c("dashed", "dotted", "dotdash")) +
  geom_col(width = 0.6, colour = "black", linewidth = 0.3) +
  geom_hline(yintercept = 0, colour = "grey40") +
  annotate("text", x = 6.45, y = c(0.3, 0.4, 0.5) + 0.025, hjust = 1, size = 3.5,
           label = c("słaba (.30)", "średnia (.40)", "silna (.50)")) +
  geom_text(aes(label = sprintf("%.2f", Hj), vjust = ifelse(Hj < 0, 1.4, 2.2),
                colour = Hj > 0), size = 3.8, show.legend = FALSE) +
  scale_colour_manual(values = c("TRUE" = "white", "FALSE" = "black")) +
  scale_fill_manual(values = c("pozycje p1–p5" = kol[["skala"]], "pozycja losowa (p6)" = kol[["poza"]]),
                    breaks = c("pozycje p1–p5", "pozycja losowa (p6)"), name = NULL) +
  scale_y_continuous(limits = c(-0.1, 0.6), breaks = seq(-0.1, 0.6, 0.1)) +
  labs(x = "pozycja", y = expression(H[j]~"(wszystkie 6 pozycji)")) + motyw
# print(p1); print(p2)   # albo: ggsave("rysunek-1.svg", p1, width = 7, height = 6.4)
Wynik w R
       reszta
pozycja    0    1    2    3    4    5
     p1 0.64 0.79 0.89 0.96 0.98 1.00
     p2 0.29 0.50 0.58 0.83 0.95 1.00
     p3 0.00 0.24 0.37 0.65 0.80 0.64
     p4 0.08 0.08 0.12 0.36 0.54 0.90
     p5 0.00 0.03 0.06 0.13 0.27 0.30
     p6 0.45 0.52 0.46 0.55 0.49 0.38
       reszta
pozycja  0  1  2  3  4  5
     p1 33 77 70 68 43  9
     p2 17 64 89 77 44  9
     p3 12 49 91 88 46 14
     p4 13 39 75 87 76 10
     p5 12 38 72 70 78 30
     p6 22 56 74 69 55 24
   p1    p2    p3    p4    p5    p6
 0.47  0.42  0.34  0.42  0.42 -0.02
Jak opisać w pracy
Skalowanie Mokkena w R
Kod liczy współczynniki H Loevingera ręcznie: kowariancje par pozycji dzieli przez kowariancje maksymalne przy tych samych odsetkach odpowiedzi. Funkcja mokken::coefH() daje ten sam wynik co obliczenie ręczne (H = 0.31 i 0.58), a aisp() pozostawia w skali pozycje 1–5.
H dla skali i dla pozycji
R
# Współczynniki H Loevingera ręcznie dla pozycji 0/1 (dane symulowane)
set.seed(54701)
n <- 300
theta <- rnorm(n)
b <- c(-1.5, -0.5, 0, 0.7, 1.5)            # trudności pięciu pozycji
X <- sapply(b, function(bj) rbinom(n, 1, plogis(1.7 * (theta - bj))))
X <- cbind(X, rbinom(n, 1, 0.5))           # pozycja 6: losowa, niezwiązana z cechą
colnames(X) <- paste0("p", 1:6)
H_loevingera <- function(X) {
  p <- colMeans(X); k <- ncol(X)
  C <- cov(X) * (nrow(X) - 1) / nrow(X)    # kowariancje (mianownik n)
  Cmax <- outer(p, p, function(a, b) pmin(a, b) * (1 - pmax(a, b)))
  diag(C) <- 0; diag(Cmax) <- 0
  list(H = sum(C) / sum(Cmax), Hj = rowSums(C) / rowSums(Cmax))
}
w6 <- H_loevingera(X)
w5 <- H_loevingera(X[, 1:5])
round(colMeans(X), 2)
round(c(H_6_pozycji = w6$H, H_5_pozycji = w5$H), 2)
round(w6$Hj, 2)
# To samo z pakietem mokken: H skali, Hj pozycji i automatyczny dobór pozycji (próg 0.3)
library(mokken)
h6 <- coefH(X, se = FALSE, results = FALSE); h5 <- coefH(X[, 1:5], se = FALSE, results = FALSE)
round(c(H_6_pozycji = h6$H, H_5_pozycji = h5$H), 2)
round(h6$Hi, 2)
t(aisp(X))   # 1 = pozycja w skali, 0 = poza skalą
Wynik w R
  p1   p2   p3   p4   p5   p6
0.87 0.68 0.50 0.31 0.15 0.49
H_6_pozycji H_5_pozycji
       0.31        0.58
   p1    p2    p3    p4    p5    p6
 0.47  0.42  0.34  0.42  0.42 -0.02
H_6_pozycji H_5_pozycji
       0.31        0.58
   p1    p2    p3    p4    p5    p6
 0.47  0.42  0.34  0.42  0.42 -0.02
    p1 p2 p3 p4 p5 p6
0.3  1  1  1  1  1  0
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem mokken 3.1.2; Rysunki 1 i 2 wykonano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mokken (wersja 3.1.2): van der Ark, L. A., & Koopman, L. (2024). mokken: Conducts Mokken scale analysis (R package version 3.1.2) [Computer software]. https://doi.org/10.32614/CRAN.package.mokken
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czym skalowanie Mokkena różni się od skali Guttmana?
Skala Guttmana jest deterministyczna: każde odstępstwo od idealnego wzorca to błąd. Model Mokkena jest probabilistyczny, więc dopuszcza przypadkowe odstępstwa, a jakość skali ocenia stopniem, nie zero-jedynkowo.
Jakie H Loevingera jest wystarczające?
W praktyce przyjmuje się, że H ≥ 0.30 oznacza skalę słabą, ≥ 0.40 średnią, a ≥ 0.50 silną. Pozycje z H poniżej 0.30 zwykle się usuwa. To umowne progi, nie test istotności.
Czy skalowanie Mokkena działa dla pozycji Likerta?
Tak. Modele Mokkena obejmują pozycje dychotomiczne i wielokategorialne. W R analizę wykonuje pakiet mokken (van der Ark, 2007), m.in. funkcje coefH() i aisp().
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Sijtsma, K., & van der Ark, L. A. (2017). A tutorial on how to do a Mokken scale analysis on your test and questionnaire data. British Journal of Mathematical and Statistical Psychology, 70(1), 137–158. https://doi.org/10.1111/bmsp.12078 ● Otwarty dostęp
- van der Ark, L. A. (2007). Mokken scale analysis in R. Journal of Statistical Software, 20(11). https://doi.org/10.18637/jss.v020.i11 ● Otwarty dostęp
- van Schuur, W. H. (2003). Mokken scale analysis: Between the Guttman scale and parametric item response theory. Political Analysis, 11(2), 139–163. https://doi.org/10.1093/pan/mpg002 ● Otwarty dostęp
Cytowania BibTeX
@article{sijtsma2017tutorial, author={Sijtsma, Klaas and van der Ark, L. Andries}, title={{A tutorial on how to do a Mokken scale analysis on your test and questionnaire data}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2017}, volume={70}, number={1}, pages={137--158}, doi={10.1111/bmsp.12078}}@article{vanderark2007mokken, author={van der Ark, L. Andries}, title={{Mokken scale analysis in R}}, journal={Journal of Statistical Software}, year={2007}, volume={20}, number={11}, doi={10.18637/jss.v020.i11}}@article{vanschuur2003mokken, author={van Schuur, Wijbrandt H.}, title={{Mokken scale analysis: Between the Guttman scale and parametric item response theory}}, journal={Political Analysis}, year={2003}, volume={11}, number={2}, pages={139--163}, doi={10.1093/pan/mpg002}}