Co to jest regresja izotoniczna?
Regresja izotoniczna (ang. isotonic regression) dopasowuje do danych funkcję niemalejącą (lub nierosnącą) o najmniejszej sumie kwadratów odchyleń. Nie zakłada prostej, krzywej ani liczby parametrów – tylko kierunek zależności. Wynikiem jest funkcja schodkowa. Przydaje się, gdy teoria mówi „im więcej, tym nie mniej”, a kształt jest nieznany: zależność dawka–odpowiedź, wzrost umiejętności z wiekiem, a także kalibracja przewidywanych prawdopodobieństw.
Jak działa algorytm PAVA
Standardowym algorytmem jest PAVA (pool-adjacent-violators). Ayer i in. (1955) pokazali go dla uporządkowanych prawdopodobieństw: gdy sąsiednie wartości łamią porządek, łączy się je w jedną średnią (ważoną liczebnościami) i powtarza krok aż do uzyskania ciągu monotonicznego; wynik jest estymatorem największej wiarygodności. Przy zwykłej metodzie najmniejszych kwadratów działa tak samo. De Leeuw, Hornik i Mair (2009) uogólnili PAVA na inne funkcje straty, wagi i wiązania. W bazowym R służy do tego isoreg().
Przykład
Dla ciągu 1, 3, 2, 4, 3, 5 pary (3, 2) i (4, 3) łamią porządek, więc PAVA zastępuje je średnimi: 1, 2.5, 2.5, 3.5, 3.5, 5. W danych symulowanych (200 obserwacji, zależność rosnąca w kształcie S) funkcja izotoniczna ma 26 schodków i sumę kwadratów reszt 160.3 wobec 354.2 dla regresji liniowej. To porównanie na tych samych danych jest jednak zbyt optymistyczne.
Na rysunku
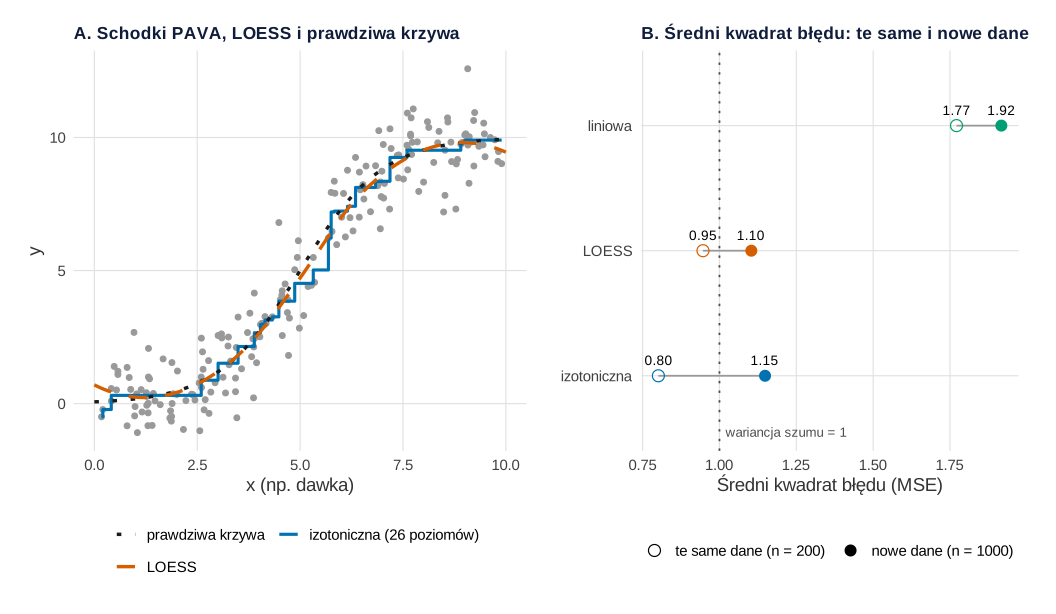
set.seed(641) i set.seed(6410)).Co widać. Panel A to te same 200 obserwacji co w przykładzie niżej. Schodki PAVA (26 poziomów) i LOESS biegną blisko prawdziwej krzywej, choć regresja izotoniczna nie wie nic o jej kształcie – zna tylko kierunek. Schodki są jednak poszarpane: każdy skok to miejsce, w którym kilka punktów leżało wyżej niż poprzednie. Panel B wyjaśnia, dlaczego porównanie sum kwadratów z przykładu jest zbyt optymistyczne. Na tych samych danych średni kwadrat błędu regresji izotonicznej wynosi 0.80, czyli mniej niż wariancja szumu (1): schodki dopasowały część szumu. Na 1000 nowych obserwacjach z tego samego modelu rośnie do 1.15. LOESS traci mniej (z 0.95 do 1.10), a prosta zostaje daleko z tyłu (1.77 i 1.92), bo nie oddaje kształtu S.
Na co uważać. Różnica między 1.15 a 1.10 na nowych danych jest mała i przy innym losowaniu może się odwrócić; wyraźna jest tylko przewaga obu metod nad prostą. Wykres nie pokazuje niepewności schodków. Najmniej pewne są poziomy oparte na pojedynczych punktach, zwykle na krańcach zakresu – jak skoki przy najniższych x w panelu A. LOESS ma tu domyślną szerokość okna (span = 0.75); przy węższym oknie też dopasowałby się do szumu. Inne gładkie dopasowania (splajny, GAM) pokazuje wpis nieliniowe zależności: splajny i GAM.
Podpis do pracy:
Dane do dopasowania to te same obserwacje co w przykładzie niżej (set.seed(641)). Nowe dane losuje osobny blok z ziarnem set.seed(6410); oba ziarna ustalono raz. Liczbę 1000 nowych obserwacji dobrano ręcznie, żeby błąd na nowych danych był stabilny. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Regresja izotoniczna (schodki) vs LOESS i prawdziwa krzywa (A)
# oraz błąd dopasowania na tych samych danych i na nowych danych (B)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c(izo = "#0072B2", loess = "#D55E00", lin = "#009E73")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

prawdziwa <- function(x) 10 / (1 + exp(-(x - 5)))   # prawdziwa zależność (kształt S)
set.seed(641)                                       # te same dane co w przykładzie niżej
n <- 200
x <- runif(n, 0, 10)
y2 <- prawdziwa(x) + rnorm(n)
fit <- isoreg(x, y2)
f_izo <- as.stepfun(fit)                            # funkcja schodkowa do przewidywania
lin <- lm(y2 ~ x)
lo <- loess(y2 ~ x, span = 0.75, control = loess.control(surface = "direct"))  # domyślna szerokość okna

set.seed(6410)                                      # nowe dane z tego samego modelu (osobne ziarno)
x_n <- runif(1000, 0, 10)
y_n <- prawdziwa(x_n) + rnorm(1000)

mse <- function(y, p) mean((y - p)^2)
bledy <- rbind(
  te_same = c(izotoniczna = mse(y2, f_izo(x)), LOESS = mse(y2, fitted(lo)), liniowa = mse(y2, fitted(lin))),
  nowe    = c(izotoniczna = mse(y_n, f_izo(x_n)), LOESS = mse(y_n, predict(lo, data.frame(x = x_n))),
              liniowa = mse(y_n, predict(lin, data.frame(x = x_n)))))
round(bledy, 2)                                     # wariancja szumu = 1, więc to dolna granica dla nowych danych

siatka <- seq(0, 10, length.out = 400)
poz <- sprintf("izotoniczna (%d poziomów)", length(unique(fit$yf)))
etyk <- c("prawdziwa krzywa", "LOESS", poz)
krzywe <- data.frame(x = rep(siatka, 2), y = c(prawdziwa(siatka), predict(lo, data.frame(x = siatka))),
                     co = factor(rep(etyk[1:2], each = 400), levels = etyk))
schodki <- data.frame(x = fit$x[fit$ord], y = fit$yf, co = factor(poz, levels = etyk))
pA <- ggplot(data.frame(x, y2), aes(x, y2)) +
  geom_point(size = 1.6, colour = "grey60") +
  geom_step(data = schodki, aes(x, y, colour = co, linetype = co), linewidth = 1.1) +
  geom_line(data = krzywe, aes(x, y, colour = co, linetype = co), linewidth = 1.2) +
  scale_colour_manual(values = setNames(c("grey10", kol[["loess"]], kol[["izo"]]), etyk), name = NULL, drop = FALSE) +
  scale_linetype_manual(values = setNames(c("dotted", "dashed", "solid"), etyk), name = NULL, drop = FALSE) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(title = "A. Schodki PAVA, LOESS i prawdziwa krzywa", x = "x (np. dawka)", y = "y") + motyw

dB <- data.frame(model = factor(rep(colnames(bledy), each = 2), levels = colnames(bledy)),
                 dane = factor(rep(c("te same dane (n = 200)", "nowe dane (n = 1000)"), 3),
                               levels = c("te same dane (n = 200)", "nowe dane (n = 1000)")),
                 mse = c(bledy))
pB <- ggplot(dB, aes(mse, model, shape = dane)) +
  geom_vline(xintercept = 1, colour = "grey30", linetype = "dotted") +
  geom_line(aes(group = model), colour = "grey60") +
  geom_point(aes(colour = model), size = 3.8) +
  geom_text(aes(label = sprintf("%.2f", mse)), vjust = -1.1, size = 3.6) +
  annotate("text", x = 1.02, y = 0.55, label = "wariancja szumu = 1", hjust = 0, size = 3.5, colour = "grey30") +
  scale_colour_manual(values = unname(kol), guide = "none") +
  scale_shape_manual(values = c(1, 16), name = NULL) +
  labs(title = "B. Średni kwadrat błędu: te same i nowe dane", x = "Średni kwadrat błędu (MSE)", y = NULL) + motyw

p1 <- pA + pB + plot_layout(widths = c(1.2, 1))
p1
Wynik w R
        izotoniczna LOESS liniowa
te_same        0.80  0.95    1.77
nowe           1.15  1.10    1.92
Jak opisać w pracy
Na co uważać
- Funkcja schodkowa łatwo dopasowuje się do szumu na krańcach zakresu, co grozi przeuczeniem. Jakość predykcji oceniaj na nowych danych.
- Kierunek monotoniczności zakłada się z góry, a nie wybiera po obejrzeniu wyników. Do sprawdzania samego trendu między grupami służy test Jonckheere’a–Terpstry.
- Gładką zależność lepiej opisuje LOESS albo splajny.
- Niculescu-Mizil i Caruana (2005) porównali regresję izotoniczną ze skalowaniem Platta jako metody poprawiania kalibracji prawdopodobieństw z modeli uczenia maszynowego i sprawdzali, ile danych każda z nich potrzebuje.
Regresja izotoniczna w R
Kod pokazuje działanie PAVA na sześciu liczbach, a potem dopasowuje regresję izotoniczną funkcją isoreg() do danych symulowanych i porównuje ją z regresją liniową.
PAVA i isoreg() w bazowym R
R
# Regresja izotoniczna: algorytm PAVA w isoreg() (bazowy R) – mały przykład i dane symulowane
y <- c(1, 3, 2, 4, 3, 5)
ir <- isoreg(1:6, y)
rbind(y = y, dopasowanie = ir$yf)          # pary łamiące monotoniczność zastąpione średnią
set.seed(641)
n <- 200
x <- runif(n, 0, 10)
y2 <- 10 / (1 + exp(-(x - 5))) + rnorm(n)  # zależność rosnąca, ale nieliniowa (kształt S)
fit <- isoreg(x, y2)
yf <- numeric(n); yf[fit$ord] <- fit$yf    # dopasowanie w kolejności oryginalnych danych
lin <- lm(y2 ~ x)
round(c(SSE_izotoniczna = sum((y2 - yf)^2), SSE_liniowa = sum(resid(lin)^2),
        liczba_schodkow = length(unique(fit$yf))), 1)
round(c(min = min(fit$yf), max = max(fit$yf)), 2)
Wynik w R
            [,1] [,2] [,3] [,4] [,5] [,6]
y              1  3.0  2.0  4.0  3.0    5
dopasowanie    1  2.5  2.5  3.5  3.5    5
SSE_izotoniczna     SSE_liniowa liczba_schodkow
          160.3           354.2            26.0
 min  max
-0.5  9.9
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym regresja izotoniczna różni się od regresji liniowej?
Regresja liniowa zakłada prostą o stałym nachyleniu. Regresja izotoniczna zakłada tylko, że funkcja nie maleje, więc może mieć dowolny kształt schodkowy – za cenę większej liczby efektywnych parametrów i ryzyka przeuczenia.
Jak działa algorytm PAVA?
PAVA przegląda uporządkowane dane i każdą parę sąsiednich wartości łamiących porządek zastępuje ich średnią ważoną. Powtarza to, aż ciąg stanie się monotoniczny. Uzyskana funkcja ma najmniejszą sumę kwadratów spośród funkcji monotonicznych.
Do czego służy kalibracja izotoniczna?
Przekształca wyniki modelu klasyfikacyjnego w prawdopodobieństwa zgodne z obserwowanymi częstościami, zachowując kolejność przypadków. Funkcję kalibracyjną szacuje się na osobnych danych, nie na tych, na których uczono model.
Powiązane hasła
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Ayer, M., Brunk, H. D., Ewing, G. M., Reid, W. T., & Silverman, E. (1955). An empirical distribution function for sampling with incomplete information. The Annals of Mathematical Statistics, 26(4), 641–647. https://doi.org/10.1214/aoms/1177728423 ● Otwarty dostęp
- de Leeuw, J., Hornik, K., & Mair, P. (2009). Isotone optimization in R: Pool-adjacent-violators algorithm (PAVA) and active set methods. Journal of Statistical Software, 32(5). https://doi.org/10.18637/jss.v032.i05 ● Otwarty dostęp
- Niculescu-Mizil, A., & Caruana, R. (2005). Predicting good probabilities with supervised learning. In Proceedings of the 22nd International Conference on Machine Learning (ICML '05) (pp. 625–632). ACM Press. https://doi.org/10.1145/1102351.1102430
Cytowania BibTeX
@article{ayer1955empirical, author={Ayer, Miriam and Brunk, H. D. and Ewing, G. M. and Reid, W. T. and Silverman, Edward}, title={{An empirical distribution function for sampling with incomplete information}}, journal={The Annals of Mathematical Statistics}, year={1955}, volume={26}, number={4}, pages={641--647}, doi={10.1214/aoms/1177728423}}@article{deleeuw2009isotone, author={de Leeuw, Jan and Hornik, Kurt and Mair, Patrick}, title={{Isotone optimization in R: Pool-adjacent-violators algorithm (PAVA) and active set methods}}, journal={Journal of Statistical Software}, year={2009}, volume={32}, number={5}, doi={10.18637/jss.v032.i05}}@inproceedings{niculescumizil2005predicting, author={Niculescu-Mizil, Alexandru and Caruana, Rich}, title={{Predicting good probabilities with supervised learning}}, booktitle={Proceedings of the 22nd International Conference on Machine Learning (ICML '05)}, year={2005}, pages={625--632}, publisher={ACM Press}, doi={10.1145/1102351.1102430}}